
计算机网络 / 系统课时
先设计服务的连接和事件拓扑
先设计服务的连接和事件拓扑
高性能网络服务先要解决“谁拥有连接、谁处理事件、谁执行耗时业务”这三个问题。拓扑设计清楚后,线程之间的共享状态、队列方向、背压边界和故障回收才有确定落点,也更容易用指标验证。
学习目标
- 设计监听器、I/O 线程、业务线程、连接对象和任务队列的职责边界
- 用单线程拥有连接的方式减少锁竞争和跨线程状态修改
- 在拓扑阶段预先确定背压、超时和容量指标的落点
从负载约束反推拓扑
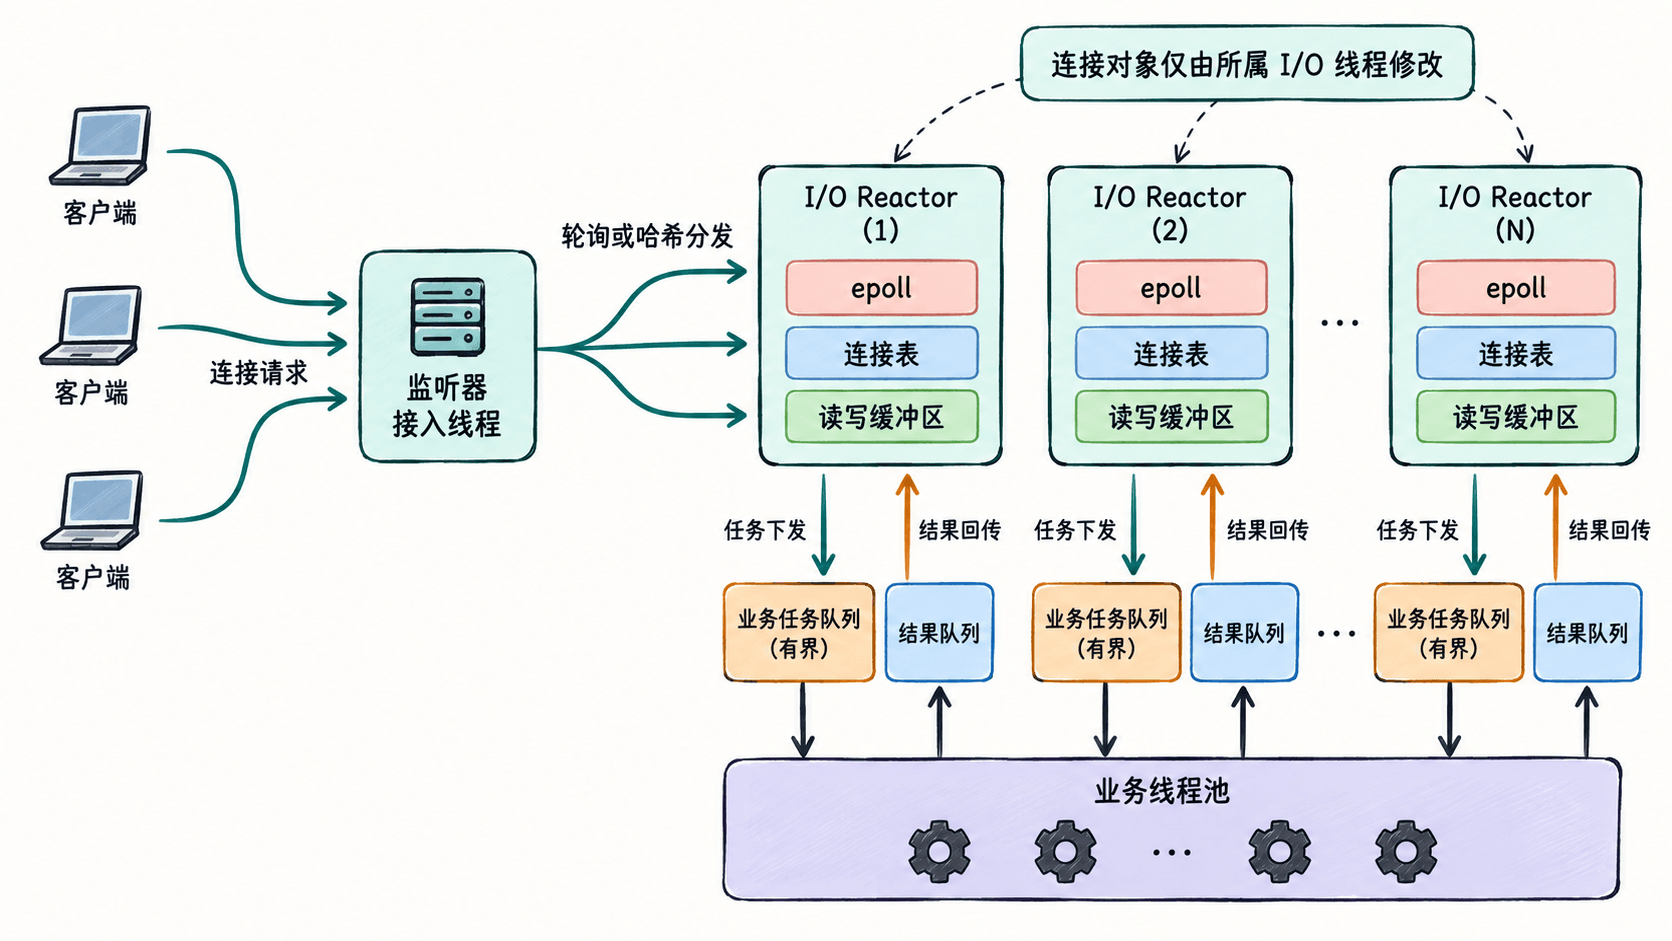
不要先决定“开几个线程”,而要先写出连接规模、单连接消息速率、业务处理是否阻塞以及目标延迟。一个常用起点是:1 个接入线程负责 accept,N 个 I/O Reactor 负责 epoll_wait、收发和连接状态,M 个业务线程只处理不应阻塞 I/O 循环的任务。
每条连接只归属一个 I/O 线程。业务线程不直接调用该连接的 recv、send 或 epoll_ctl,而是通过有界任务队列接收工作,再把结果投递回原 I/O 线程。这样连接状态和缓冲区不需要在多个线程间同时加锁。
把所有权和队列方向写清
连接对象至少要保存文件描述符、输入/输出缓冲区、最近活动时间、读写兴趣和关闭状态。接入线程接受新连接后,只把文件描述符投递到目标 Reactor 的“新连接队列”;目标 Reactor 自己执行 epoll_ctl(ADD),随后负责该连接直到关闭。
业务任务队列和结果队列都应有容量上限。跨线程投递后,如果目标 Reactor 可能正阻塞在 epoll_wait,可以配合 eventfd 唤醒;不要让工作线程直接修改 Reactor 的连接表。下面的配置不是生产默认值,而是一份可以进入评审和压测的拓扑草案。
{
  "acceptorThreads": 1,
  "ioThreads": 4,
  "businessThreads": 8,
  "newConnectionQueueCapacity": 4096,
  "businessQueueCapacity": 8192,
  "resultQueueCapacity": 8192,
  "connectionOwnership": "single-io-thread"
}
把内容保存为 topology.json 后,可先做最基本的结构校验。
python3 -m json.tool topology.json >/dev/null && echo "topology.json OK"预期输出
topology.json OK这一步只验证 JSON 合法;线程数和队列容量是否合适,必须由后续压测数据决定。
把背压和超时放进拓扑
背压不能等到编码时再临时补。业务队列满时,I/O 线程要有明确策略,例如暂停继续读取、快速失败或按协议返回过载;单连接待发送字节超过高水位时,应暂时取消该连接的 EPOLLIN,降到低水位后再恢复,避免慢客户端把进程内存拖垮。
超时和回收也应由连接所有者执行。I/O Reactor 维护空闲时间,超时后完成 epoll_ctl(DEL)、关闭文件描述符并释放缓冲区;如果业务结果晚于连接关闭返回,还需要用连接 ID 或代次号识别陈旧结果,防止把结果写到已经复用的文件描述符上。
用指标证明拓扑没有隐藏瓶颈
压测时至少同时观察当前连接数、每轮 epoll_wait 返回事件数、I/O 循环延迟、各队列深度与丢弃次数、单连接待发送字节以及业务处理延迟。只看总 QPS 很容易把队列堆积误判成“吞吐正常”。
可以固定请求模型,分别用 1、2、4 个 I/O Reactor 做基线,比较吞吐、P99 延迟、CPU 利用率和队列峰值。线程增加后吞吐不升、循环延迟反而变差,通常说明瓶颈已经转移到共享队列、业务线程、内存分配或网卡,而不是继续增加 I/O 线程就能解决。