
计算机网络 / 系统课时
阻塞、非阻塞和多路复用差在哪
阻塞、非阻塞和多路复用差在哪
面对很多网络连接时,真正决定线程成本的不是“有没有并发”,而是线程在等待 I/O 时是否被占住。本节从调用者视角比较阻塞、非阻塞与 I/O 多路复用,明确等待发生在哪里,以及为什么同样的连接数会对应完全不同的线程数量。
学习目标
- 判断三种模型中线程、文件描述符与内核等待之间的关系。
- 理解阻塞点如何影响线程数量、CPU 消耗与程序结构。
- 能根据连接规模和活跃度选择更合适的等待方式。
等待发生在哪里
一次网络读取通常包含两个阶段:先等数据到达内核缓冲区,再把数据复制给用户态。三种模型处理“等待”的方式不同,核心差异不在 read 这个动作本身,而在调用线程是否需要一直停在某个文件描述符上。
阻塞 I/O 中,线程调用 read 后,如果数据尚未就绪,线程会睡眠,直到该连接可读或发生错误。写法简单,但一个线程同时只能等待当前调用,所以传统“一连接一线程”会让线程数随连接数增长。
非阻塞 I/O 会让 read 立即返回。数据没准备好时,调用者得到“暂时不可读”的结果,再决定稍后重试。线程不再被单个连接睡眠占住,但如果不停轮询大量连接,会把“睡眠等待”变成“CPU 忙等”。
I/O 多路复用则把等待对象从“一个 fd”变成“一组 fd”。线程先让 select、poll 或 epoll_wait 等待任意连接就绪,只有收到就绪通知后,才对对应 fd 执行真正的读写。
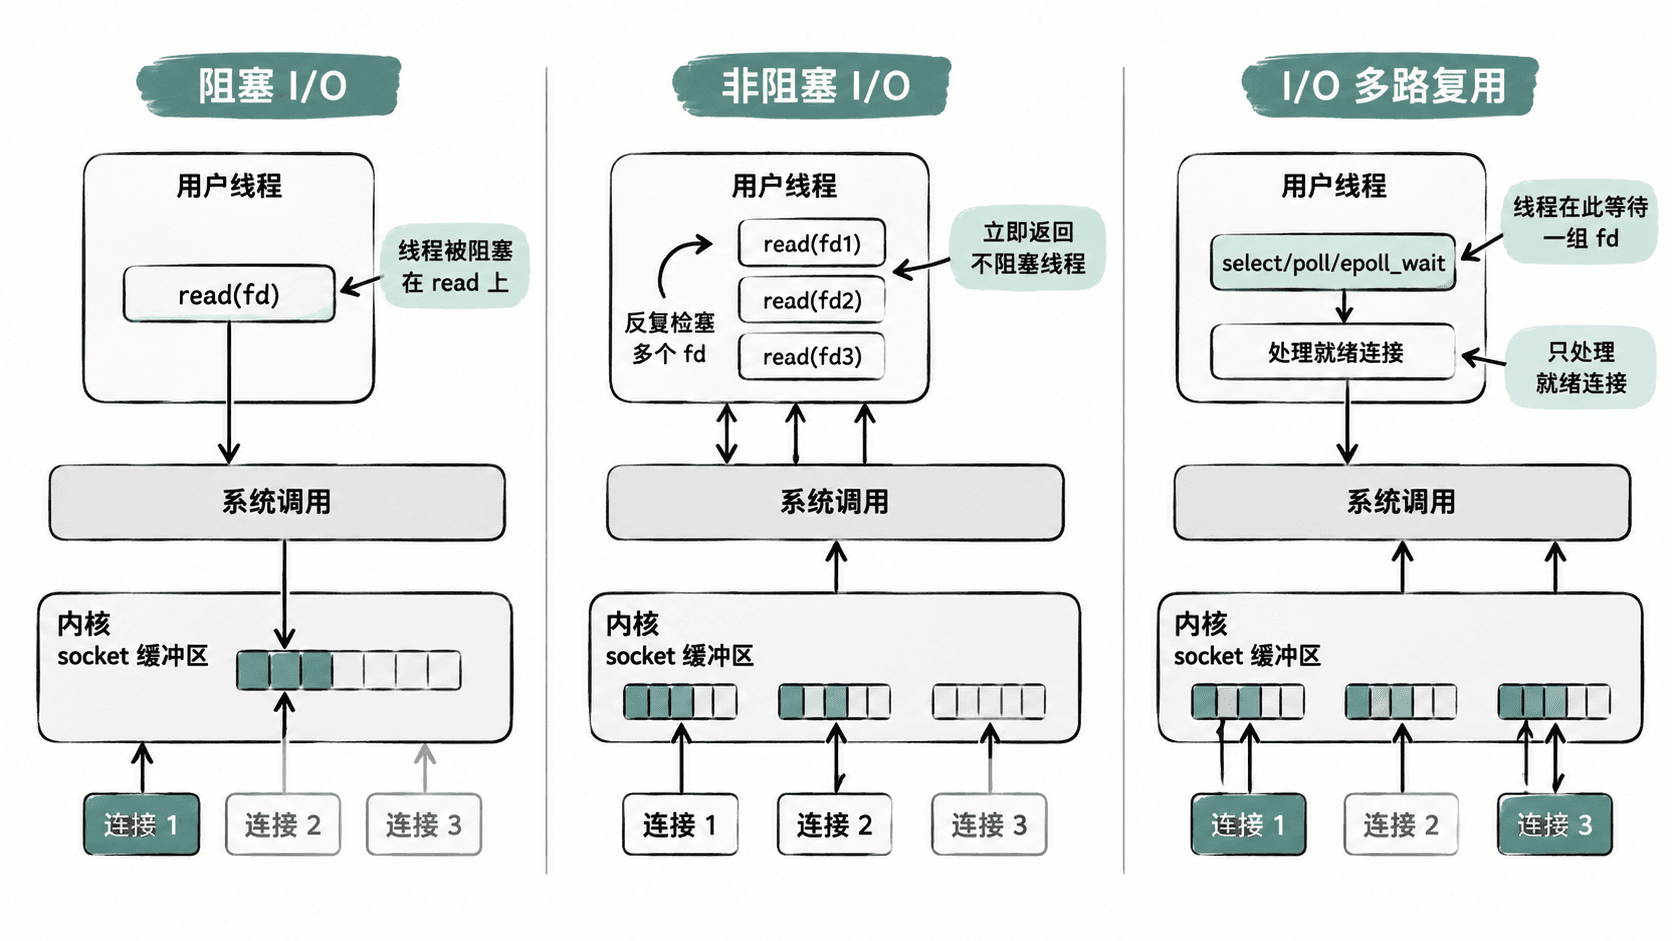
三种模型怎样改变线程成本
阻塞模型最容易理解:如果每个连接都可能长时间空闲,而每个连接又绑定一个线程,那么一万个连接就可能带来大量线程栈、调度实体和上下文切换。现代系统可以承受不少线程,但“连接数约等于线程数”仍会很快放大成本。
非阻塞模型打破了这种绑定。一个线程可以依次检查很多连接,但纯轮询的问题是:大部分连接通常并没有数据。检查动作本身就会消耗 CPU,而且连接越多,无效检查越多。
多路复用进一步把“哪些连接值得检查”交给内核等待机制。应用线程通常只需要少量事件循环线程,就能管理大量连接。此时线程数量更多取决于 CPU 核数、业务处理方式和是否存在阻塞任务,而不再直接等于连接数。
| 模型 | 调用未就绪 fd 时 | 常见线程关系 | 主要代价 |
|---|---|---|---|
| 阻塞 I/O | 线程睡眠等待 | 常见是一连接一线程或线程池 | 线程栈、调度与上下文切换 |
| 非阻塞 I/O | 立即返回,应用重试 | 一个线程可管理多个连接 | 频繁轮询导致 CPU 浪费 |
| I/O 多路复用 | 先等待一组 fd 中任意就绪 | 少量线程管理大量连接 | 事件分发和就绪处理复杂度 |
多路复用并不等于“读取不阻塞”
一个常见误解是:用了 epoll 之后,read 就自动变成了异步调用。实际上,多路复用解决的是“等待谁就绪”的问题;真正的数据读取仍然由应用线程执行。工程上通常把 socket 设置为非阻塞,避免在处理一个就绪事件时因为边界条件再次卡住整个事件循环。
另一个边界是业务逻辑。如果连接已经可读,但随后执行数据库查询、磁盘访问或长时间计算,那么事件循环线程仍会被业务代码占住。高并发网络程序通常把“等待网络事件”和“执行可能阻塞的任务”分开设计。
什么时候选哪一种
连接数量不大、每个请求都很短,或者开发复杂度比极限并发更重要时,阻塞 I/O 配合线程池依然合理。它的控制流直观,错误处理也容易组织。
如果底层 API 必须以非阻塞方式使用,但等待对象很少,主动重试有时可以接受;一旦 fd 数量扩大,持续轮询通常不是好选择。
需要单机维护大量长连接、连接大多处于空闲状态、又希望限制线程数量时,多路复用更合适。选择模型时应观察三个量:同时在线连接数、单位时间活跃连接比例、单次事件处理是否会阻塞。真正影响扩展性的,是这三个量共同决定的等待与调度成本。