
单片机与物联网 / 系统课时
用反汇编辨认 Thumb 指令行为
用反汇编辨认 Thumb 指令行为
面对 Cortex-M 固件中的反汇编代码,你需要判断每条指令对应哪段 C 逻辑。本课使用一个可编译的裸机函数,演示如何从加载、存储、比较、条件分支到函数返回逐步阅读 Thumb 指令,并利用反汇编结果验证判断。
学习目标
- 区分 Thumb 常见的加载、存储、算术、比较和分支指令。
- 将 C 表达式、寄存器变化与反汇编指令对应起来。
- 使用 Arm GNU 工具链生成反汇编,并识别优化及函数返回的差异。
认识 Thumb 指令和寄存器
Cortex-M 使用 Thumb 指令集,指令既有 16 位编码,也有 32 位编码。反汇编工具通常显示对应的助记符;其中 .w 可用于表示或要求宽编码,但没有 .w 不代表一定是 16 位指令。
阅读普通整数函数时,优先认识这些寄存器:
| 寄存器 | 常见职责 | 阅读时关注什么 |
|---|---|---|
| R0~R3 | 前四个参数及临时计算 | R0 通常还保存整数返回值 |
| R4~R11 | 保存型寄存器 | 函数使用后通常需要恢复原值 |
| R12 | 临时寄存器 | 编译器可用于中间计算 |
| SP(R13) | 栈指针 | push、pop 和局部变量空间 |
| LR(R14) | 返回地址 | bl 调用时会更新 LR |
| PC(R15) | 程序计数器 | 分支和返回改变执行位置 |
在常用的 Arm AAPCS 调用约定下,R0~R3 传递前四个整型或指针参数。超过寄存器容量的参数可能通过栈传递,具体仍受参数类型和调用约定影响。
常见指令可按执行效果归类:
| 指令 | 行为 | 示例含义 |
|---|---|---|
movs |
写入寄存器并更新相关条件标志 | movs r0, #0 将 R0 置零 |
ldr |
从内存读取 | ldr r3, [r0] 读取 R0 指向的字 |
str |
向内存写入 | str r2, [r0] 将 R2 写入目标地址 |
adds |
加法并更新条件标志 | adds r0, r0, #1 |
cmp |
比较并更新条件标志 | cmp r0, #10 |
bne |
不相等时分支 | Z 标志为 0 时跳转 |
bx lr |
跳转到 LR 指向的位置 | 常用于函数返回 |
ldr 和 str 的方括号表示内存寻址,不能把 ldr r3, [r0] 误认为复制 R0 的数值。若 R0 是有效的 0x20000000,且该地址起始的四个字节组成小端序数值 0x12345678,那么执行后 R3 为 0x12345678,R0 仍是地址。
编译一个便于观察的裸机函数
以下使用 Arm GNU Toolchain 的 arm-none-eabi-gcc 和 arm-none-eabi-objdump。目标选用 Cortex-M3,指定 Thumb 模式,并关闭优化以便观察内存访问。
创建 thumb_demo.c,只使用普通整数与指针操作,不依赖标准库或芯片厂商 HAL。
#include <stdint.h>

__attribute__((noinline, used))
uint32_t update_counter(volatile uint32_t *counter, uint32_t limit)
{
    // volatile 保留对计数器的实际内存读写。
    uint32_t value = *counter;
    value = value + 1u;

    // 达到阈值后回绕,便于识别比较与分支。
    if (value >= limit) {
        value = 0u;
    }

    *counter = value;
    return value;
}
这里的 volatile 要求编译器保留对所指对象的必要访问,但它不提供跨中断的原子性,也不是线程同步机制。noinline 防止函数被内联,used 告诉 GCC 即使当前编译单元没有直接引用也要生成该函数。
在安装并配置好 Arm GNU Toolchain 的终端执行:
arm-none-eabi-gcc -mcpu=cortex-m3 -mthumb -O0 -c thumb_demo.c -o thumb_demo.o
arm-none-eabi-objdump -d -S thumb_demo.o
预期结果:命令成功时通常没有编译器输出,反汇编会出现 update_counter 符号和对应的 Thumb 指令。实际地址、指令编码以及寄存器分配依 GCC 版本而不同。
反汇编输出中可能看到如下具有代表性的片段:
00000000 <update_counter>:
   ...  push    {r7}
   ...  ldr     r3, [r7, #4]
   ...  adds    r3, #1
   ...  cmp     r2, r3
   ...  bcs     ...
   ...  movs    r3, #0
   ...  str     r3, [r2, #0]
... bx lr上面是用于辨认指令类型的节选示意,并非声称本机必然生成的完整输出;寄存器、比较操作数顺序和分支条件都必须以实际反汇编为准。-S 在目标文件含可用调试信息时才能更完整地交错显示源代码;如需源代码行号,可以在编译命令中增加 -g。
顺着数据流辨认加载和存储
将函数中的 value = *counter 拆开观察。假设进入函数时 R0 存放 counter 地址,R1 存放 limit,常见的直接内存访问形式是:
ldr r3, [r0]
adds r3, r3, #1
str r3, [r0]
这是片段示例,假设 R0 指向可读写且按四字节对齐的 32 位计数器,且暂时忽略阈值判断。
ldr从 R0 指向的地址读取 32 位值到 R3。adds把 R3 增加 1,并更新条件标志。str把新的 R3 写回 R0 指向的内存。
如果初始内存值是 7,三条指令执行后 R3 为 8,计数器内存值也为 8。若只有 ldr 与 adds,而没有后续写回,内存中的计数器仍为 7。
未经优化的实际代码可能先把参数保存到栈上,再从栈槽加载到 R2 或 R3,因此要顺着基址寄存器追踪地址,不应假设每一次内存访问都直接使用 R0。
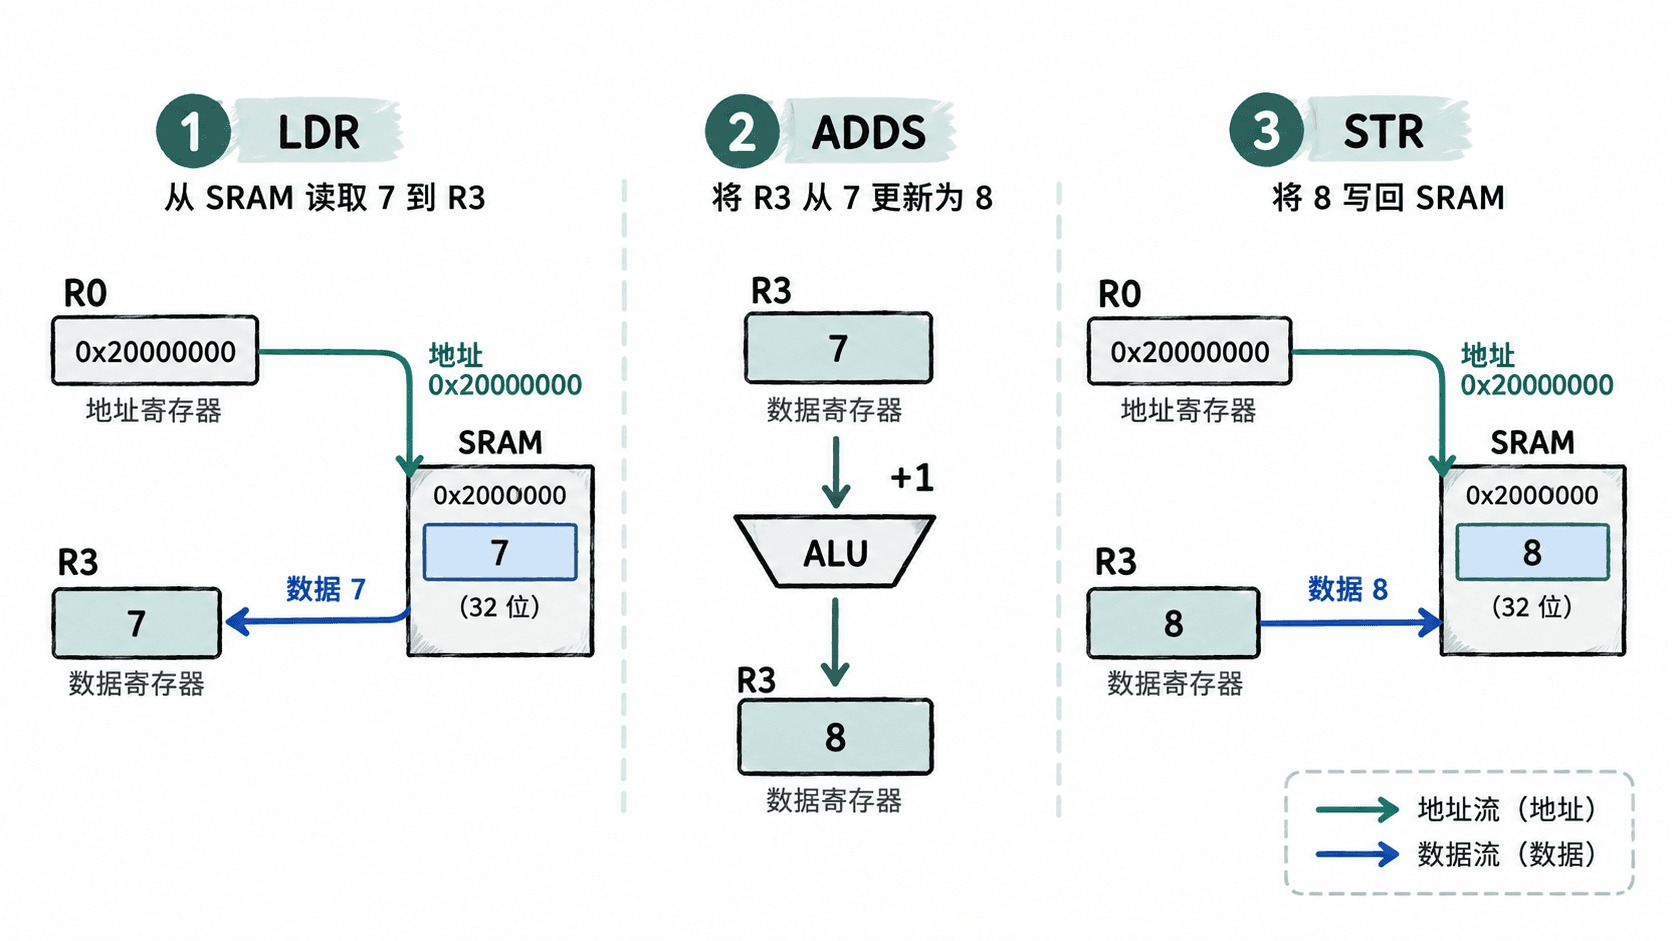
读懂比较、条件分支与标志位
Thumb 的 cmp 本质上执行不保存结果的减法,并更新 APSR 中的 N、Z、C、V 条件标志。随后条件分支读取这些标志决定是否跳转。
对于无符号整数,value >= limit 可以使用条件码 cs 或 hs(同义,C=1),但实际编译器也可能通过交换比较操作数、取反条件来实现同一个判断。
以下片段明确假设 R2 为 value、R1 为 limit,且只演示条件选择:
cmp r2, r1
blo below_limit
movs r2, #0
below_limit:
blo 表示无符号低于,当 C=0 时分支。假设 R2=5、R1=10,执行比较后 C=0,跳转到 below_limit,R2 保持 5;若 R2=12、R1=10,则 C=1,不跳转,执行 movs 将 R2 置零。
注意这里 blo 是跳过清零操作,不是直接判断需要清零。阅读反汇编时不能只看到某个条件分支就断言其对应 C 语言的 if 为真,必须同时检查跳转目标与顺序执行的代码。
有符号和无符号比较的条件码不同:
| C 比较语义 | 常见 Thumb 条件 |
|---|---|
| 无符号小于 | blo / bcc |
| 无符号大于等于 | bhs / bcs |
| 有符号小于 | blt |
| 有符号大于等于 | bge |
| 相等 | beq |
| 不相等 | bne |
bge 使用 N 与 V 的关系判断有符号比较,不能随意替换成 bcs。例如 0xFFFFFFFF 作为 uint32_t 是 4294967295,而作为 32 位有符号整数是 -1,相对于 10 的比较结果完全不同。
找到函数返回及编译优化的影响
在 Arm AAPCS 下,普通 32 位整数返回值通常放在 R0。bx lr 用 LR 中的返回地址完成返回;如果函数保存了 LR,也可能使用包含 PC 的 pop 指令返回。
对叶子函数而言,假设计算结果已经位于 R3,可以出现如下返回片段:
mov r0, r3
bx lr
片段示例:第一条把结果送到 R0,第二条返回调用方。对于非叶子函数,bl 调用其他函数会更新 LR,因此通常要先保存必要的返回信息。
为了观察优化差异,再编译一次:
arm-none-eabi-gcc -mcpu=cortex-m3 -mthumb -O2 -c thumb_demo.c -o thumb_demo_o2.o
arm-none-eabi-objdump -d thumb_demo_o2.o预期结果:update_counter 通常仍保留必要的 volatile 加载与存储,但局部变量可能完全放在寄存器中,栈帧可能消失,条件分支也可能被条件执行指令或其他等价序列替代。最终以本地生成结果为准。
检查反汇编时,可以用以下四项核对:
- 找到
update_counter的入口符号与函数末尾的返回指令。 - 确认从
counter指向的内存至少读取一次,并在正常执行路径上写回一次。 - 追踪读出值增加 1 后如何与
limit比较,以及哪条路径把结果清零。 - 确认返回前 R0 包含最终写回的数值。
不要用源代码行数推断机器指令条数,也不要认为优化后看不到 cmp 就代表没有比较。最可靠的方法是记录每条指令对寄存器、标志位和内存的实际影响,再沿分支目标追踪执行路径。