
单片机与物联网 / 系统课时
保护中断与主循环共享状态
保护中断与主循环共享状态
当主循环和中断服务程序(ISR)同时访问同一个变量时,即使程序能够正常编译,也可能出现计数丢失、状态不一致或偶发死循环。本篇使用 Cortex-M 裸机示例,分别通过原子交换和短临界区解决共享状态问题,并验证为什么 volatile 不能代替同步机制。
学习目标
- 区分
volatile的编译器访问语义与原子操作、临界区的同步作用。 - 使用 CMSIS 的
__get_PRIMASK()、__disable_irq()和__set_PRIMASK()保护共享状态。 - 根据共享变量的使用方式选择原子交换或短临界区,并验证不会丢失中断事件。
volatile 为什么不能保证原子性
假设定时器每隔 1 ms 触发一次中断,ISR 增加事件计数,主循环定期取走计数并清零。两个执行上下文都访问 pendingTicks,就形成了共享状态。
#include <stdint.h>

static volatile uint32_t pendingTicks = 0;

void SysTick_Handler(void)
{
    ++pendingTicks;  // 记录一次定时器事件
}

uint32_t take_ticks_unsafe(void)
{
    uint32_t ticks = pendingTicks;
    pendingTicks = 0;  // 与 ISR 的递增操作可能交错
    return ticks;
}
以上是片段示例,依赖已配置好的 SysTick、中断向量表和 CMSIS 启动环境,不能独立链接为完整固件。
volatile 要求编译器保留对该对象的实际访问,避免把反复读取直接优化为寄存器中的旧值;但它不提供互斥、事务性,也不保证 ++pendingTicks 是不可中断的整体操作。
即使目标 MCU 对齐的 32 位读取和写入各自可以作为单次访问完成,读取后清零仍然是两个独立动作。++ 通常还包含读取、加法、写回等步骤。
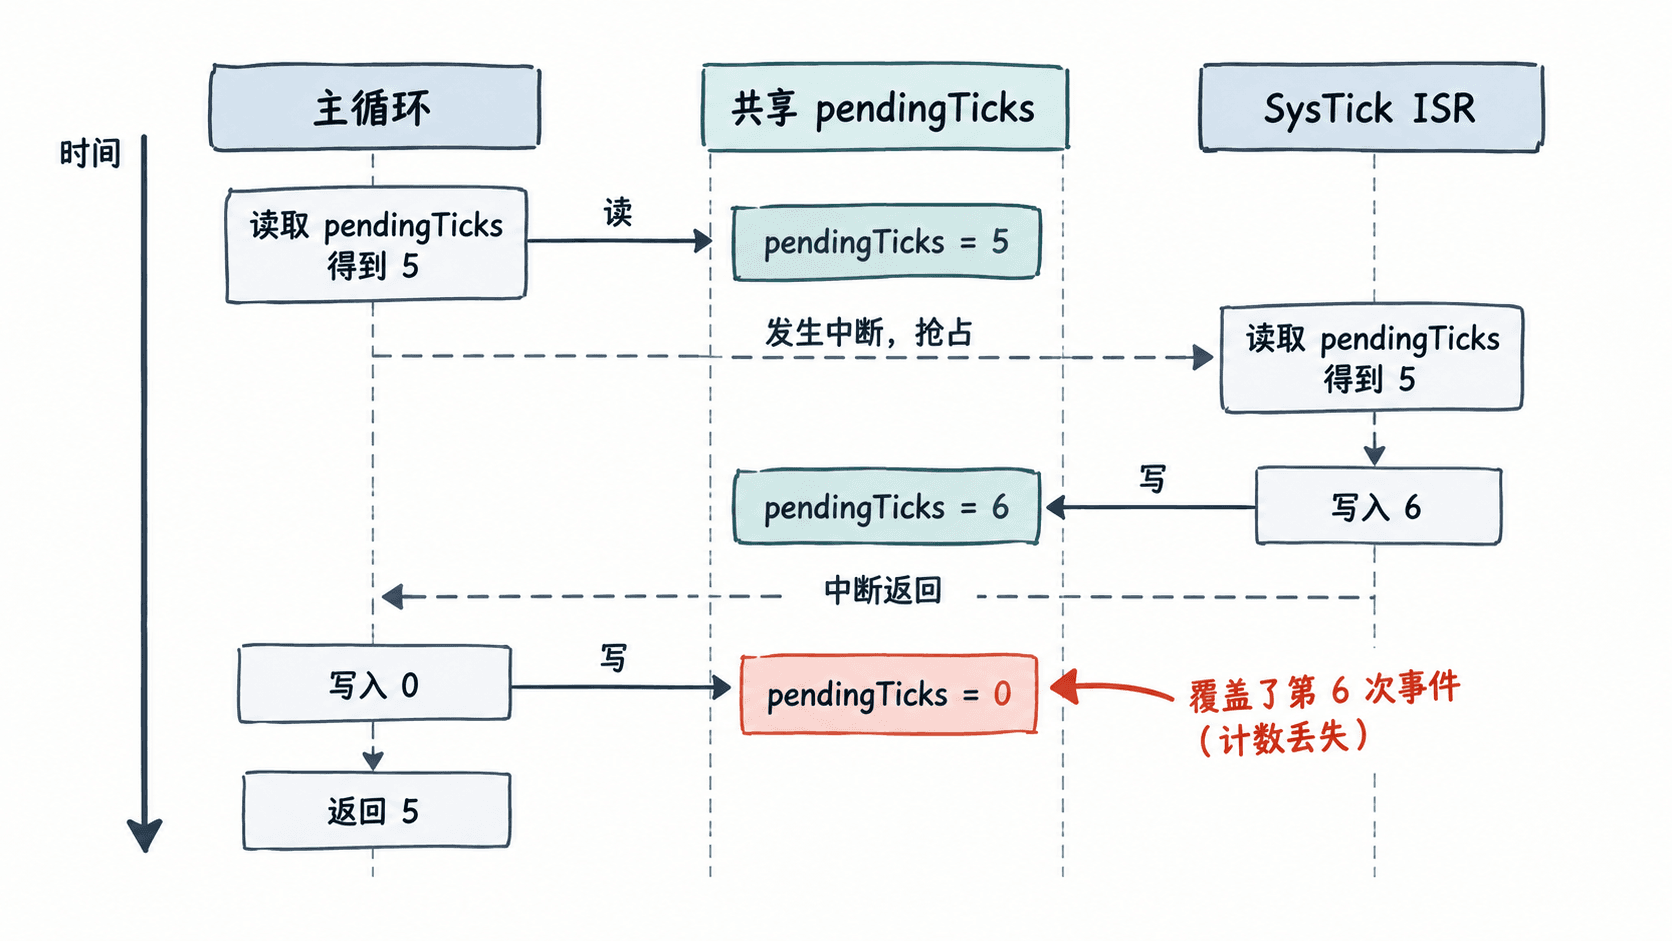
考虑以下真实可发生的交错:
- 共享计数为 5,主循环读取到 5。
- SysTick 中断发生,将共享计数增加到 6。
- ISR 返回,主循环写入 0。
- 本轮函数返回 5,而刚发生的第 6 次事件也被清掉。
预期结果:累计产生 6 次事件,但主循环只处理 5 次,出现一次事件丢失。这是逻辑竞争,不是 volatile 缺失导致的编译错误。
使用短临界区完成读取并清零
对单核 Cortex-M,若共享数据只在普通线程模式和可屏蔽的普通 IRQ 中访问,可以在主循环中短暂屏蔽这些中断,让读取与清零在逻辑上成为不可被普通 IRQ 插入的操作。
下面的示例适用于提供 CMSIS Core 头文件的 Cortex-M 工程。示例通过 __get_PRIMASK() 保存原屏蔽状态,再使用 __disable_irq() 和 __set_PRIMASK() 保护共享操作。
#include <stdint.h>
#include "cmsis_gcc.h"  // 仅作示意;实际项目应包含设备头文件

static volatile uint32_t pendingTicks = 0;

void SysTick_Handler(void)
{
    ++pendingTicks;
}

uint32_t take_ticks_safe(void)
{
    uint32_t oldMask = __get_PRIMASK();
    __disable_irq();

    // 读取和清零不可被普通可屏蔽中断插入
    uint32_t ticks = pendingTicks;
    pendingTicks = 0;

    __set_PRIMASK(oldMask);  // 恢复调用前的屏蔽状态
    return ticks;
}
以上为片段示例:需要设备对应的 CMSIS Core 接口、启动文件与 SysTick 配置。实际工程应包含芯片厂商设备头文件,例如 stm32f4xx.h(仅适用于对应 STM32F4 型号),由其引入正确的 CMSIS Core 定义;不要把 cmsis_gcc.h 当成跨工具链通用头文件。GCC、Arm Compiler、IAR 的底层内建实现可能不同,但标准 CMSIS 接口名称一致。
生效行为:若主循环先进入临界区,普通可屏蔽 IRQ 只能在恢复中断状态后执行;若 ISR 已经执行完毕,则主循环读取其更新后的计数。在这两种情形中,完成的事件更新都不会被读后清零的交错覆盖。
保存并恢复 PRIMASK 比无条件调用 __enable_irq() 更安全。例如调用前 PRIMASK 已为 1,函数结束后仍应保持屏蔽,不能擅自打开中断。
单次标志使用原子交换
如果 ISR 只需通知主循环“发生过事件”,不关心累计发生次数,可以把计数改成单比特事件标志。这时读取并清除必须仍是一个不可分割的动作。
在支持独占访问指令的 Cortex-M3、M4 或 M7 上,可以使用 C11 原子类型;但具体编译器和目标架构是否将操作实现为无锁指令,需要检查编译结果。下面采用 GCC 或 Clang 的 __atomic_exchange_n 内建接口演示,要求所选目标上的 32 位交换为无锁实现。
#include <stdint.h>

static uint32_t eventFlag = 0;

void SysTick_Handler(void)
{
    // 发布事件;不把多个事件累计成多个计数
    __atomic_store_n(&eventFlag, 1u, __ATOMIC_RELAXED);
}

uint32_t take_event(void)
{
    // 交换是一次不可分割的读并清零操作
    return __atomic_exchange_n(&eventFlag, 0u, __ATOMIC_RELAXED);
}
这是片段示例,依赖 GCC/Clang 原子内建接口、已配置的 SysTick 和支持无锁 32 位原子操作的目标。示例只传递事件存在与否,不传递其他缓冲区数据,因此使用 __ATOMIC_RELAXED;如果标志还负责发布其他共享数据,应另外设计发布与获取的内存顺序。
预期行为:两次取事件之间发生一次或多次中断,主循环通常只能取到一次 1;没有新事件时取到 0。这不是计数丢失的修复方案,而是允许事件合并的语义选择。
需要特别注意 Cortex-M0/M0+:不能假定它们支持 Cortex-M3 的 LDREX/STREX 独占访问机制,也不能假定原子交换一定内联且无锁。如果编译器将交换实现为运行时库调用或锁,可能不适合从 ISR 使用。应检查目标编译结果与 __atomic_always_lock_free(4, &eventFlag) 在目标编译器下的判定;不满足要求时,优先使用前述主循环短临界区方案。
控制临界区长度与适用边界
临界区应只包含真正共享的操作,不要在关中断期间执行日志、串口轮询、复杂计算或可能等待中断完成的函数。
| 操作 | 推荐位置 | 原因 |
|---|---|---|
| 读取共享计数并清零 | 临界区内 | 必须保持整体一致性 |
| 复制两个关联的状态字段 | 同一个临界区内 | 避免读到不同时间点的字段组合 |
| 处理 100 次事件对应的业务逻辑 | 临界区外 | 避免长时间阻塞 IRQ |
| 串口发送、等待外设完成 | 临界区外 | 防止延迟过大或依赖中断时卡住 |
例如 CPU 为 48 MHz,临界区执行 24 个核心时钟周期,理想执行时间约为 0.5 微秒;但真实延迟还受 Flash 等待周期、总线访问与编译结果影响。应该以实测最大时间而不是仅凭指令数量决定是否可接受。
若某普通 IRQ 对最大附加延迟的要求是 5 微秒,临界区耗时应显著小于此预算,并保留进入 ISR、异常嵌套和其他高优先级执行因素的余量。
主循环与 ISR 共享结构体时,只有各字段在同一个临界区内被一致地读取,才能避免例如 sampleValue 已更新而 sampleSequence 仍为旧值的混合快照。若 ISR 也会被更高优先级 ISR 打断并共同修改状态,仅在主循环屏蔽 IRQ 并不能处理 ISR 之间的所有竞争,还需重新规划共享所有权和中断优先级。
在目标板验证共享计数不会丢失
可以使用真实 SysTick 中断生成事件,让主循环每隔一段时间批量领取计数。假设 SysTick 为 1 kHz,运行 10 秒理论上产生约 10000 次事件;由于启动和停止测量窗口可能不与滴答严格对齐,验证应以 ISR 实际累计数为准,而不是只比较墙上时间。
在已有 CMSIS 裸机工程中,按以下顺序验证:
- 使用
SysTick_Config(SystemCoreClock / 1000u)设置约 1 ms 的滴答周期,并检查返回值是否为 0;该计算要求SystemCoreClock已正确更新且时钟频率能被合理分频。 - 在 ISR 内另外维护一个仅供测试的累计参考值;正式计数仍用
pendingTicks,不要在业务主循环中清零参考值。 - 主循环累计每次
take_ticks_safe()的返回值,测试终点先屏蔽普通 IRQ,再读取最终参考值与残留pendingTicks。 - 检查
已领取总数 + 未领取计数 = ISR 参考总数,并在优化等级-O0与-O2下分别运行。
参考值读取和残留计数读取必须属于同一个一致性快照。为避免测试参考计数溢出,可将测试窗口限制在远小于 次事件的范围内,或单独设计溢出处理。
预期结果示例:ISR 参考总数为 10000,主循环已领取 9973,停止时尚有 27,则 9973 + 27 = 10000,通过守恒检查。具体数字会随执行时机变化。
如果校验失败,优先检查是否存在别的代码路径清零计数、是否在恢复 IRQ 前完成所有共享读取、是否发生 32 位计数回绕,以及测试代码是否错误地将主循环和 ISR 的变量访问分散到了不同快照。不要仅通过增加 volatile 或在代码中插入延时试图掩盖竞争。
对于需要精确记录每一次事件的应用,选择计数器加短临界区;对于只关心是否曾发生事件且允许合并的通知,选择经过目标架构验证的无锁原子标志。两种方案的选择取决于事件语义和处理器能力,而不是变量上有没有 volatile。