
单片机与物联网 / 系统课时
设置中断优先级并观察嵌套
设置中断优先级并观察嵌套
两个中断同时或先后发生时,Cortex-M 不一定按照触发顺序执行。通过配置 NVIC 优先级并主动触发两个外部中断,可以观察高优先级中断如何打断低优先级处理函数,以及相同或较低抢占优先级为什么只能等待。
学习目标
- 理解 NVIC 优先级数值、有效位数和抢占规则。
- 使用 CMSIS 接口配置两个中断的优先级并触发嵌套。
- 通过调试器中的执行记录验证抢占顺序,识别常见配置错误。
理解 NVIC 优先级的实际含义
Cortex-M 使用 NVIC(Nested Vectored Interrupt Controller)管理外部中断。最容易弄反的规则是:优先级数字越小,实际优先级越高。
例如,两个中断的抢占优先级分别为 2 和 5,优先级 2 可以抢占正在执行的优先级 5 中断;反过来不成立。
NVIC 优先级寄存器通常具有 8 位宽度,但具体芯片只实现其中的高若干位。CMSIS 使用 __NVIC_PRIO_BITS 表示实现的位数。
以 STM32F407 的 Cortex-M4 为例,__NVIC_PRIO_BITS 为 4,因此可使用 0~15 共 16 个逻辑优先级。
| CMSIS 优先级 | 写入寄存器的值 | 相对优先级 |
|---|---|---|
| 0 | 0x00 | 最高 |
| 2 | 0x20 | 较高 |
| 5 | 0x50 | 较低 |
| 15 | 0xF0 | 最低 |
CMSIS 的 NVIC_SetPriority() 接收未左移的逻辑优先级,例如传入 2,内部根据有效位数完成移位。直接写寄存器时才需要自行处理位位置。
区分抢占优先级与响应顺序
部分 Cortex-M 内核支持通过 SCB->AIRCR 中的 PRIGROUP 字段进行优先级分组,将已实现的优先级位划分为抢占优先级和子优先级。Cortex-M0/M0+ 不支持这里演示的可配置分组方式。
两类优先级决定不同的事情:
- 抢占优先级:决定新到来的异常能否打断当前正在执行的异常。
- 子优先级:在抢占优先级相同、多个异常同时等待处理时,参与决定先处理哪个;它不能让同组中断相互抢占。
本次使用 STM32F407,并调用 NVIC_SetPriorityGrouping(0U)。在该芯片实现的 4 个优先级位下,这种分组提供 4 位抢占优先级、0 位子优先级。因此逻辑优先级 2 和 5 可以直接比较抢占能力。
需要注意,PRIGROUP 的编码与某些厂商 HAL 中名为 PriorityGroup 的枚举常量并不相同,不应直接混用数值。
另外,NVIC 还存在以下规则:
- 中断必须已使能,且未被相关屏蔽机制禁止,才能进入处理函数。
- 正在执行的异常只能被具有更高抢占优先级的可抢占异常打断。
- 相同抢占优先级的中断不会彼此嵌套,即使子优先级不同。
PRIMASK、BASEPRI(支持该寄存器的内核)以及当前异常优先级都可能影响实际响应。
编写双中断嵌套实验
实验平台选择 STM32F407,使用 CMSIS 和工程现有的启动文件。测试选用 TIM2、TIM3 对应的 NVIC 外部中断号,但不启动定时器,而是通过 NVIC_SetPendingIRQ() 软件置位挂起状态。
这样既不依赖定时器频率,也不需要配置 GPIO 或外设时钟。测试前应确保其他代码没有使用 TIM2、TIM3 中断,且工程启动文件包含正确的中断向量映射。
目标执行顺序为:
- TIM2 的低优先级处理函数开始执行,记录 1。
- TIM2 主动挂起优先级更高的 TIM3。
- TIM3 抢占 TIM2,记录 2、3。
- TIM3 返回后,TIM2 恢复执行,记录 4。
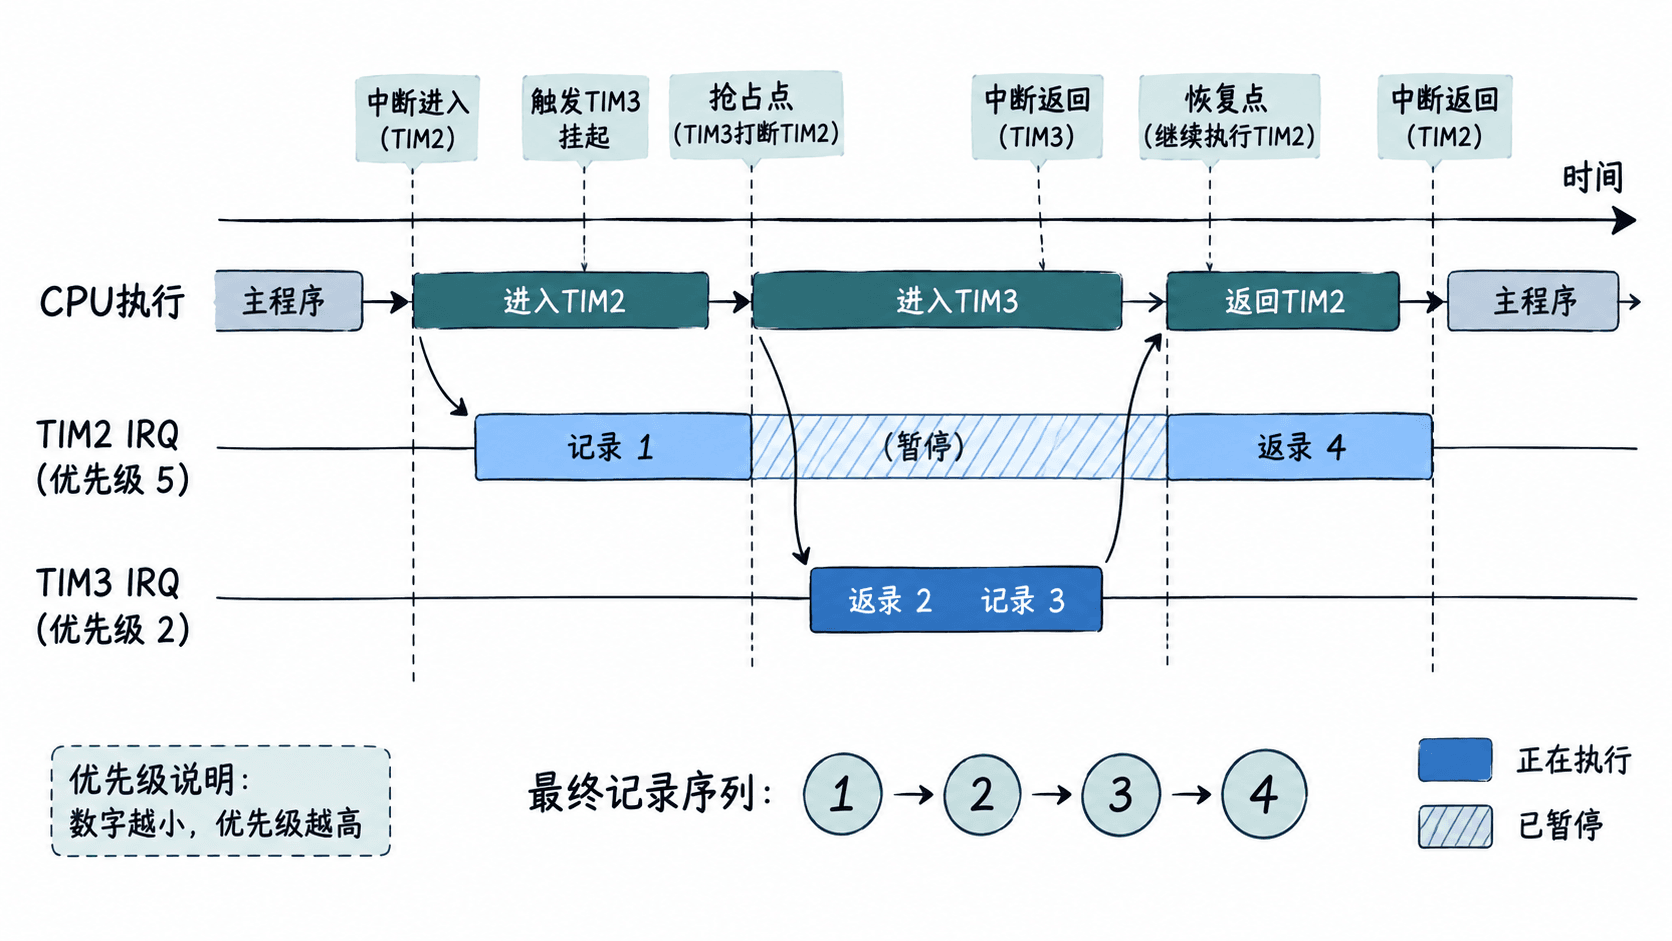
下面是完整的应用代码。它依赖 STM32F4 CMSIS 设备头文件、STM32F407 对应的启动文件及链接脚本,使用裸机工程而非 HAL 中断回调。启动文件通常以弱符号形式定义 TIM2_IRQHandler 和 TIM3_IRQHandler,这里提供同名函数覆盖默认处理函数。
#include "stm32f4xx.h"

volatile uint32_t trace[4] = {0};
volatile uint32_t traceCount = 0;

void TIM3_IRQHandler(void)
{
    trace[traceCount++] = 2;
    trace[traceCount++] = 3;
}

void TIM2_IRQHandler(void)
{
    trace[traceCount++] = 1;

    // 在低优先级中断内部触发高优先级中断
    NVIC_SetPendingIRQ(TIM3_IRQn);

    // TIM3返回后,才会继续执行到这里
    trace[traceCount++] = 4;
}

int main(void)
{
    // STM32F407实现4个优先级位,此分组全部用于抢占
    NVIC_SetPriorityGrouping(0U);
    NVIC_SetPriority(TIM2_IRQn, 5U);
    NVIC_SetPriority(TIM3_IRQn, 2U);

    NVIC_ClearPendingIRQ(TIM2_IRQn);
    NVIC_ClearPendingIRQ(TIM3_IRQn);
    NVIC_EnableIRQ(TIM2_IRQn);
    NVIC_EnableIRQ(TIM3_IRQn);

    // 软件触发低优先级中断,不要求启动定时器
    NVIC_SetPendingIRQ(TIM2_IRQn);

    while (traceCount < 4U) {
        __NOP();
    }

    // 保留结果,供调试器读取
    while (1) {
        __NOP();
    }
}
预期结果:程序进入最后一个无限循环后,在调试器的 Watch 窗口中读取 traceCount 和 trace。
traceCount = 4
trace[0] = 1
trace[1] = 2
trace[2] = 3
trace[3] = 4
这些数字是应用代码主动写入的执行轨迹,不是 UART 日志。实际观察时无需依赖串口,也不需要在中断函数中执行可能阻塞的 printf()。
用调试器验证中断嵌套
可以使用 STM32CubeIDE 配合 ST-LINK 调试 STM32F407。先编译并烧录 Debug 构建,再启动调试会话。
- 在
TIM2_IRQHandler()的第一条记录语句设置断点。 - 在
TIM3_IRQHandler()的第一条记录语句设置断点。 - 运行程序,首先应停在 TIM2 的断点处。
- 继续执行,应进入 TIM3 的断点,而不是先完成整个 TIM2 函数。
- 继续运行,待程序进入末尾循环后暂停,在 Expressions 或 Live Expressions 中查看
traceCount与trace。
如果希望单步观察抢占现场,可以在 TIM3 断点暂停时查看 Call Stack。支持异常栈展开的调试器通常能够展示 TIM3 打断 TIM2 的调用背景;部分调试器只显示当前异常帧,不能把调用栈显示方式当成是否发生抢占的唯一证据。
更直接的证据是最终记录顺序,以及 TIM3 执行时 TIM2 尚未记录退出标记。
还可以通过 CMSIS 读取实际配置,排除配置过程中被其他初始化代码覆盖的情况。
// 片段示例:在调试器暂停时求值,或加入main中的检查逻辑
uint32_t group = NVIC_GetPriorityGrouping();
uint32_t tim2Priority = NVIC_GetPriority(TIM2_IRQn);
uint32_t tim3Priority = NVIC_GetPriority(TIM3_IRQn);
这段代码依赖前面的 STM32F407 CMSIS 工程和优先级配置,不是独立程序。预期读取值为 group = 0、tim2Priority = 5、tim3Priority = 2。如果调试器允许直接查看 NVIC 寄存器,也可观察对应中断的优先级寄存器字段。
修改优先级观察非抢占行为
保持中断处理函数不变,只把主函数里的 TIM3 优先级改为 6:
// 片段示例:替换main中原来的TIM3优先级设置
NVIC_SetPriority(TIM3_IRQn, 6U);
这时 TIM2 的优先级为 5,TIM3 为 6。TIM3 的抢占优先级更低,因此它虽然被置为挂起,却不能在 TIM2 执行期间打断 TIM2。
TIM2 完成两次记录并返回后,处理器才有机会响应等待中的 TIM3。预期结果变为:
traceCount = 4
trace[0] = 1
trace[1] = 4
trace[2] = 2
trace[3] = 3
如果将 TIM3 设置为 5,在当前分组下两者抢占优先级相同,同样不会产生嵌套。这个实验说明,挂起不等于立即抢占,是否能够中断当前处理函数还要比较抢占优先级。
再次测试时应重新复位程序,确保 traceCount 从 0 开始,并避免调试器修改异常屏蔽状态影响观察。
排查顺序与实际工程注意事项
如果实验没有按预期运行,可以根据现象缩小排查范围。
| 现象 | 可能原因 | 检查或修复 |
|---|---|---|
| 始终进不了 TIM2 | 中断未使能或向量错误 | 检查 NVIC_EnableIRQ()、启动文件向量表 |
| TIM3 没有抢占 TIM2 | 优先级设置反了或分组不符 | 读取两个优先级和 PRIGROUP |
| 进入 Default_Handler | 处理函数名称不匹配 | 检查是否精确使用 TIM2_IRQHandler 和 TIM3_IRQHandler |
| 记录数组内容异常 | 其他代码也在操作记录或中断 | 排除共享变量写入和重复触发 |
| 修改优先级后结果不变 | 程序没有重新复位或配置被覆盖 | 重新烧录、复位并读取寄存器 |
中断嵌套还会增加栈使用量。Cortex-M 进入异常时需要保存异常现场,如果允许多层抢占,应根据实际异常嵌套深度和编译器生成的处理函数栈帧评估栈空间,而不能只按单个中断的栈开销估算。
实际项目中,高优先级中断应尽量短,例如先读取硬件状态、清除相应中断标志并记录必要数据,把复杂处理交给主循环或较低优先级任务。对于真正由定时器硬件触发的中断,还必须正确清除外设中断源,否则可能在退出处理函数后立即再次进入。
还要区分实验中的软件挂起和真实外设中断:NVIC_ClearPendingIRQ() 只能操作 NVIC 的挂起状态,不能代替清除定时器、串口等外设自身的中断标志。
当优先级 2 的 TIM3 能够在 TIM2 内部执行,并且把它改成优先级 6 后执行轨迹随之改变,就完成了抢占与非抢占的对照验证。工程中配置 NVIC 时应同时确认优先级有效位数、分组、使能状态和实际异常执行顺序。