
计算机视觉 / 系统课时
识别数据偏差
识别数据偏差
数据量足够并不代表数据可用。训练集若在类别、场景、设备或时间上长期失衡,模型可能只在“常见条件”下表现很好。本课建立一套可执行的偏差检查方法,让数据问题在训练前暴露,而不是等到线上误检、漏检后再返工。
学习目标
- 从类别、场景、设备和时间四个维度识别样本分布偏差
- 发现单维统计正常但交叉切片严重失衡的情况
- 根据偏差类型决定补采、重采样或重新划分数据集
先定义什么叫“偏”
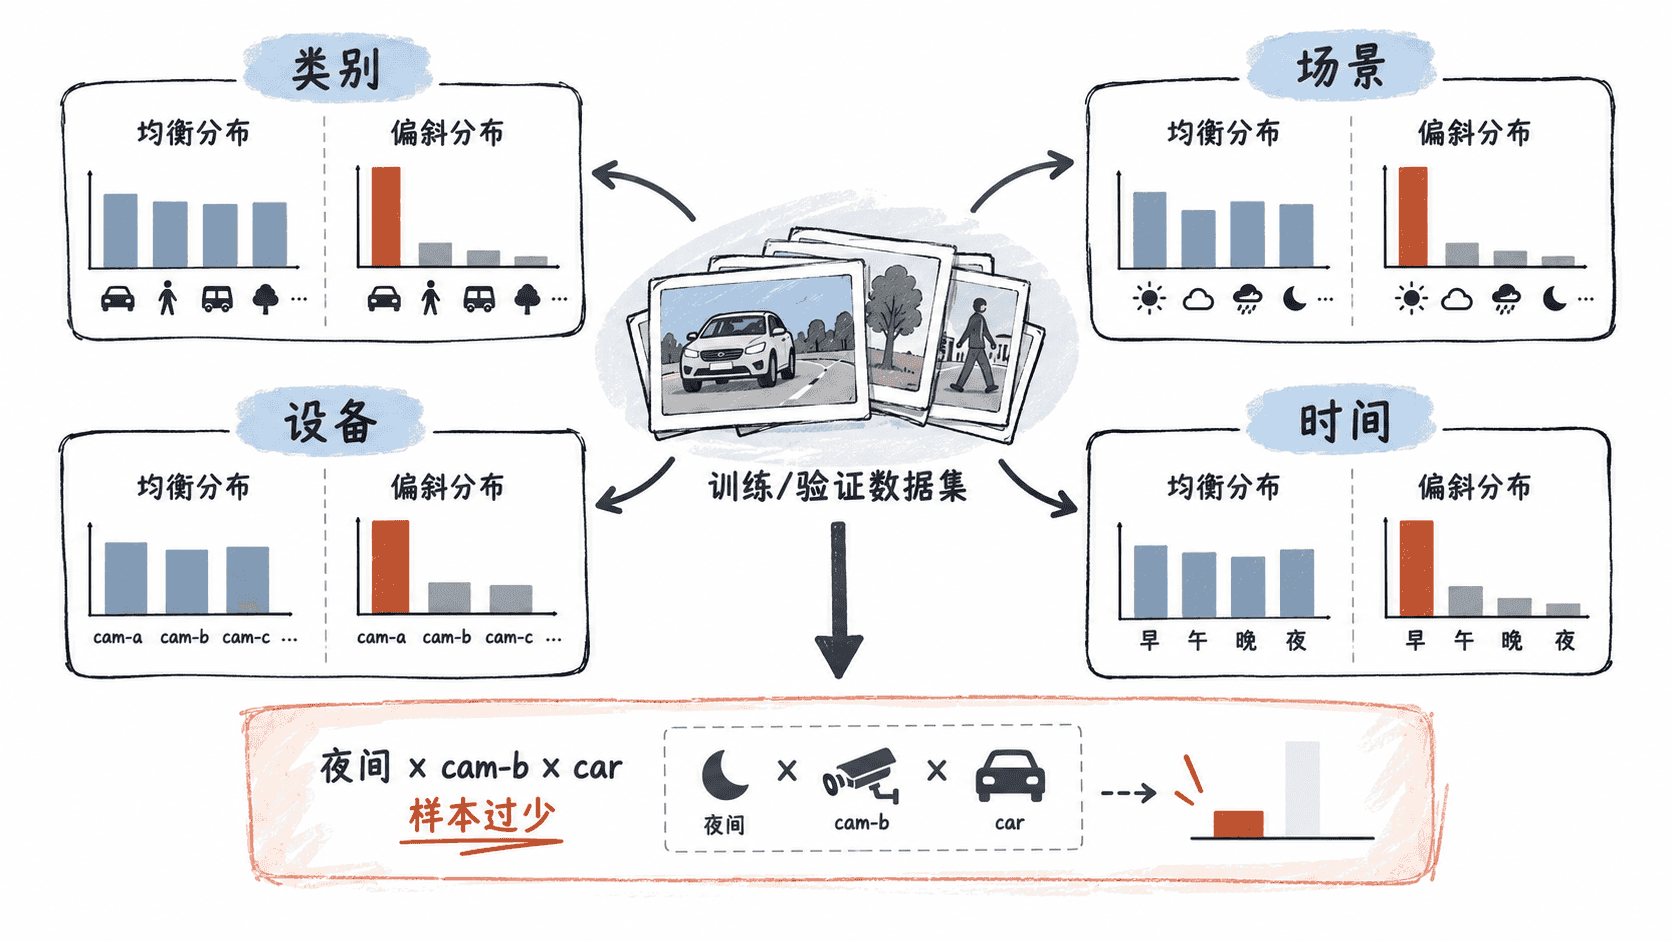
数据偏差不是简单追求每个类别数量完全相同,而是检查训练数据是否覆盖了上线时真正会遇到的分布。对 YOLO 任务,至少要同时看四类信号:类别是否失衡、场景是否单一、设备来源是否集中、采集时间是否偏向某些时段。
例如“person”占 60% 并不一定有问题;如果业务现场本来就以人为主,这可能是合理分布。真正危险的是测试集与上线流量差异很大,或者少数关键类别在夜间、逆光、某型号摄像头上几乎没有样本。
用元数据做第一轮审计
最实用的做法是给每张图片或每个视频片段保留元数据,例如主类别、场景、设备编号和采集时间。下面用一个最小脚本统计四个维度的样本占比,快速暴露明显失衡。
from collections import Counter

records = [
    {"cls": "person", "scene": "day", "device": "cam-a", "hour": 9},
    {"cls": "person", "scene": "day", "device": "cam-a", "hour": 10},
    {"cls": "person", "scene": "day", "device": "cam-b", "hour": 14},
    {"cls": "car", "scene": "day", "device": "cam-a", "hour": 11},
    {"cls": "car", "scene": "night", "device": "cam-b", "hour": 21},
    {"cls": "person", "scene": "night", "device": "cam-a", "hour": 23},
    {"cls": "car", "scene": "day", "device": "cam-a", "hour": 15},
    {"cls": "person", "scene": "day", "device": "cam-a", "hour": 16},
]

def time_bucket(hour: int) -> str:
    if hour < 12:
        return "morning"
    if hour < 18:
        return "afternoon"
    return "night"

def report(name: str, values: list[str]) -> None:
    total = len(values)
    print(f"[{name}]")
    for key, count in sorted(Counter(values).items()):
        print(f"{key}: {count} ({count / total:.1%})")

report("class", [r["cls"] for r in records])
report("scene", [r["scene"] for r in records])
report("device", [r["device"] for r in records])
report("time", [time_bucket(r["hour"]) for r in records])
预期输出
[class]
car: 3 (37.5%)
person: 5 (62.5%)
[scene]
day: 6 (75.0%)
night: 2 (25.0%)
[device]
cam-a: 6 (75.0%)
cam-b: 2 (25.0%)
[time]
afternoon: 3 (37.5%)
morning: 3 (37.5%)
night: 2 (25.0%)
这里已经能看到夜间和 cam-b 样本明显偏少。实际项目还应统计每张图中的目标实例数,而不只统计图片数,因为一张拥挤场景图片可能包含几十个目标,图片数量与标注实例数量并不等价。
重点检查交叉切片
单维统计只是入口,真正容易漏掉的是组合偏差。比如设备总体数量接近,但 cam-b 几乎只在白天采集;夜间样本总体不少,但关键类别 car 只出现几次。训练后整体 Precision、Recall 可能仍然很好,却会在某个业务切片上明显退化。
建议至少检查“类别 × 场景”“类别 × 设备”“场景 × 时间”三类交叉分布。关键业务目标再额外检查三维组合,例如“car × night × cam-b”。如果一个切片在上线中常见,却在训练或验证集中接近空白,应优先补采,而不是只靠随机过采样复制已有图片。
根据偏差选择修复动作
偏差修复要针对原因。类别稀少但场景已经丰富,可以定向补采该类别;设备偏差来自某一型号缺样,应从对应设备重新采集;时间偏差则要补齐夜间、清晨、雨雪等时段。仅仅给少数类增加训练权重,无法创造缺失的视觉条件。
重新划分数据集时,应让训练、验证和测试覆盖相同的重要切片,同时保留独立来源,避免同一视频、同一路段或同一批连拍同时出现在训练与验证中。完成这些检查后,模型评估才是在回答“能否泛化到真实业务”,而不只是“能否记住当前数据集”。