
计算机视觉 / 系统课时
检测重复与近似图像
检测重复与近似图像
重复帧会让训练集看起来很大,却没有增加多少有效信息;如果同一场景同时落入训练集和验证集,还会让验证指标虚高。本课先用文件哈希找完全重复,再用感知哈希识别压缩、缩放或轻微裁剪后的近似图像。
学习目标
- 使用 SHA-256 找出字节级完全一致的重复文件
- 使用 dHash 和汉明距离发现视觉上高度相似的图像
- 为大规模数据集设置合理阈值,并避免误删真正有价值的连续样本
先区分完全重复和近似重复
完全重复指两个文件字节内容一致,适合用 SHA-256 直接判定;近似重复则是画面基本相同,但可能经历重新压缩、缩放、轻微亮度变化等处理,普通文件哈希会完全不同。此时需要把图像压缩成一个“视觉指纹”,再比较指纹之间的差异。
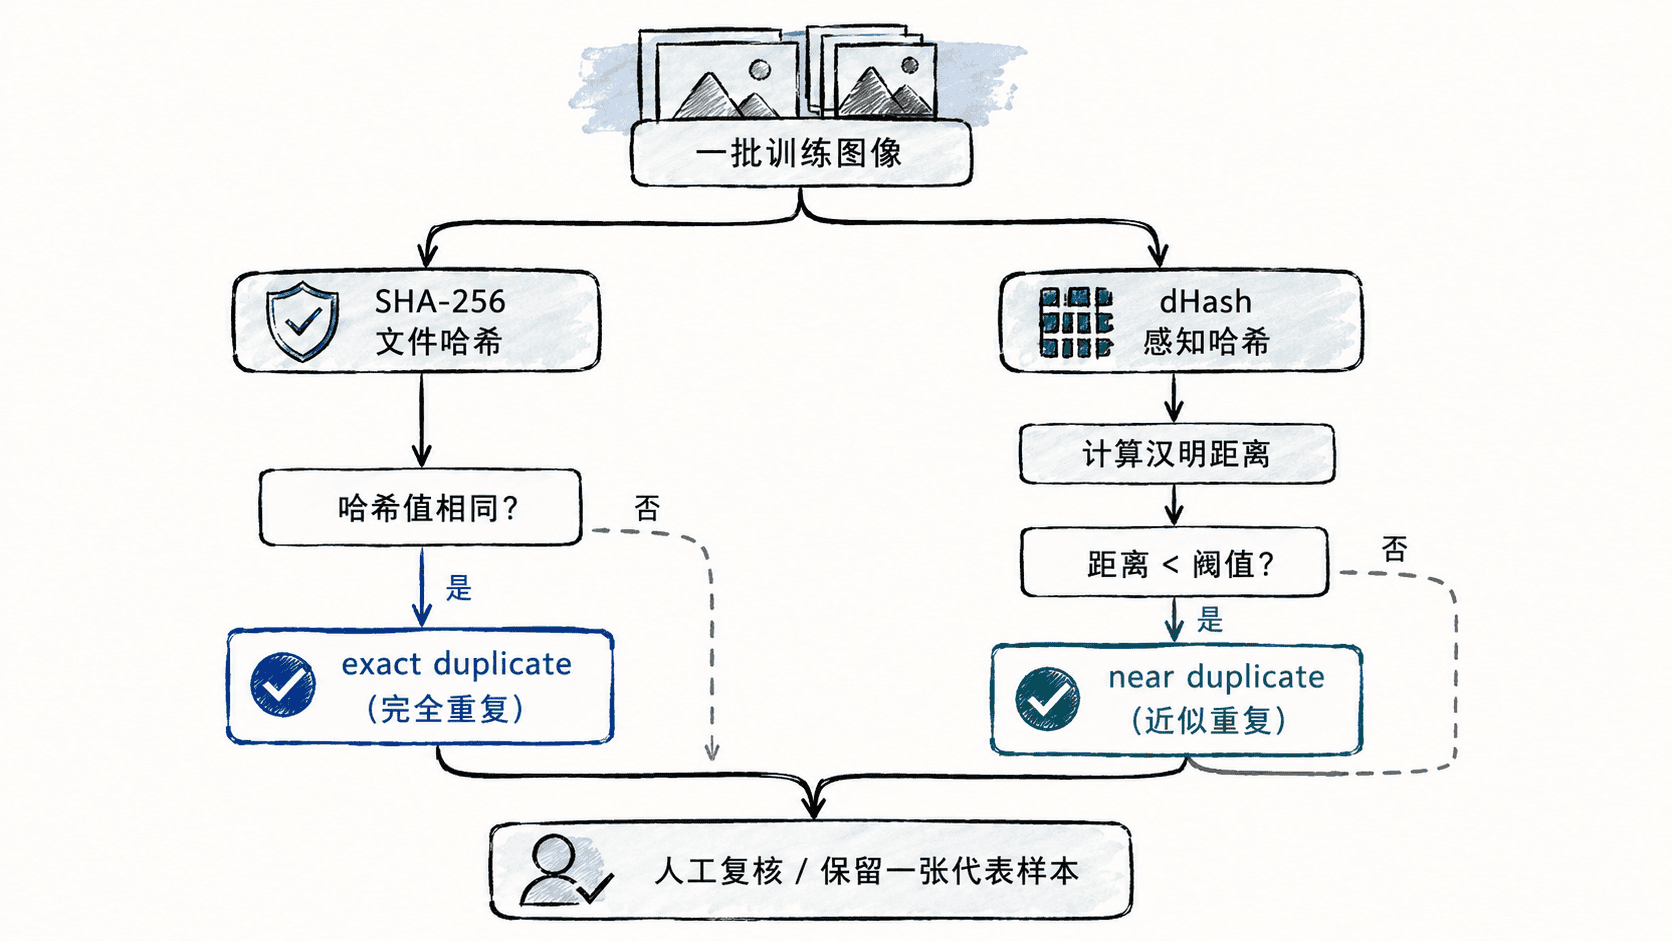
两种方法解决的是不同问题,不能互相替代。文件哈希几乎没有误判,但只能发现完全相同的文件;感知哈希能容忍轻微视觉变化,却需要阈值,也可能把连续视频中“很像但确实有价值”的帧归为一组。
用 SHA-256 找完全重复
下面的脚本只依赖 Python 标准库。它为每个文件计算 SHA-256,并把相同哈希的文件归为一组。保存为 find_exact_duplicates.py:
from collections import defaultdict
from hashlib import sha256
from pathlib import Path

IMAGE_DIR = Path("images")
EXTENSIONS = {".jpg", ".jpeg", ".png", ".bmp", ".webp"}

groups: dict[str, list[Path]] = defaultdict(list)

for path in sorted(IMAGE_DIR.rglob("*")):
    if path.suffix.lower() not in EXTENSIONS:
        continue

    digest = sha256(path.read_bytes()).hexdigest()
    groups[digest].append(path)

for digest, paths in groups.items():
    if len(paths) > 1:
        print(digest[:12], "=>", ", ".join(map(str, paths)))
运行:
python find_exact_duplicates.py预期输出:
<HASH> => images/a.jpg, images/copy/a.jpg<HASH> 和文件名会随数据集不同而变化。对于完全重复组,通常保留一份即可,但删除前仍要确认这些文件是否对应不同的数据划分或不同标注版本。
用 dHash 找近似图像
dHash 会把图像缩成很小的灰度图,再比较相邻像素的亮暗关系,最终得到一个 64 位指纹。两个指纹的汉明距离越小,代表结构越相近。下面实现不依赖额外的感知哈希库,只需要 Pillow。
先安装依赖:
python -m pip install pillow预期结果:命令成功结束后,当前 Python 环境能够执行 from PIL import Image。具体安装日志和版本号可能不同。
保存为 find_near_duplicates.py:
from itertools import combinations
from pathlib import Path
from PIL import Image

IMAGE_DIR = Path("images")
EXTENSIONS = {".jpg", ".jpeg", ".png", ".bmp", ".webp"}
MAX_DISTANCE = 5

def dhash(path: Path) -> int:
    with Image.open(path) as img:
        gray = img.convert("L").resize((9, 8))
        pixels = list(gray.getdata())

    value = 0
    for row in range(8):
        offset = row * 9
        for col in range(8):
            value <<= 1
            value |= pixels[offset + col] > pixels[offset + col + 1]
    return value

def hamming_distance(a: int, b: int) -> int:
    return (a ^ b).bit_count()

items = []
for path in sorted(IMAGE_DIR.rglob("*")):
    if path.suffix.lower() in EXTENSIONS:
        items.append((path, dhash(path)))

for (path_a, hash_a), (path_b, hash_b) in combinations(items, 2):
    distance = hamming_distance(hash_a, hash_b)
    if distance <= MAX_DISTANCE:
        print(f"{distance}\t{path_a}\t{path_b}")
运行:
python find_near_duplicates.py预期输出:
2	images/scene_001.jpg	images/scene_002.jpg
5 images/car_a.jpg images/car_a_compressed.jpg实际距离和文件名取决于数据集。MAX_DISTANCE = 5 适合先做保守筛查,再人工查看候选对;如果误报很多就降低阈值,如果明显漏掉同场景的压缩版本再逐步提高。
控制误删和数据泄漏
视频抽帧数据最容易产生大量近似样本。连续两帧虽然相似,但如果目标姿态、遮挡、尺度或背景发生了有意义变化,就不应简单按“最像”删除。更合理的策略是按时间窗口或场景分组,再从每组保留具有代表性的帧。
上面的两两比较复杂度约为 ,几万张图后会明显变慢。大数据集可以先按 dHash 的高位分桶,只在相近桶内比较,或使用专门的近邻索引减少候选数量;核心原则仍然是先缩小候选,再人工确认边界样本。
最终验收时,完全重复组应只保留必要副本,近似重复组不应被机械清空;同时抽查训练集与验证集之间是否还存在同场景或同源视频的高度相似帧。去重的目标是提升信息密度,而不是追求“每张图都完全不同”。