
计算机视觉 / 系统课时
完成目标检测训练项目
完成目标检测训练项目
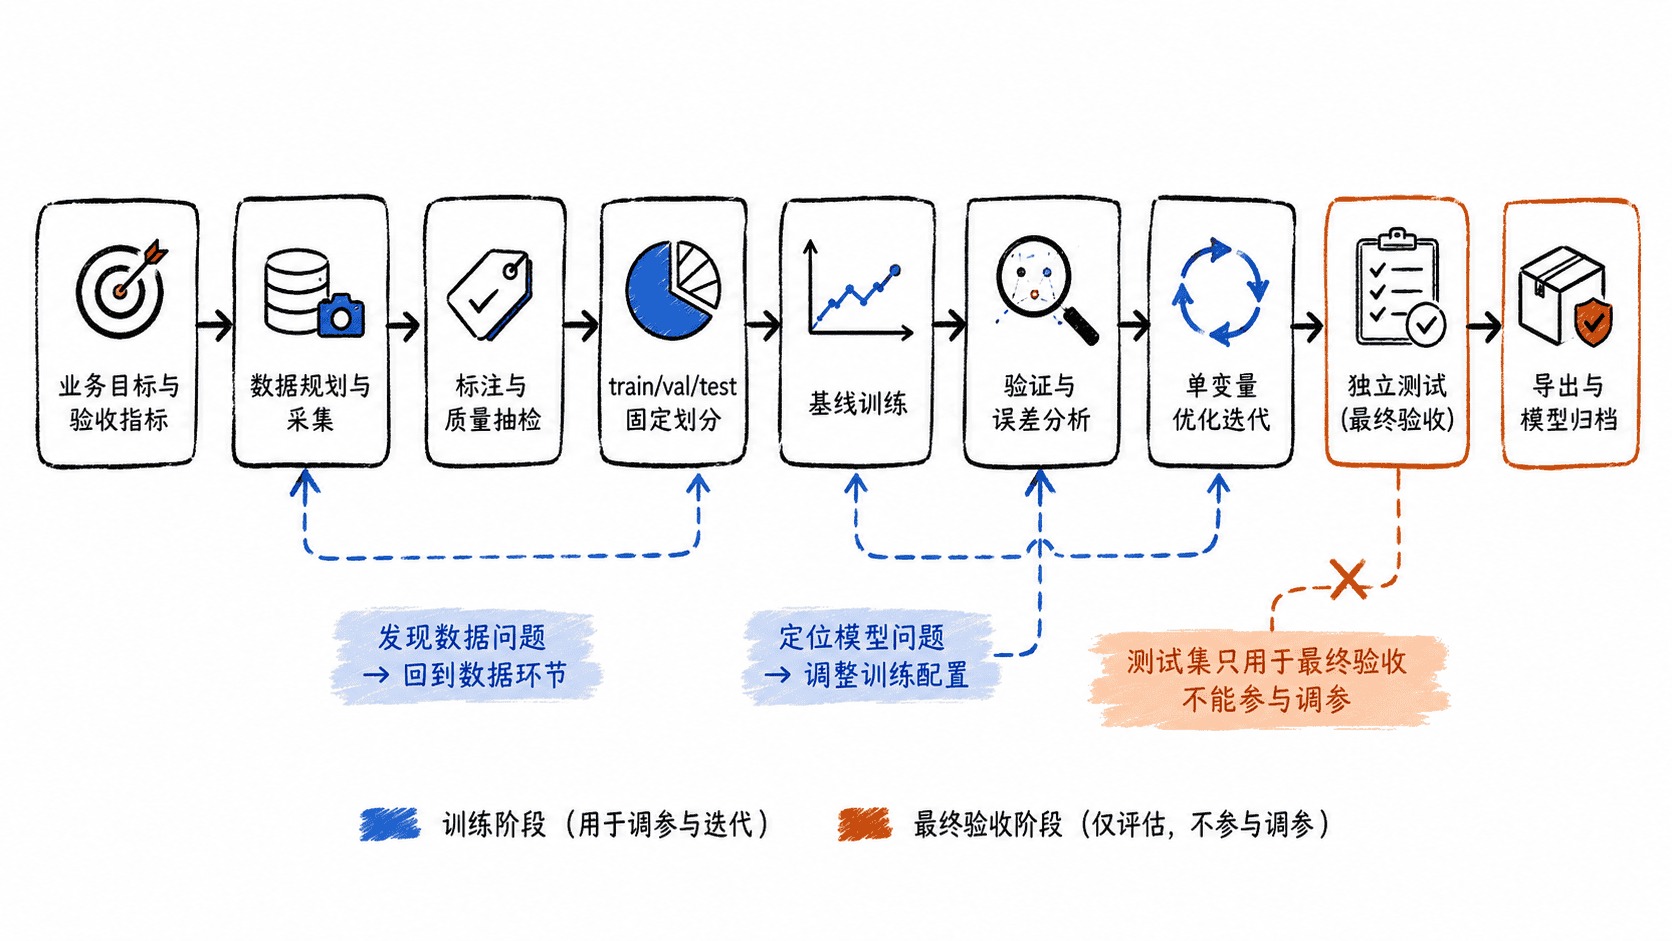
一个完整的目标检测项目不止是跑通训练命令,而是把数据规划、标注质量、训练评估、针对性优化和模型归档连成可复现流程。最终交付物应让另一位工程师拿到项目后,能够重新训练、复核指标并定位部署模型。
学习目标
- 能从业务目标反推数据、标注和验收指标
- 能完成训练、独立评估与有依据的优化迭代
- 能归档配置、权重、指标和环境信息,形成可复现交付物
定义可验收目标
先把“效果好”改写成可验证条件。目标至少包含检测对象、误检与漏检的业务代价、目标设备上的延迟预算,以及必须支持的输入类型。类别定义也要在采集前冻结,避免后期因为类别含义变化导致整批标签返工。
训练前建议建立一份最小验收表:关键类别达到项目阈值;独立测试集总体指标不低于阈值;目标硬件延迟满足预算;声明支持的输入全部兼容。阈值应由业务风险和部署资源决定,而不是训练完成后再根据现有结果倒推。
组织数据与标注
数据应覆盖真实部署分布,包括常见场景与少量高风险困难样本。标注规范要明确类别边界、遮挡目标、截断目标、极小目标和忽略区域如何处理,并通过抽检保证不同标注人员的判断一致。
一个常见的数据配置可以保持 train、val、test 三个固定划分:
path: <PATH>/dataset
train: images/train
val: images/val
test: images/test
names:
  0: target_a
  1: target_b
该配置生效后,训练阶段只使用 train 与 val;最终验收命令显式指定 split=test。如果类别顺序、目录或划分发生变化,应更新配置版本并重新记录数据集版本,不能只替换文件而不留痕。
完成训练评估优化
先训练一个可复现基线,再根据验证集上的错误类型决定下一步。不要同时改很多变量;一次只调整数据、增强策略、输入尺寸、训练轮数或模型规模中的少数因素,否则无法判断收益来自哪里。
下面用 Ultralytics CLI 串起基线训练、独立测试和 ONNX 导出。<PATH> 替换为实际目录,预训练权重文件由项目自行选定并固定版本。
yolo detect train model=<PATH>/pretrained.pt data=<PATH>/dataset.yaml epochs=80 imgsz=640 project=<PATH>/runs name=baseline
yolo detect val model=<PATH>/runs/baseline/weights/best.pt data=<PATH>/dataset.yaml split=test imgsz=640
yolo export model=<PATH>/runs/baseline/weights/best.pt format=onnx imgsz=640
预期结果
训练完成,最佳权重位于:<PATH>/runs/baseline/weights/best.pt
独立测试集 mAP50-95:<VALUE>
ONNX 模型已导出到:<PATH>/runs/baseline/weights/best.onnx
<VALUE> 取决于数据和模型。若结果未达标,应先看按类别指标和典型误检、漏检样本:数据覆盖不足就补数据,标签不一致就修标注,目标过小可尝试更合适的输入尺寸,资源超限则评估更小模型或部署端优化。任何优化都应回到验证集比较,测试集继续保持隔离。
归档可复现资产
项目通过最终测试后,不要只保存一个 best.pt。至少归档数据集版本或清单、标注规范、dataset.yaml、训练参数、随机种子、代码与依赖版本、最佳权重、导出模型、验证结果、独立测试结果和典型失败样本。
还应为最终模型计算校验值,保证后续部署拿到的文件就是验收过的那一份:
sha256sum <PATH>/runs/baseline/weights/best.pt <PATH>/runs/baseline/weights/best.onnx预期输出
<VALUE>  <PATH>/runs/baseline/weights/best.pt
<VALUE>  <PATH>/runs/baseline/weights/best.onnx
这里的 <VALUE> 是实际 SHA-256 摘要。将摘要和测试报告一起归档后,可以在部署、回滚或审计时确认模型身份,避免“文件名相同但内容已变化”的问题。
项目验收清单
最终验收只看可复现证据:数据版本明确,类别与标注规则稳定,训练配置可重跑,验证集上的优化有记录,独立测试达到门槛,目标硬件速度合格,部署格式已验证,模型文件与校验值已归档。
当这些条件同时满足时,训练项目才真正结束。此时交付的不只是一个可用权重,而是一条能够重现、解释、验证和回滚的完整工程链路。