
计算机视觉 / 系统课时
补充困难样本
补充困难样本
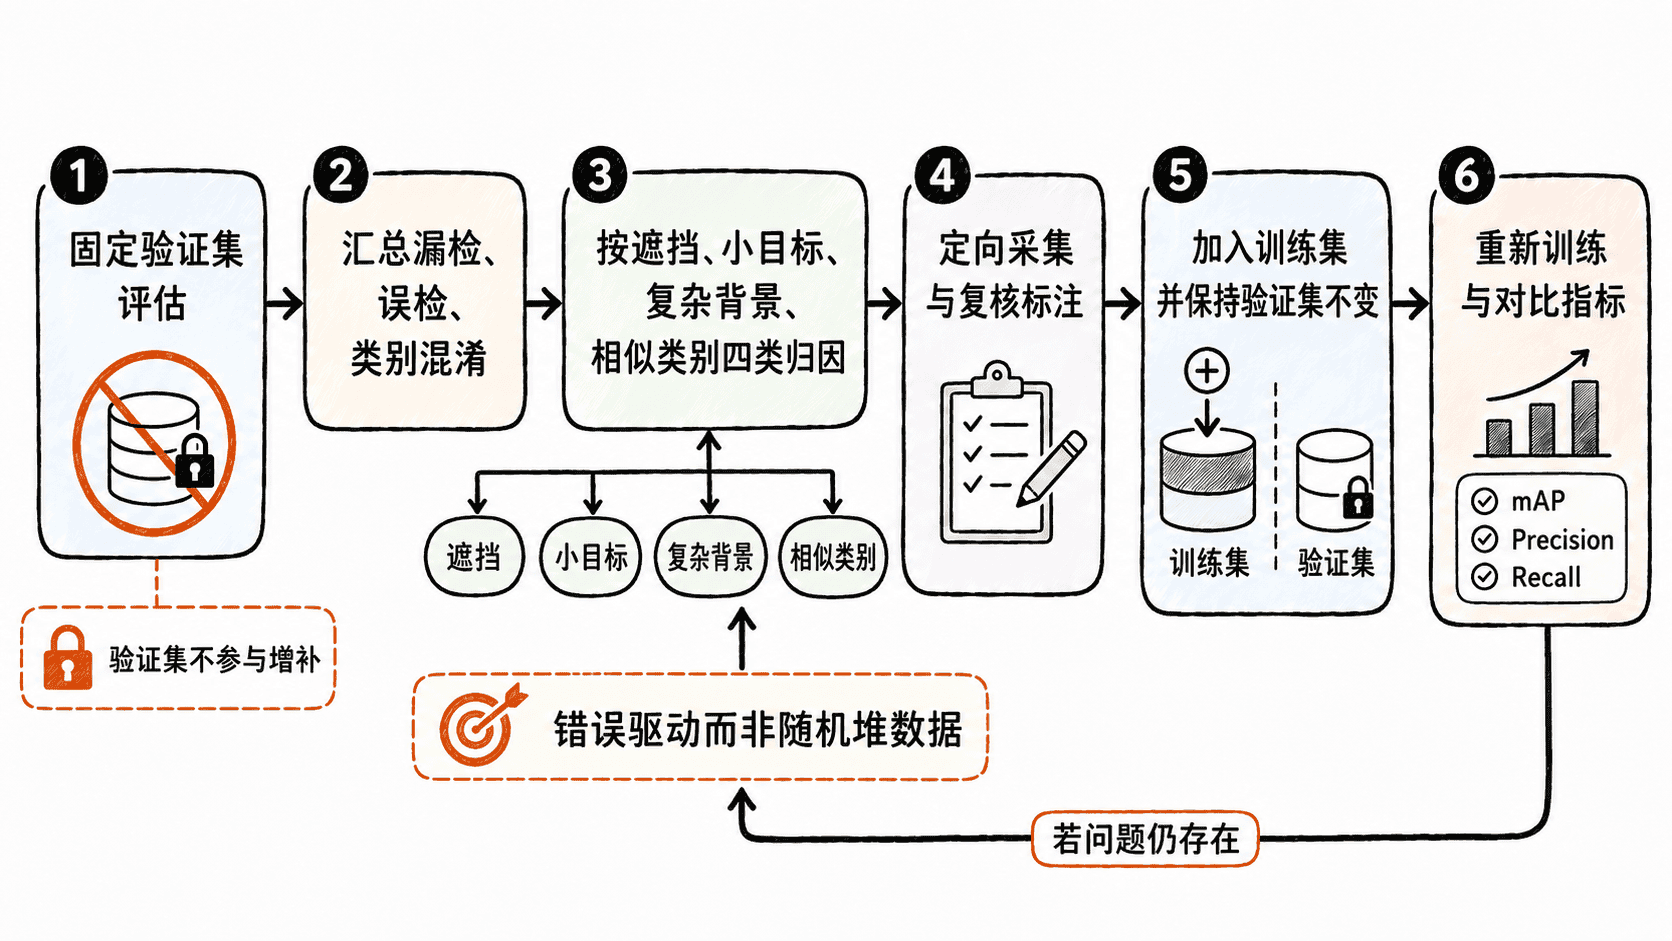
模型在常规样本上表现稳定后,继续堆普通图片往往收益有限。本节用“错误驱动”的方式补充遮挡、小目标、复杂背景和相似类别样本,并建立筛选、标注、回归验证的闭环。
学习目标
- 根据验证集错误识别真正的困难样本类型
- 用可重复规则筛选小目标等高价值样本
- 控制困难样本比例,并用固定验证集确认收益
先从错误而不是图片数量出发
困难样本的价值在于它能解释模型已经暴露出的错误。先固定一份验证集,记录漏检、误检和类别混淆,再把错误按场景归类。常见的高价值类别包括:目标被遮挡、目标占图像比例很小、背景纹理复杂,以及外观相近的类别被混淆。
不要把“看起来很难”当作唯一标准。若某类场景在真实业务里很少出现,即使视觉上复杂,也不一定值得大量扩充。优先级应同时考虑错误频率、业务损失和采集成本。
用规则筛出小目标候选
YOLO 标注中的宽高已经归一化到 0~1,因此可以用 w * h 近似目标占整图的面积比例。下面脚本扫描训练集标签,只要一张图片中存在面积不超过 1% 的框,就把对应图片名写入候选清单。
from pathlib import Path

labels_dir = Path("dataset/labels/train")
output_file = Path("hard-small.txt")
area_threshold = 0.01

selected = []
label_files = sorted(labels_dir.glob("*.txt"))

for label_file in label_files:
    is_hard = False
    for line in label_file.read_text(encoding="utf-8").splitlines():
        parts = line.split()
        if len(parts) != 5:
            continue
        _, _, _, w, h = parts
        if float(w) * float(h) <= area_threshold:
            is_hard = True
            break

    if is_hard:
        selected.append(label_file.stem)

output_file.write_text("\n".join(selected), encoding="utf-8")
print(f"scanned={len(label_files)} selected={len(selected)}")
print(f"manifest={output_file}")
预期输出
scanned=<VALUE> selected=<VALUE>
manifest=hard-small.txt
实际数量取决于数据集。这个清单只是候选集,还需要人工确认图片是否真的具有训练价值;遮挡程度、背景复杂度和相似类别通常不能仅靠框坐标可靠判断。
补样时控制分布
困难样本不是越多越好。一次迭代最好只针对少数主要错误补样,并记录新增样本来源与类型。若把训练集突然替换成大量极端场景,模型可能提高困难场景召回率,却损失常规场景表现。
新增图片必须沿用原有标注规范,尤其要检查被遮挡目标是否仍应标注、极小目标的最小可标尺度,以及相似类别之间的判定边界。困难样本上的标注噪声通常比普通样本更伤模型,因为模型会反复学习这些高冲突例子。
用固定验证集判断是否真的变好
重新训练时保持验证集、训练配置和主要超参数尽量不变,只修改训练数据。比较总体指标之外,还要单独检查原先最差的困难场景:小目标召回是否提升、遮挡漏检是否下降、相似类别混淆是否减少,以及常规场景是否出现退化。
一次有效的数据迭代应能回答“新增哪类样本,解决了哪类错误”。如果指标没有变化,先检查新增样本是否足够集中、标注是否一致,以及困难场景在训练批次中是否真正被模型看到,而不是继续无目标地扩大数据量。