
计算机视觉 / 系统课时
分析混淆矩阵
分析混淆矩阵
混淆矩阵把“真实类别”和“预测类别”放到同一张矩阵里,可以快速定位哪些类别互相误判,以及误检和漏检主要集中在哪里。本节以目标检测常见的含背景矩阵为例,建立一套从看图到定位数据问题的分析顺序。
学习目标
- 能先确认矩阵坐标定义,再正确读取对角线与非对角线。
- 能从类别混淆、背景误检和背景漏检三类信号判断错误来源。
- 能把矩阵中的异常转换成可执行的数据检查和训练改进动作。
先确认矩阵的行列含义
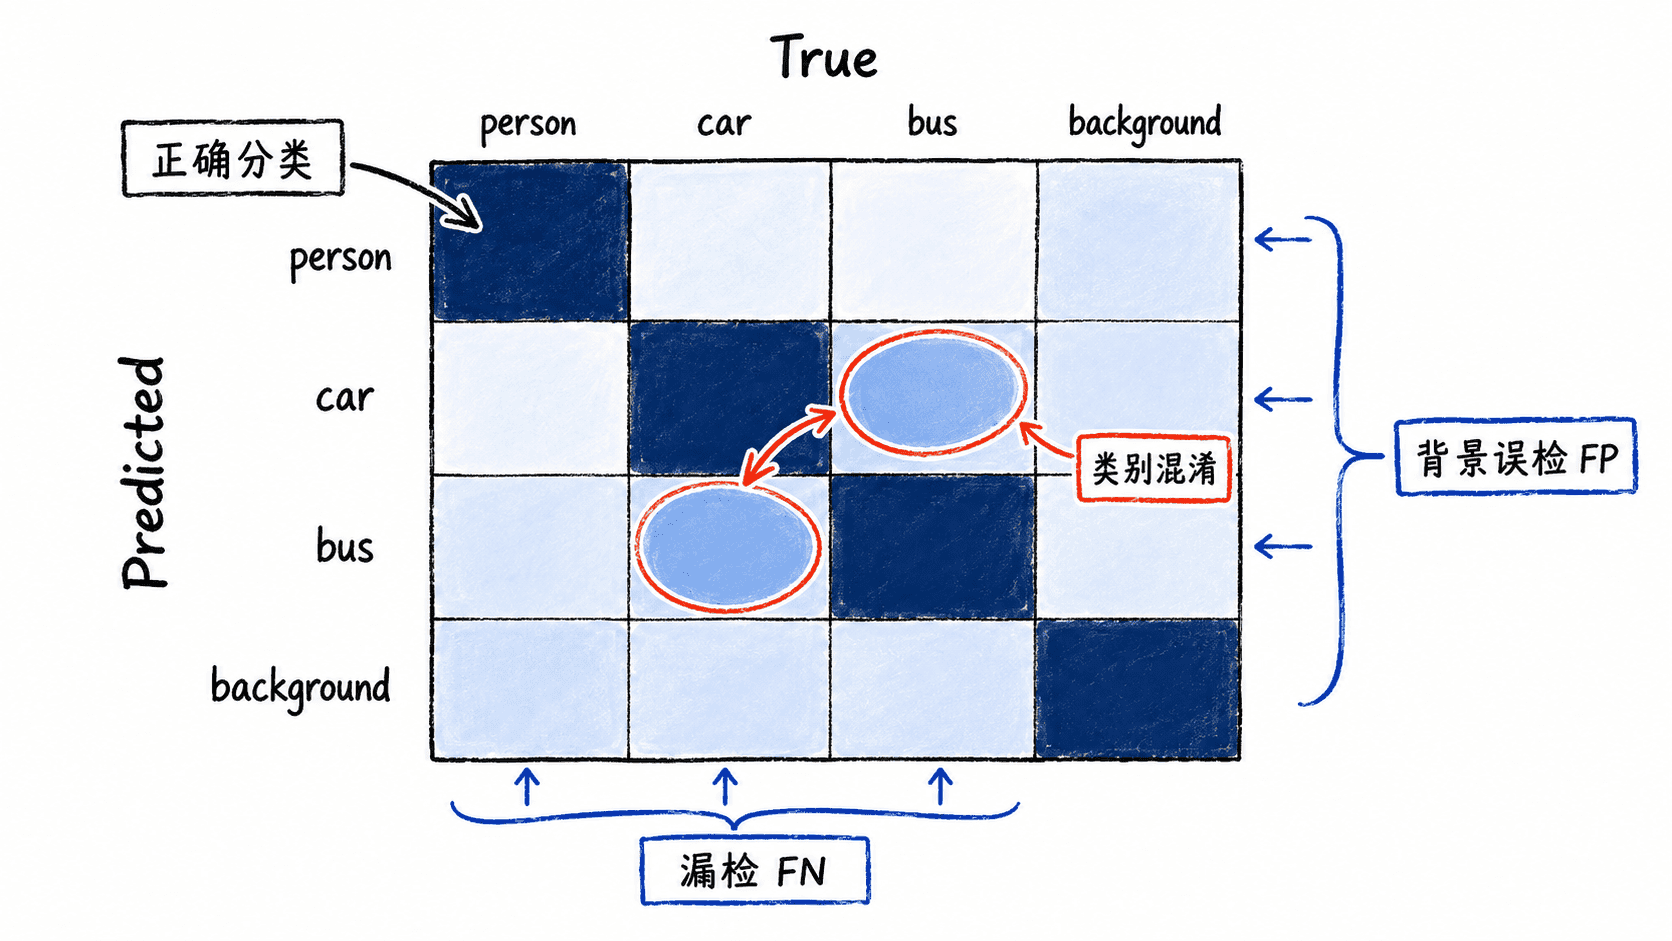
不同工具对混淆矩阵的横纵轴定义可能相反,因此第一步不是找最大值,而是确认“哪一轴是真实类别、哪一轴是预测类别”。本节采用横轴是真实类别、纵轴是预测类别的约定,并额外加入 background 行和列。
在这种约定下,对角线表示预测类别与真实类别一致;非对角线表示类别混淆。background 列表示模型预测出了某个类别,但没有对应真实目标,通常对应背景误检;background 行表示真实目标存在,却没有被有效预测匹配,通常对应漏检。
对角线先看整体可分性
对角线越集中,说明正确分类越多。若某个类别的对角线明显偏弱,先不要立刻判断“这个类别学不会”,而要结合该类别样本数看:少样本类别即使只有少量错误,比例也可能很难看。
归一化矩阵更适合比较不同类别的错误比例,原始计数矩阵更适合判断错误的绝对数量。实际排查时两种都看:先用归一化矩阵找异常类别,再回到原始数量确认它是不是值得优先处理。
非对角线定位类别混淆
若 car 的真实样本经常被预测成 bus,对应非对角线单元格会明显变深。这类错误通常来自视觉外观接近、类别定义边界含糊、标注规则不一致,或某一类别样本覆盖不足。
排查时优先抽取该单元格对应的失败样本,检查三件事:目标本身是否难分、标签是否统一、两类的尺度和拍摄场景是否严重偏置。若发现同一种外观在不同图片里被标成不同类别,应先修标注规则;继续训练通常只会把冲突学得更牢。
background 列发现误检
在本节的坐标约定下,某一预测类别落到 background 列,表示模型在没有匹配真实目标的位置给出了该类别预测。这是背景误检,常见原因包括负样本不足、背景纹理与目标相似、标注漏框,以及置信度阈值设置过低。
例如预测为 person、真实为 background 的单元格很高时,应检查路牌、树干、衣架等是否频繁被识别人,同时确认训练集里这些困难背景是否充分出现。若错误主要来自极低置信度预测,可结合 Precision-Recall 曲线重新选择推理阈值;若高置信度仍大量误检,则更可能是数据覆盖或标注问题。
background 行发现漏检
background 行代表真实目标没有被任何有效预测匹配。若某一真实类别在这一行占比很高,说明模型经常“看不见”该类目标,而不是把它错分成别的类别。
漏检要重点检查小目标、遮挡、密集场景、极端光照和标注框质量。还要确认匹配失败是否因为框位置偏差过大:模型可能确实给出了正确类别,但 IoU 没达到评估阈值,因此最终仍会落入漏检。
从矩阵转成改进动作
混淆矩阵最有价值的不是“看哪个格子最深”,而是把异常分成三类并采取不同动作:类别互混优先检查类别定义与易混样本;background 列异常优先检查困难负样本、漏标和阈值;background 行异常优先检查难例覆盖、目标尺度和定位质量。
每次改动后都用同一验证集重新生成混淆矩阵,并同时比较 Precision、Recall 和各类别 AP。只有当目标异常单元格减少,而且整体指标没有被另一类错误抵消,才能说明修复真正有效。