
计算机视觉 / 系统课时
YOLO 训练任务概览
YOLO 训练任务概览
YOLO 训练并不是把一批图片交给程序后等待模型生成,而是一个从数据标注、训练、验证到误差分析和再次迭代的闭环。本节先建立完整心智模型,明确目标检测的输入、模型输出以及每一轮训练结束后应该依据什么决定下一步。
学习目标
- 说清目标检测训练所需的数据输入以及模型最终输出
- 理解训练、验证、评估和模型迭代之间的关系
- 能根据训练结果判断应改数据、改训练策略还是继续迭代
训练的输入和输出
目标检测模型学习的是“图像中有什么,以及它在哪里”。因此训练数据至少包含两部分:原始图像,以及与图像对应的目标标注。每个标注通常记录类别和目标框位置,例如一张街景图片中可以同时标出汽车、行人和自行车。
模型完成一次推理后,不会只返回一个类别,而是生成若干候选目标。每个目标通常包含类别、边界框位置和置信度。后处理会过滤低置信度结果,并处理多个候选框重复覆盖同一物体的问题,最终形成可供业务使用的检测结果。
一次训练经历哪些阶段
完整流程可以概括为数据准备、训练、验证、误差分析和模型迭代。训练集用于更新模型参数,验证集不参与参数更新,而是用来观察模型面对未参与训练的数据时表现如何。
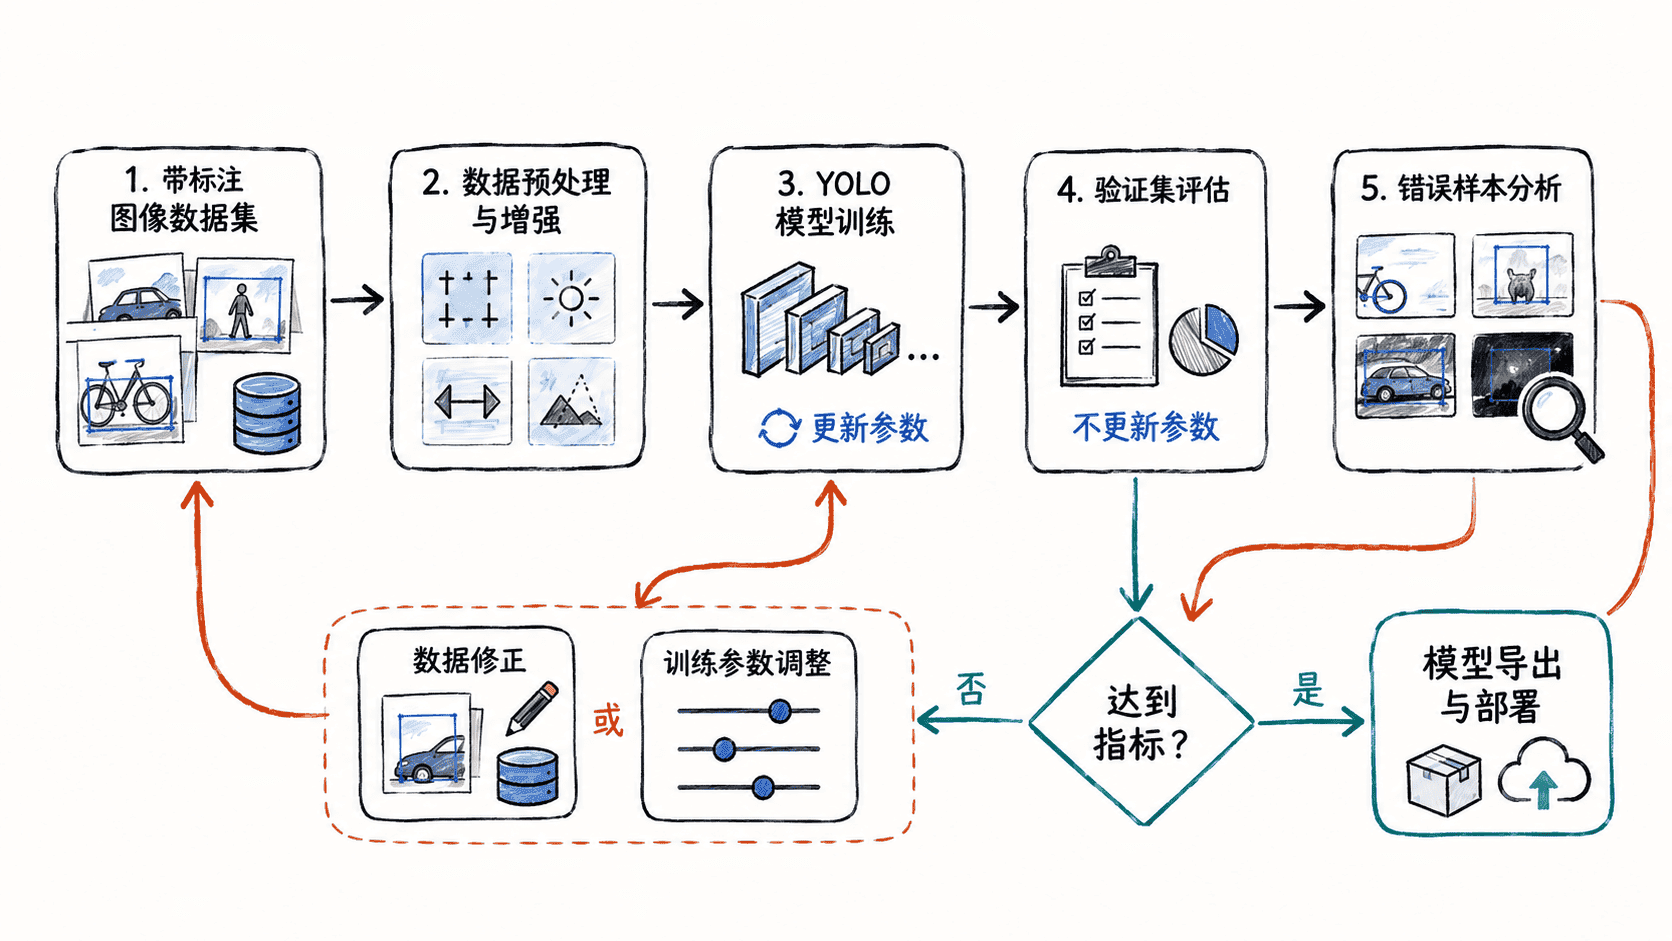
训练过程中,优化器会根据损失不断更新模型参数。一轮遍历完整训练集通常称为一个 epoch。完成若干 epoch 后,需要结合验证指标判断模型是否真的变好,而不能只观察训练损失持续下降。
评估结果到底在回答什么
训练结束后最重要的问题不是“训练跑完了吗”,而是模型能否稳定找到业务关心的目标。目标检测常关注 Precision、Recall 和 mAP 等指标,同时还要查看真实图片上的预测效果。
Precision 较低时,往往意味着误检较多;Recall 较低时,则可能存在大量漏检。单独追求某个指标并不足以定位问题,例如小目标漏检可能来自图片分辨率、标注质量、类别样本数量或训练配置,因此指标必须和错误样本一起分析。
模型迭代从错误样本开始
一次训练通常不会直接得到最终模型。更有效的方法是保存验证集中的误检、漏检和定位不准样本,再根据错误类型决定下一轮改什么。
如果错误集中在某个类别,先检查该类别样本数量和标注一致性;如果大量目标框位置偏差明显,应检查标注边界是否稳定;如果训练指标很好但真实场景效果差,则要确认训练数据是否覆盖实际光照、拍摄角度、背景和目标尺寸。
因此,YOLO 训练的核心并不是反复增加 epoch,而是形成“数据与标注 → 训练 → 验证 → 错误分析 → 修正数据或策略 → 再训练”的闭环。只要每轮迭代都有明确依据,模型质量才会持续向业务目标靠近。