
计算机视觉 / 系统课时
设计对照实验
设计对照实验
参数调优最容易踩的坑,是同时改动多个设置后只看一次训练结果。本节用“基线组 + 单变量实验组”建立可复现的对照流程,让你能判断指标变化究竟来自哪一个参数,并把有效结论沉淀为下一轮实验依据。
学习目标
- 建立固定数据、模型和训练条件的基线实验
- 按单变量原则设计实验组,并记录参数与指标差异
- 用重复实验和统一指标判断改动是否值得保留
先固定基线
对照实验的第一步不是“调参”,而是把除待研究变量外的条件固定下来。至少锁定训练集与验证集划分、初始模型、输入尺寸、训练轮数、批大小、随机种子和评估指标。否则即使 mAP 发生变化,也很难确认变化来自参数还是数据与随机性。
可以先建立一张实验记录表,后续每次训练都追加一行:
| 实验 | 唯一改动 | seed | mAP50-95 | Precision | Recall | 备注 |
|---|---|---|---|---|---|---|
| baseline | 无 | 42 | <VALUE> |
<VALUE> |
<VALUE> |
基线 |
| mosaic-05 | mosaic=0.5 |
42 | <VALUE> |
<VALUE> |
<VALUE> |
仅修改 Mosaic |
<VALUE> 在训练结束后替换为真实指标,不要预先填写期望数字。
只改变一个变量
如果一轮实验同时修改学习率、批大小和数据增强,即使结果变好,也无法知道哪个改动真正有效。更可靠的做法是一次只改变一个因素,并让实验组直接继承基线的其他条件。
下面以 Ultralytics YOLO CLI 为例,对比默认基线与只修改 Mosaic 强度的实验。把 <PATH> 替换为数据集配置文件所在路径。
yolo detect train model=yolo11n.pt data=<PATH>/data.yaml epochs=50 imgsz=640 batch=16 seed=42 project=runs/ab name=baseline
yolo detect train model=yolo11n.pt data=<PATH>/data.yaml epochs=50 imgsz=640 batch=16 seed=42 mosaic=0.5 project=runs/ab name=mosaic-05
预期结果
完成两次训练后,应得到两个独立结果目录:
runs/ab/baseline
runs/ab/mosaic-05
最终 Precision、Recall、mAP 等数值以实际训练结果为准。
如果目录已存在,工具可能自动生成带后缀的新目录,因此实际路径可能不同。比较结果时要确认读取的是本轮实验生成的文件。
建立可追溯的实验流程
一轮可靠实验应形成“提出假设 → 固定基线 → 单变量修改 → 训练 → 统一评估 → 记录结论”的闭环。只有指标改善并且代价可接受,才把改动纳入新的基线;否则回退并测试下一个变量。
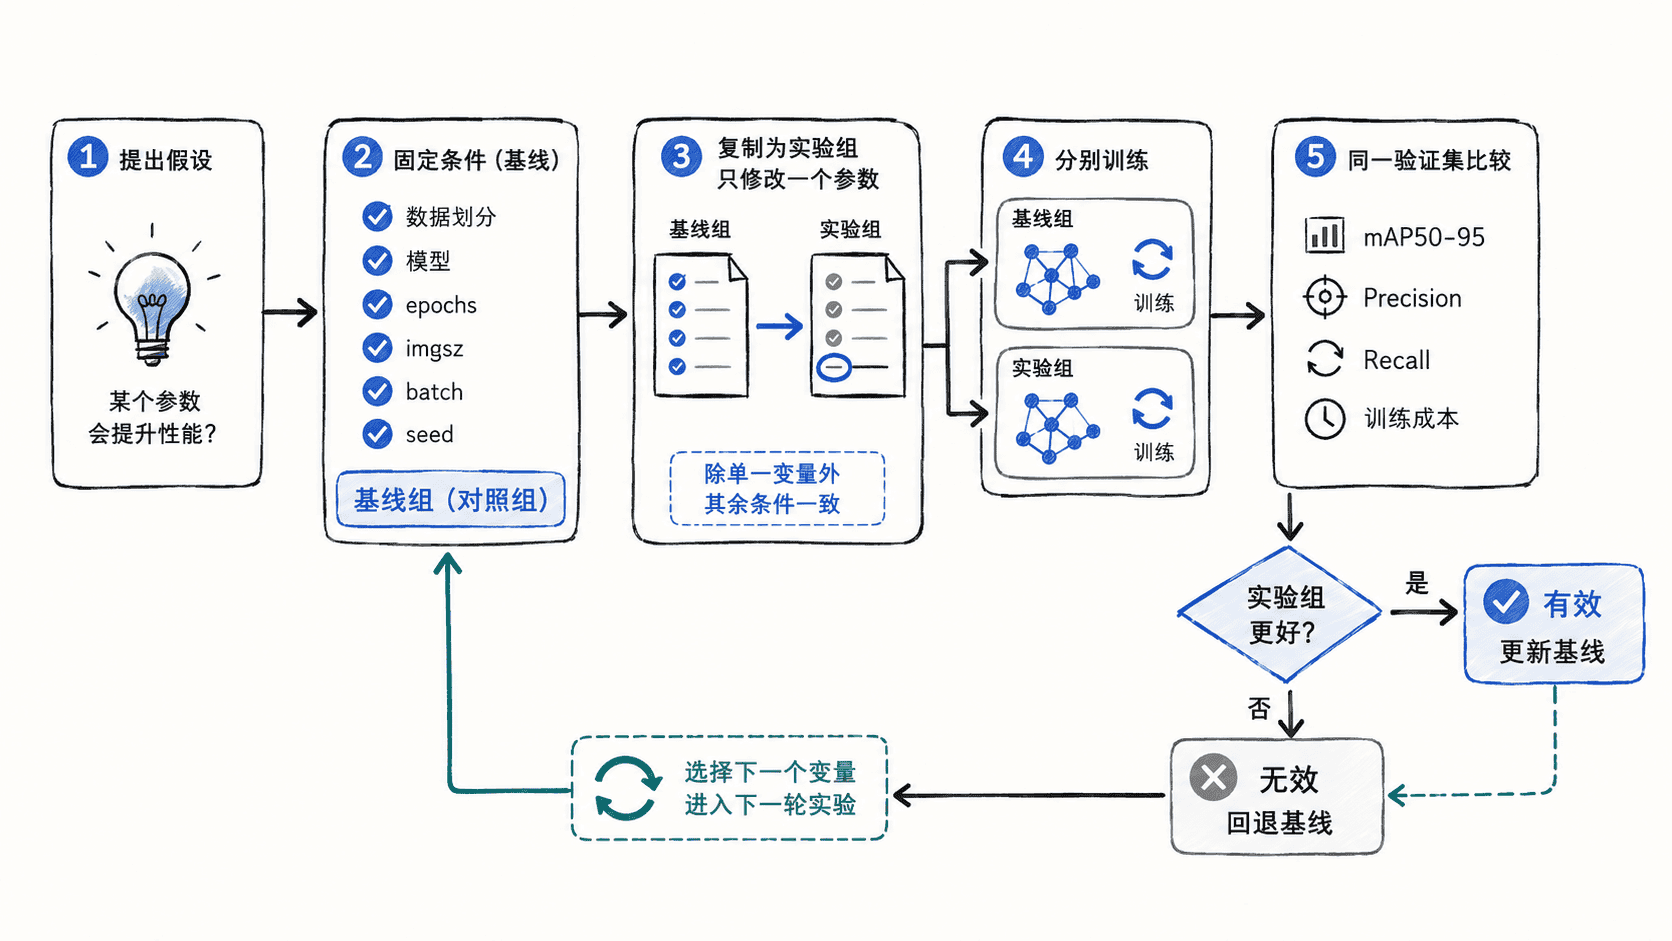
为了减少偶然性,关键候选参数最好使用多个随机种子重复训练。例如同一配置分别用 42、43、44 三个种子运行,再比较指标均值和波动。如果一次训练提升 0.3 个百分点,但不同种子间波动达到 1 个百分点,这个提升很可能不足以支持结论。
判断“变好”是否真的有价值
不要只盯一个总指标。检测任务中,mAP 提升可能伴随 Recall 下降,或者精度提升却显著增加训练时间和显存占用。对照时应先定义主指标,再同时观察业务相关的副指标和资源成本。
例如漏检代价很高的场景,可把 Recall 作为必须守住的约束;误报代价高的场景,则要重点检查 Precision。若模型精度只小幅提升,却让推理速度明显下降,也未必值得采用。
最终你需要得到的不是一串“试过的参数”,而是一条可解释的证据链:基线是什么、只改了什么、指标怎样变化、波动是否可接受,以及为什么保留或放弃这个改动。