
计算机视觉 / 系统课时
转换常见标注格式
转换常见标注格式
训练 YOLO 前,真正需要统一的不是文件扩展名,而是类别编号、边界框坐标语义和归一化规则。本节用一个可运行脚本把 VOC 与 COCO 检测标注转换成 YOLO 文本标签,并说明如何验证结果,避免“格式能读但框已错位”。
学习目标
- 说清 VOC、COCO 与 YOLO 三种检测框坐标的差异
- 将 VOC XML 和 COCO JSON 批量转换为 YOLO 标签
- 通过数量、范围与抽查验证转换是否可靠
先统一 YOLO 标签规则
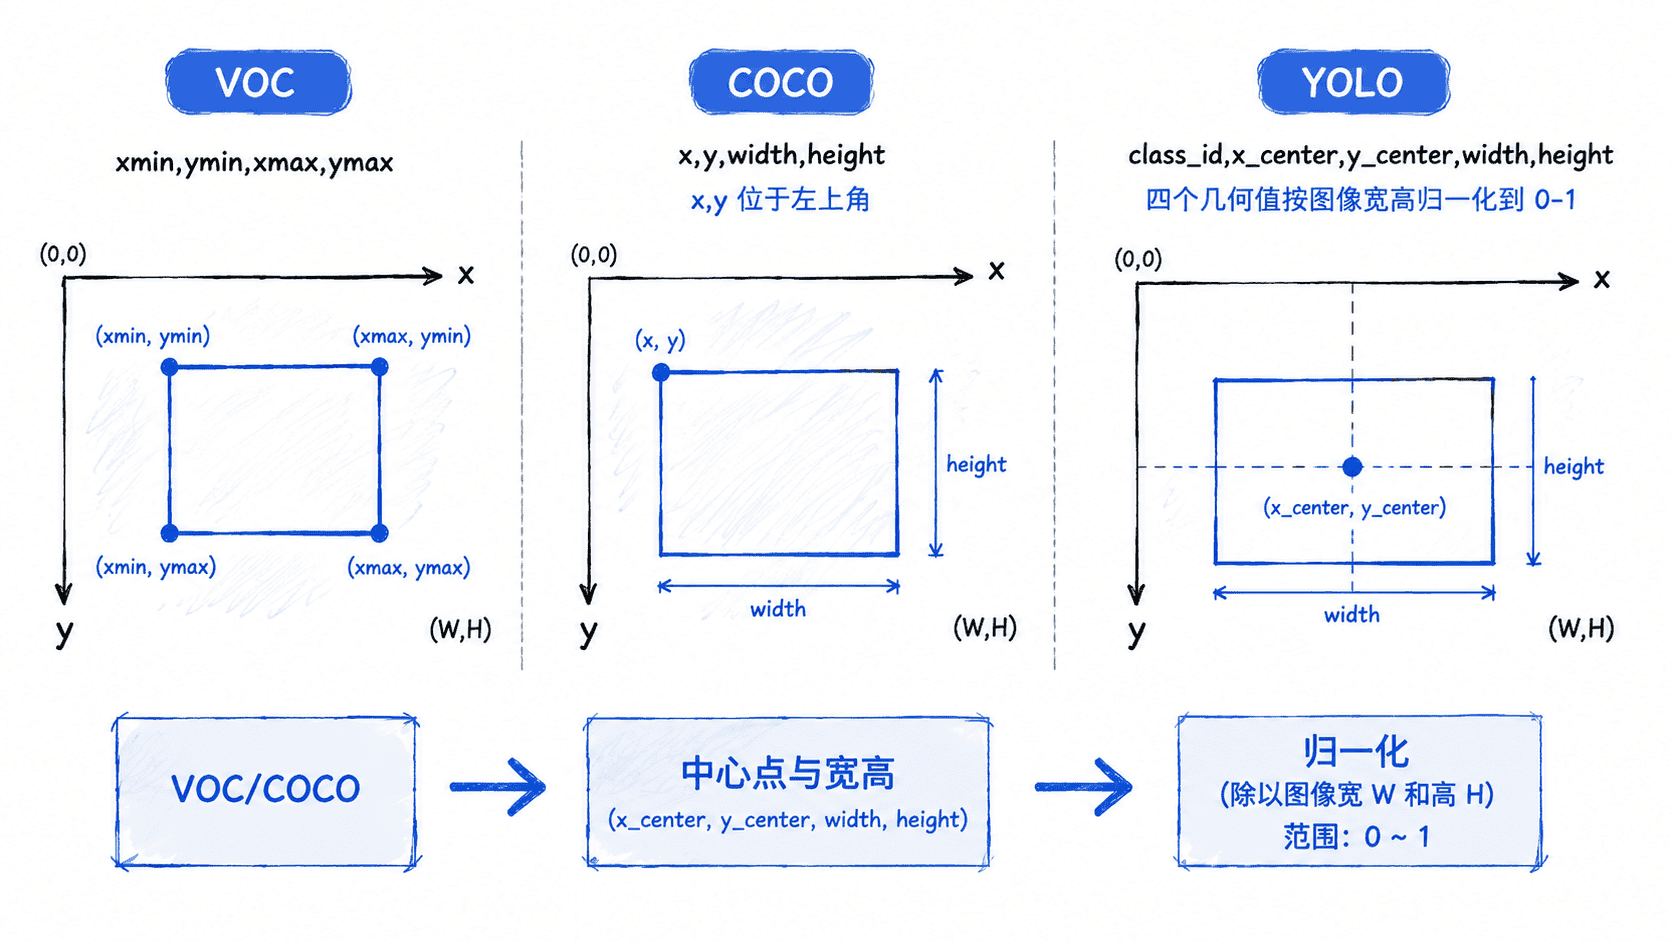
YOLO 检测标签通常按“一张图片一个同名 .txt 文件”组织,每一行描述一个目标:
<class_id> <x_center> <y_center> <width> <height>其中四个坐标都要按图像宽高归一化到 0~1。类别编号从 0 开始,并且训练、验证、推理阶段必须使用同一份类别顺序。
VOC 常用 (xmin, ymin, xmax, ymax);COCO 的 bbox 使用 (x, y, width, height),其中 (x, y) 是左上角。二者都要先换算成中心点表示,再归一化。
用脚本完成批量转换
下面的脚本同时支持 VOC 与 COCO。VOC 模式通过 classes.txt 固定类别顺序;COCO 模式按 categories 中的类别 ID 排序后重新映射为从 0 开始的连续编号,并输出同样的 classes.txt。
import argparse
import json
import xml.etree.ElementTree as ET
from collections import defaultdict
from pathlib import Path

def to_yolo(x1, y1, x2, y2, image_w, image_h):
    # 在归一化前拒绝零面积框和越界框,避免把坏标注静默带入训练集。
    if image_w <= 0 or image_h <= 0:
        return None
    if x1 < 0 or y1 < 0 or x2 > image_w or y2 > image_h:
        return None
    if x2 <= x1 or y2 <= y1:
        return None

    cx = (x1 + x2) / 2 / image_w
    cy = (y1 + y2) / 2 / image_h
    bw = (x2 - x1) / image_w
    bh = (y2 - y1) / image_h
    return cx, cy, bw, bh

def convert_voc(input_dir, output_dir, classes_file):
    class_names = [
        line.strip()
        for line in Path(classes_file).read_text(encoding="utf-8").splitlines()
        if line.strip()
    ]
    class_to_id = {name: idx for idx, name in enumerate(class_names)}
    converted = 0

    for xml_path in sorted(Path(input_dir).glob("*.xml")):
        root = ET.parse(xml_path).getroot()
        image_w = int(root.findtext("size/width"))
        image_h = int(root.findtext("size/height"))
        lines = []

        for obj in root.findall("object"):
            name = obj.findtext("name")
            if name not in class_to_id:
                raise ValueError(f"unknown VOC class: {name}")
            box = obj.find("bndbox")
            x1 = float(box.findtext("xmin"))
            y1 = float(box.findtext("ymin"))
            x2 = float(box.findtext("xmax"))
            y2 = float(box.findtext("ymax"))
            normalized = to_yolo(x1, y1, x2, y2, image_w, image_h)
            if normalized is None:
                raise ValueError(f"invalid box in {xml_path.name}")
            cx, cy, bw, bh = normalized
            lines.append(
                f"{class_to_id[name]} {cx:.6f} {cy:.6f} {bw:.6f} {bh:.6f}"
            )

        (Path(output_dir) / f"{xml_path.stem}.txt").write_text(
            "\n".join(lines) + ("\n" if lines else ""), encoding="utf-8"
        )
        converted += 1

    (Path(output_dir) / "classes.txt").write_text(
        "\n".join(class_names) + "\n", encoding="utf-8"
    )
    return converted

def convert_coco(json_file, output_dir):
    data = json.loads(Path(json_file).read_text(encoding="utf-8"))
    categories = sorted(data["categories"], key=lambda item: item["id"])
    category_to_class = {item["id"]: idx for idx, item in enumerate(categories)}
    images = {item["id"]: item for item in data["images"]}
    annotations = defaultdict(list)

    for ann in data["annotations"]:
        annotations[ann["image_id"]].append(ann)

    for image_id, image in images.items():
        lines = []
        for ann in annotations.get(image_id, []):
            x, y, w, h = ann["bbox"]
            normalized = to_yolo(
                x, y, x + w, y + h, image["width"], image["height"]
            )
            if normalized is None:
                raise ValueError(f"invalid box in image_id={image_id}")
            cx, cy, bw, bh = normalized
            class_id = category_to_class[ann["category_id"]]
            lines.append(f"{class_id} {cx:.6f} {cy:.6f} {bw:.6f} {bh:.6f}")

        stem = Path(image["file_name"]).stem
        (Path(output_dir) / f"{stem}.txt").write_text(
            "\n".join(lines) + ("\n" if lines else ""), encoding="utf-8"
        )

    class_names = [item["name"] for item in categories]
    (Path(output_dir) / "classes.txt").write_text(
        "\n".join(class_names) + "\n", encoding="utf-8"
    )
    return len(images)

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--format", choices=["voc", "coco"], required=True)
    parser.add_argument("--input", required=True)
    parser.add_argument("--output", required=True)
    parser.add_argument("--classes")
    args = parser.parse_args()

    output_dir = Path(args.output)
    output_dir.mkdir(parents=True, exist_ok=True)

    if args.format == "voc":
        if not args.classes:
            parser.error("--classes is required for VOC")
        count = convert_voc(args.input, output_dir, args.classes)
    else:
        count = convert_coco(args.input, output_dir)

    print(f"converted_images={count}")
    print(f"output_dir={output_dir}")

if __name__ == "__main__":
    main()
VOC 转换命令:
python convert_to_yolo.py --format voc --input <PATH>/Annotations --output <PATH>/labels --classes <PATH>/classes.txt预期输出:
converted_images=<VALUE>
output_dir=<PATH>/labels
COCO 转换命令:
python convert_to_yolo.py --format coco --input <PATH>/annotations/instances_train.json --output <PATH>/labels预期输出:
converted_images=<VALUE>
output_dir=<PATH>/labels
<PATH> 与 <VALUE> 会随数据集实际位置和图片数量变化。
验证转换后的标签
不要只确认“生成了 txt 文件”。至少检查标签文件数量是否与图片对应、每行是否恰好 5 列、四个坐标是否处于 0~1 且宽高大于 0。抽查一条标签时,还要把它还原到原图确认框的位置没有偏移。
例如标签:
2 0.512500 0.437500 0.225000 0.350000它表示类别 ID 为 2,目标中心位于图像宽度约 51.25%、高度约 43.75% 的位置,框宽约占 22.5%,框高约占 35%。
处理边界与异常标注
脚本遇到零面积框、越界框或未知类别时直接报错,而不是悄悄丢弃。这更适合训练数据准备,因为异常若被静默忽略,往往要到训练指标异常时才暴露。
COCO 中还可能出现 iscrowd、分割掩码或非连续类别 ID。只做目标检测时,要先明确哪些标注需要保留,再把原始类别映射为连续 YOLO 类别编号。部分 VOC 导出工具还可能采用不同的像素坐标约定,若抽查发现固定 1 像素偏移,应以原始标注工具的定义为准,而不是盲目统一加减 1。