
计算机视觉 / 系统课时
调整学习率策略
调整学习率策略
学习率决定模型每次更新参数时迈多大一步:过高容易震荡甚至发散,过低则收敛缓慢。本节用一组可复现的 YOLO 训练参数说明初始学习率、预热与衰减如何配合,并给出根据训练曲线调整的顺序。
学习目标
- 说明
lr0、warmup_epochs、lrf的作用和相互关系 - 配置余弦学习率衰减并验证训练是否按预期启动
- 根据损失和验证指标判断学习率过高或过低
理解三段学习率过程
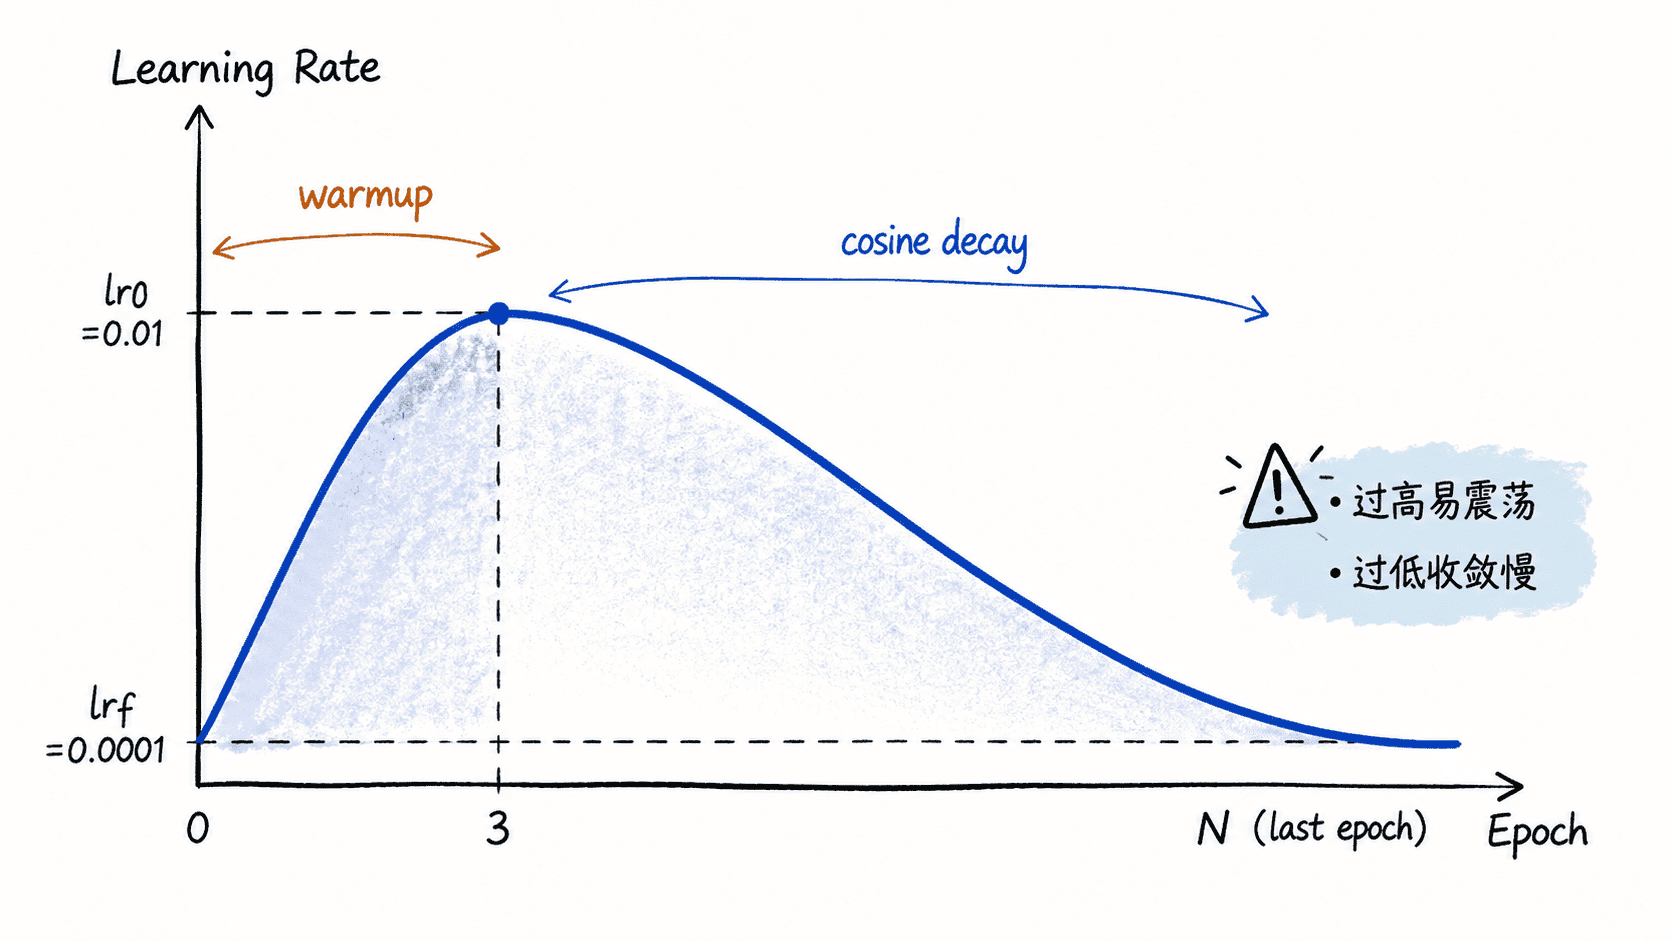
以 Ultralytics YOLO 为例,lr0 是正常训练阶段使用的基准初始学习率,warmup_epochs 控制前若干轮的预热,lrf 表示训练末期相对 lr0 的倍率。若 lr0=0.01、lrf=0.01,末期目标学习率约为 0.0001。
预热阶段会从较保守的更新幅度逐步过渡到正常学习率,目的是减少训练刚开始时的大幅参数跳动。进入正常阶段后,再通过线性或余弦方式逐步降低学习率,使后期更新更细。
固定优化器做一次基线训练
为了让 lr0 的意义稳定,示例显式指定 SGD,避免某些版本在自动选择优化器时改变学习率设置。把 <PATH> 替换为自己的数据集配置路径。
# 固定优化器和学习率策略,便于后续只比较一个变量
yolo detect train model=yolo11n.pt data=<PATH>/data.yaml epochs=100 optimizer=SGD lr0=0.01 lrf=0.01 warmup_epochs=3 cos_lr=True imgsz=640 batch=16 device=0
预期结果:
训练任务成功启动。
前 3 个 epoch 执行 warmup,之后进入余弦学习率衰减。
初始基准学习率:0.01
训练末期目标学习率约:0.0001
训练结果目录:<PATH>
实际日志格式、耗时和输出路径会随版本与环境变化,验证重点是训练参数被接受、训练能够持续进行,并能在结果目录中查看损失和验证指标曲线。
根据训练现象决定调整方向
学习率过高时,常见现象是训练损失剧烈波动、验证指标忽高忽低,严重时出现 nan。此时先把 lr0 降低 2~10 倍,例如从 0.01 改为 0.005 或 0.001,不要同时修改批次、图像尺寸和增强策略。
学习率过低时,训练往往很稳定,但损失下降慢,很多 epoch 后指标仍缓慢改善。此时可以小幅提高 lr0,或者在总 epoch 不变时缩短过长的预热阶段。
保持单变量调参
如果只有前几轮不稳定、后面正常,优先调整 warmup_epochs;如果整个训练过程都明显震荡,优先降低 lr0;如果前期收敛正常但后期仍反复波动,可以减小 lrf,让末期学习率更低。
每次实验固定模型、数据划分、batch、imgsz 和增强策略,只改一个学习率主变量,并比较最终 mAP、最佳 epoch、收敛速度和损失曲线。目标不是让曲线看起来最平滑,而是在相同训练预算下得到稳定且更高的验证性能。