
计算机视觉 / 系统课时
设计类别体系
设计类别体系
YOLO 能否稳定识别目标,很大程度上取决于类别是否定义得足够清楚。本节从业务目标出发,把模糊的对象名称整理成互斥、可观察、可执行的标注类别,并提前处理容易产生分歧的边界情况。
学习目标
- 根据模型任务确定合理的类别粒度
- 为每个类别写出可执行的包含与排除规则
- 识别类别重叠、命名含糊和标注者无法判断的问题
先确定模型真正需要区分什么
设计类别时,不要先问“数据里有什么”,而要先问“模型输出之后要支持什么决策”。如果业务只需要判断画面中有没有车辆,把汽车、SUV 和轿车拆成多个类别只会增加数据压力;如果后续流程需要分别统计卡车和小客车,则必须保留相应区分。
类别粒度应满足两个条件:业务确实需要区分,并且标注者能够仅凭图像稳定判断。无法从视觉上可靠区分的属性,不适合作为目标检测类别。例如仅凭普通外观通常无法判断一辆车是“公司车辆”还是“私人车辆”。
让类别彼此互斥
最常见的问题不是类别数量太少,而是两个名称覆盖了同一个对象。例如同时定义“车辆”“汽车”“轿车”,同一辆轿车可能符合三个类别,标注结果必然依赖标注者个人理解。
设计时可以把每个候选类别放进同一套判断流程:先判断对象属于哪个上层概念,再根据视觉特征进入唯一的叶子类别。如果一个对象可以同时抵达两个最终类别,就说明边界仍需重写。
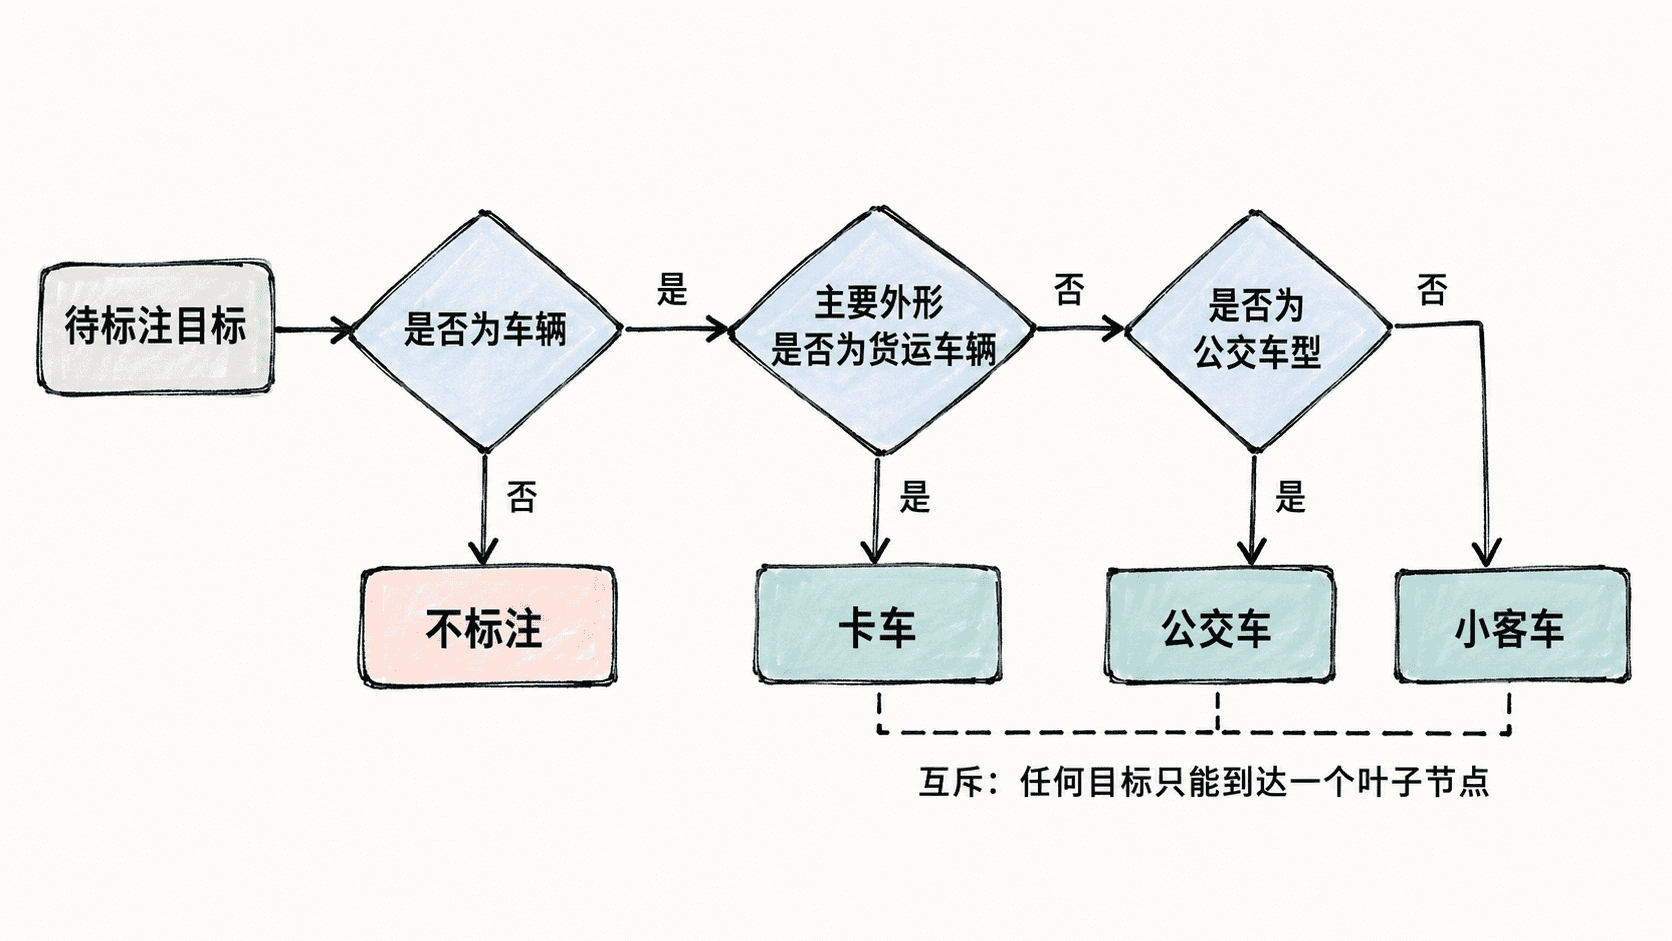
如果项目确实需要“车辆”这个上层概念,更合适的做法通常是由业务端把多个细分类聚合,而不是在同一检测任务中同时标注父类和子类。
给每个类别写边界规则
类别名称只是标签,真正决定一致性的是标注规范。每个类别至少要明确“包含什么”“不包含什么”和“遇到边界案例怎么处理”。
| 类别 | 包含规则 | 排除规则 |
|---|---|---|
| 小客车 | 轿车、SUV、MPV 等以载客为主的普通道路车辆 | 公交车、货车、工程车辆 |
| 公交车 | 具有明显公共客运车身结构的大中型车辆 | 普通面包车、小型 MPV |
| 卡车 | 具有货箱、货柜或明显货运结构的车辆 | 皮卡是否归入此类需在项目开始前单独约定 |
对“皮卡算不算卡车”这类问题,没有脱离业务背景的唯一正确答案。重要的是项目开始前确定一种规则,并让所有标注人员使用同一规则。
用标注可执行性检查类别
完成初稿后,可以随机抽取几十张真实图片,让两名标注者独立分类。如果同一对象频繁得到不同标签,优先检查类别定义,而不是简单要求标注者“更认真”。
还应检查类别名称是否短而稳定。训练配置、标注平台和推理结果都将长期引用这些名称,因此不要交替使用“car”“汽车”“小汽车”等同义标签表达同一类别。
冻结类别后再开始大规模标注
在大批量采集和标注之前,先用一小批代表性数据完成类别试标,并记录所有有争议的案例。只有当主要对象都能够被稳定地放入唯一类别,类别名称和边界才适合冻结。
后续如果必须新增或拆分类别,应把它当成数据集版本变更处理,并评估已有标注是否需要返工。一个清晰、稳定的类别体系,通常比在训练阶段不断调整模型参数更能直接提升数据质量。