
计算机视觉 / 系统课时
清理损坏与低质图像
清理损坏与低质图像
训练前先把无法读取、严重模糊、过曝欠曝和近乎空白的样本隔离出来,能避免数据加载报错,也能减少模型把无效视觉模式当成特征。本课用一套可复现的脚本完成初筛,再通过人工复核决定最终删除哪些图像。
学习目标
- 用程序识别无法解码、尺寸异常、严重模糊和曝光异常的图像
- 建立低质图像候选清单,并采用隔离复核而非直接删除的策略
- 理解质量阈值为什么必须结合自己的采集设备与场景校准
先定义什么算“需要清理”
YOLO 训练并不要求每张图都完美,但要求图像能被稳定读取,并且主体信息足以支撑标注。最常见的四类问题是:文件损坏导致解码失败;运动抖动或失焦造成严重模糊;整体亮度接近纯黑或纯白;画面几乎没有纹理,例如空白帧、纯色占位图或镜头被遮挡。
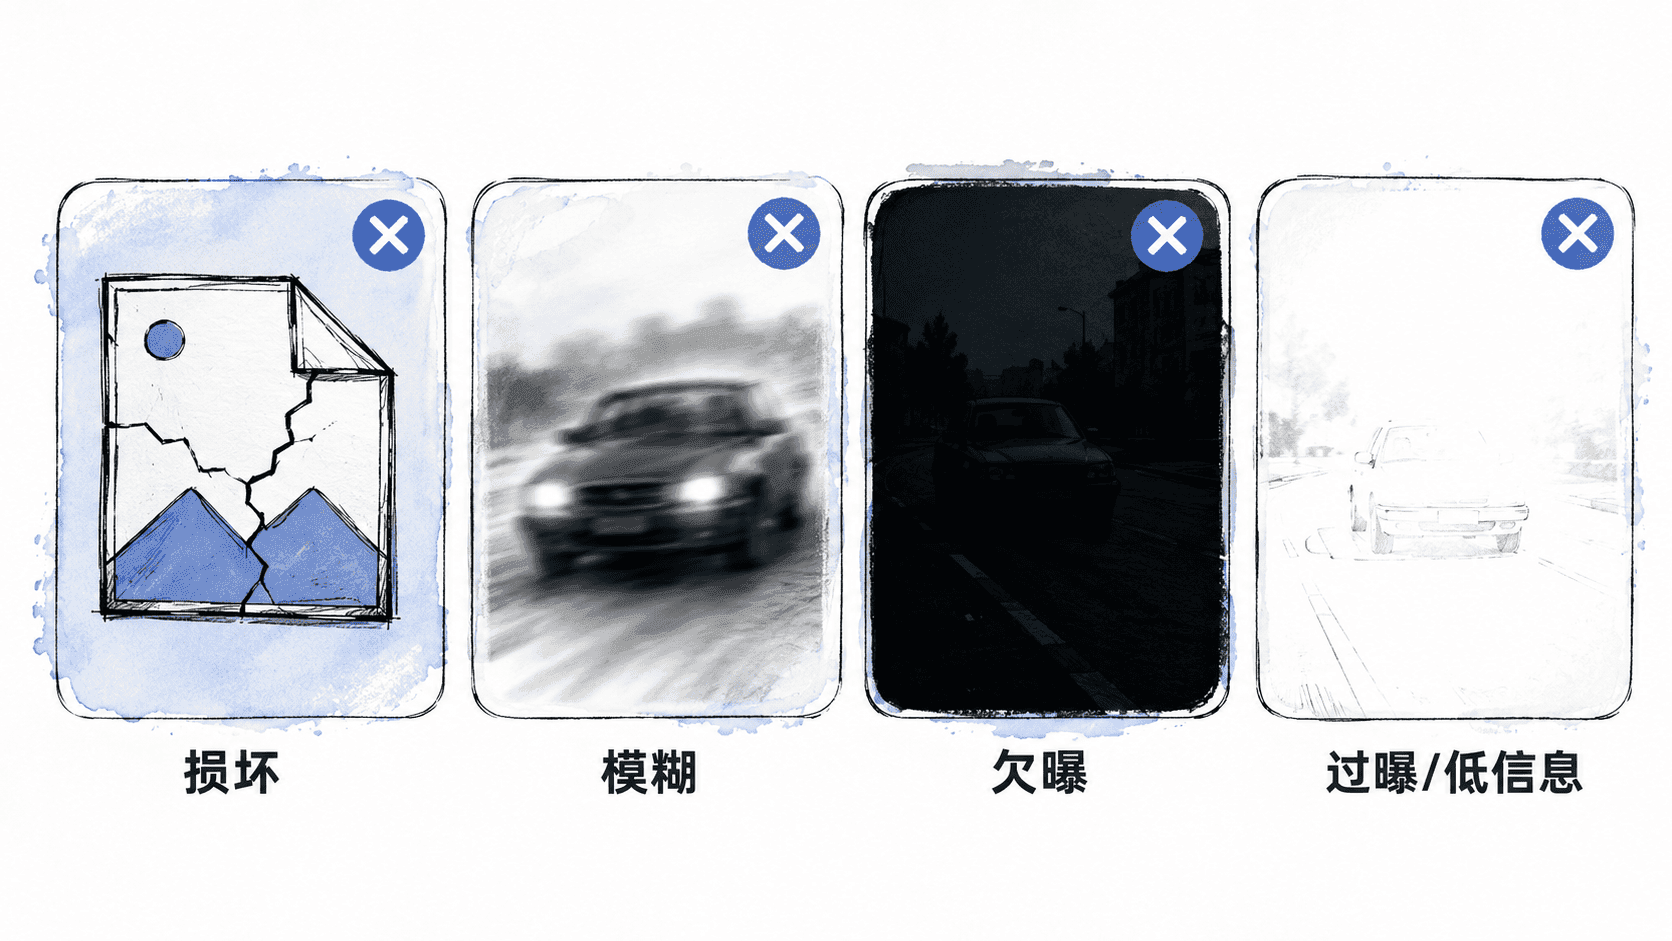
自动规则适合做“候选筛查”,不适合直接替代人工判断。例如夜间数据本来就偏暗,细小目标图像也可能天然纹理较少。因此更稳妥的流程是先打标签和隔离,再抽样复核阈值是否误伤有效数据。
用脚本批量筛查
下面的脚本使用 Pillow 验证图像能否完整解码,再用 OpenCV 计算灰度均值、灰度标准差和拉普拉斯方差。拉普拉斯方差越低,通常说明图像越模糊;灰度均值过低或过高,可用于发现严重欠曝和过曝;标准差极低则常见于纯色或近乎空白画面。
先安装依赖:
python -m pip install pillow opencv-python numpy预期结果:命令成功结束后,当前 Python 环境能够导入 PIL、cv2 和 numpy。安装日志中的版本号与包数量会因环境不同而变化。
保存下面脚本为 scan_quality.py:
from pathlib import Path
from PIL import Image
import cv2
import numpy as np

IMAGE_DIR = Path("images")
MIN_WIDTH = 320
MIN_HEIGHT = 320
BLUR_THRESHOLD = 60.0
DARK_THRESHOLD = 25.0
BRIGHT_THRESHOLD = 235.0
LOW_CONTRAST_STD = 8.0

def inspect_image(path: Path) -> list[str]:
    reasons = []
    try:
        with Image.open(path) as img:
            img.verify()
        with Image.open(path) as img:
            rgb = np.array(img.convert("RGB"))
    except Exception:
        return ["decode_failed"]

    height, width = rgb.shape[:2]
    if width < MIN_WIDTH or height < MIN_HEIGHT:
        reasons.append("too_small")

    gray = cv2.cvtColor(rgb, cv2.COLOR_RGB2GRAY)
    mean = float(gray.mean())
    std = float(gray.std())
    blur_score = float(cv2.Laplacian(gray, cv2.CV_64F).var())

    if blur_score < BLUR_THRESHOLD:
        reasons.append("severe_blur")
    if mean < DARK_THRESHOLD:
        reasons.append("underexposed")
    if mean > BRIGHT_THRESHOLD:
        reasons.append("overexposed")
    if std < LOW_CONTRAST_STD:
        reasons.append("low_information")

    return reasons

for path in sorted(IMAGE_DIR.rglob("*")):
    if not path.is_file():
        continue
    reasons = inspect_image(path)
    if reasons:
        print(f"{path}\t{','.join(reasons)}")
运行:
python scan_quality.py预期输出:
images/broken.jpg	decode_failed
images/frame_0182.jpg	severe_blur
images/frame_0310.jpg	underexposed,low_information
实际文件名和命中的规则会随数据集变化;如果没有任何输出,表示当前阈值下没有发现候选问题图像。
校准阈值而不是照搬数值
BLUR_THRESHOLD、亮度阈值和最低尺寸都只是起点。最实用的做法是先随机抽取一批已知“可用”和“不可用”图像,运行脚本记录分数,再选择能把两类样本较好分开的阈值。不同镜头、分辨率、压缩率和场景光照都会改变分数分布。
对于被命中的样本,优先移动到 quarantine/ 一类隔离目录并保留原相对路径,同时记录原因。确认误报率可接受后再统一删除,能够避免一次错误阈值把稀有场景全部清掉。
清洗后的验收标准
清洗完成后至少检查三件事:训练目录中的文件都能正常解码;随机抽样不再出现明显空白帧、严重失焦或极端曝光;隔离样本中没有集中出现某个重要场景。最后再核对对应标注文件,避免删图后留下孤立的 .txt 标签。
如果低质图像只是少量噪声,可以直接移出训练集;如果某类低质图像代表真实部署条件,就应优先改善采集和标注,而不是通过清洗把这一类场景从数据分布中抹掉。