
计算机视觉 / 系统课时
继续训练已有模型
继续训练已有模型
已有权重可以用于两种完全不同的继续训练方式:恢复一次被中断的训练,或把现有权重当作新任务的初始化重新微调。两者都会“从 .pt 开始”,但恢复的状态、可修改的参数和适用场景不同,选错会让实验不可复现。
学习目标
- 区分恢复训练与重新微调的状态边界
- 使用已有 checkpoint 正确执行两种继续训练方式
- 根据数据集和训练目标变化选择合适路径并完成验证
先判断是恢复还是重新微调
恢复训练面向“同一次训练没有跑完”。它应继续使用原 run 的 checkpoint,并恢复训练进度相关状态。重新微调则面向“已有模型不错,但现在要换数据、训练策略或实验目标”,它会创建一个新的训练会话。
| 判断项 | 恢复训练 | 重新微调 |
|---|---|---|
| 典型权重 | last.pt |
best.pt、last.pt 或其他预训练权重 |
| 训练状态 | 延续原 optimizer、scheduler、epoch 等状态 | 新建训练状态,已有权重只作为参数初始化 |
| 数据与关键配置 | 应保持原实验一致 | 可以显式换数据、epoch、增强和其他参数 |
| 主要用途 | 断电、超时、进程异常后续跑 | 新数据迭代、域适配、二次优化 |
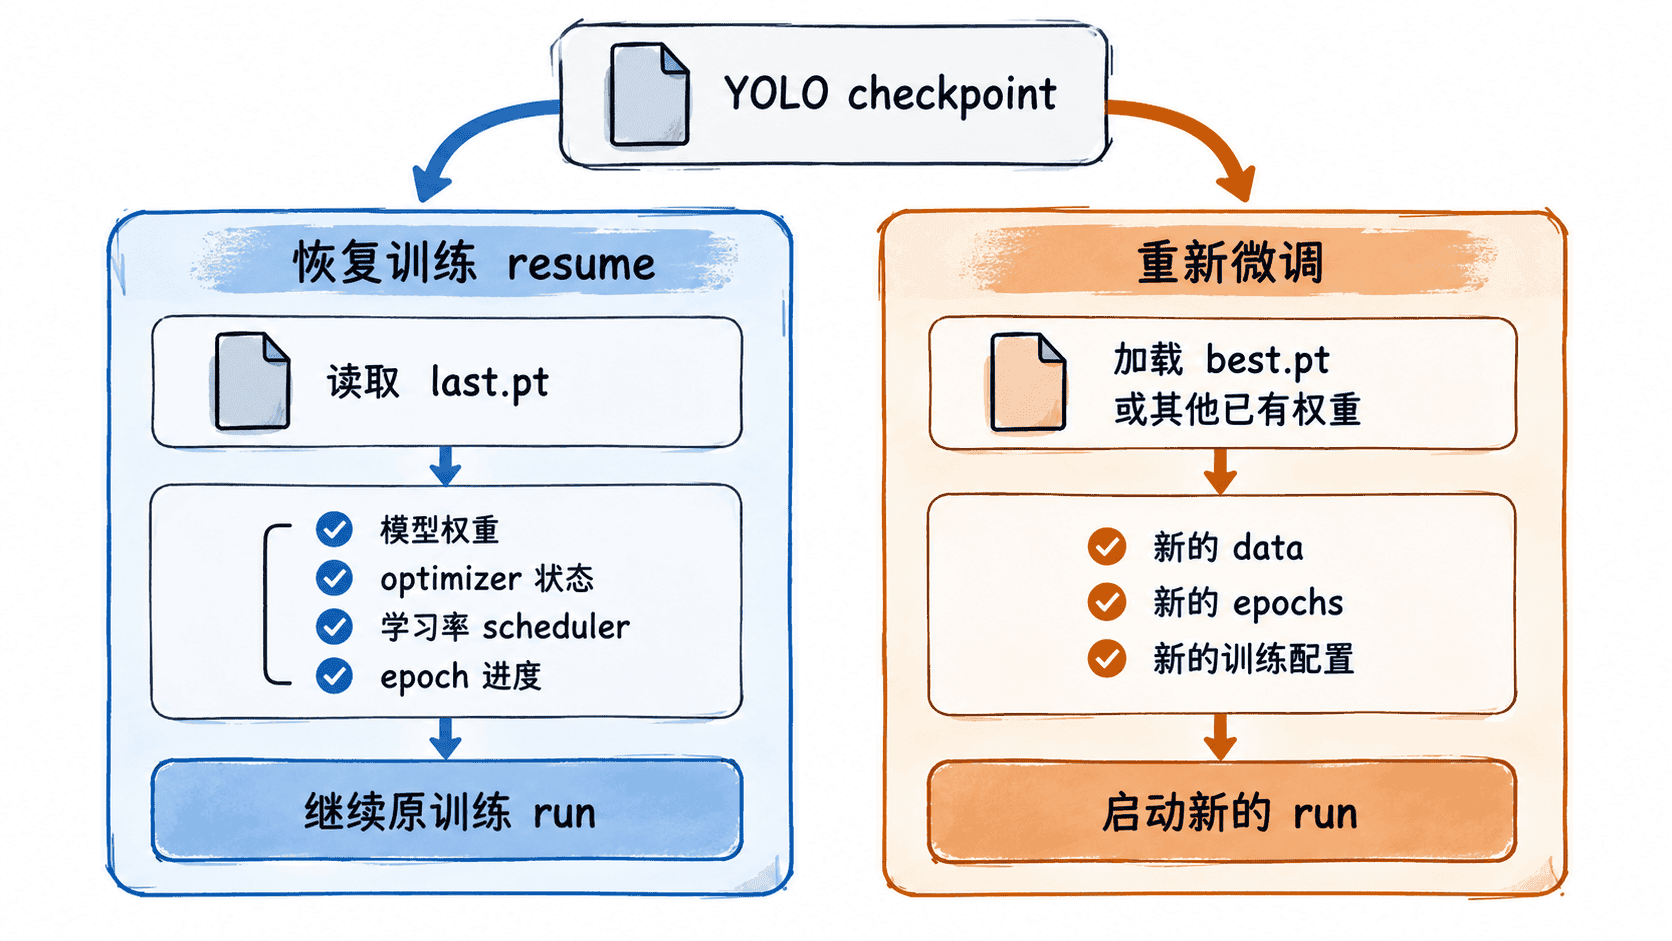
恢复被中断的训练
恢复训练应指向原 run 的 last.pt。下面命令继续 checkpoint 中记录的训练进度;<PATH> 替换为实际输出目录。
yolo train resume model=<PATH>/weights/last.pt预期输出:
Resuming training <PATH>/weights/last.pt from epoch <ID> to <ID> total epochs实际 epoch 数取决于 checkpoint。恢复时会继续原训练状态,因此它适合机器重启、进程异常或训练任务被中断后的续跑。
用已有权重重新微调
数据迭代后新增了样本、改变了类别分布,或者希望重新设置训练轮数与其他参数时,应把已有模型作为初始化权重启动新 run。下面示例使用 best.pt 在新的数据配置上训练 30 个 epoch。
yolo train model=<PATH>/weights/best.pt data=<PATH>/data.yaml epochs=30 imgsz=640 project=<PATH>/runs name=finetune-v2预期输出:
30 epochs completed in <TIME>.
Results saved to <PATH>/runs/finetune-v2
<TIME> 与实际硬件、数据规模有关。新的 run 应生成独立结果和权重,这样旧模型仍可作为基线,不会与本轮实验混在一起。
不要把两种路径混用
恢复训练的价值是“接着原来的状态继续”,因此应优先保持原数据版本、类别定义和关键训练配置不变。如果类别数量、标签映射或数据语义已经改变,就不再是单纯续跑,更适合重新微调。
重新微调则允许重新定义数据、epoch、增强和其他训练策略,但也意味着优化器与学习率进度按新会话重新开始。只有权重文件、却没有可恢复的完整训练状态时,也应把它视为参数初始化,而不是严格意义上的断点恢复。
用同一验证集完成验收
恢复训练主要检查 epoch 是否从既有进度继续、指标曲线是否衔接;重新微调则应把旧模型和新模型放到同一验证集上比较总体与按类别的 Precision、Recall、mAP50-95。
当只是机器重启或训练意外中断时选择恢复训练;当数据、类别语义或优化目标发生变化时选择重新微调。把这条边界守住,后续每次模型迭代才有清晰的因果关系。