
计算机视觉 / 系统课时
理解训练数据增强
理解训练数据增强
数据增强不是简单把训练图片“变花”,而是在标签仍然正确的前提下,主动制造合理变化,让 YOLO 学到目标本身而不是固定的光照、位置和背景。本课重点判断哪些变化有帮助,以及增强过度时会怎样破坏训练数据。
学习目标
- 理解颜色、缩放、翻转、裁剪和组合增强分别改变什么
- 判断增强后图像与检测标签是否仍保持一致
- 识别不符合业务场景的过度增强
增强的本质是扩大合理变化范围
假设训练集中汽车几乎都位于画面中央、天气晴朗。如果直接训练,模型可能把“中央位置”和“明亮颜色”也当成识别汽车的重要线索。增强会随机改变这些非本质因素,使同一目标以更多合理形态出现。
关键不是变化越大越好,而是增强后的样本仍应属于真实部署环境可能遇到的数据分布。增强扩大的是合理变化范围,不是无限制造异常图片。
常见增强分别改变什么
| 增强方式 | 主要改变 | 常见收益 | 主要风险 |
|---|---|---|---|
| 颜色 | 色相、饱和度、亮度 | 适应光照与相机差异 | 颜色本身是类别特征时可能破坏语义 |
| 缩放 | 目标在画面中的相对尺寸 | 提高远近目标适应性 | 目标过小后几乎失去有效特征 |
| 翻转 | 左右或上下方向 | 减少固定方向偏差 | 方向具有业务含义时产生错误样本 |
| 裁剪 | 可见区域与目标完整度 | 模拟遮挡和边缘目标 | 目标被截断过多但标签仍被保留 |
| 组合 | 多张图的目标与背景关系 | 增加密度、尺度和场景变化 | 生成现实中几乎不会出现的组合 |
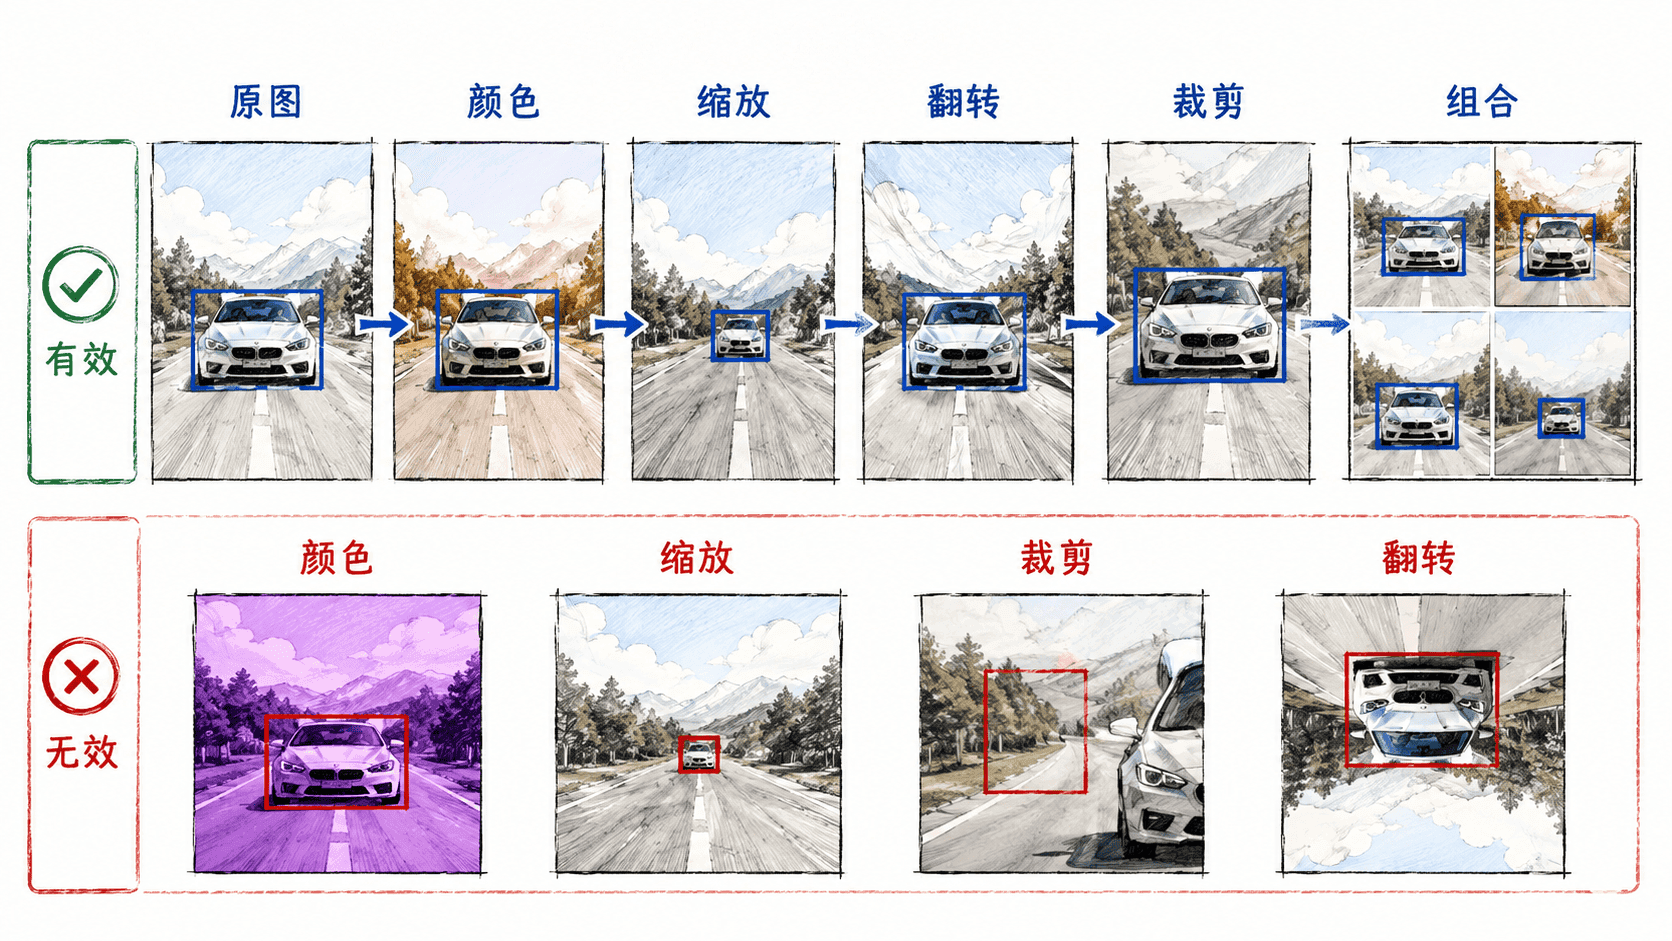
几何增强必须同步更新标签
颜色变化通常不会改变检测框的位置,但缩放、翻转和裁剪会改变目标坐标。只变图片、不变标注,会产生典型的“标签漂移”:模型看到目标在新位置,却被要求预测旧位置的框。
裁剪还需要额外判断目标剩余比例。目标只剩一个很小的局部时,即使数学上还能计算边界框,也未必还是有意义的正样本。训练框架可以自动完成坐标变换,但业务上是否合理仍需要人工抽样检查。
语义不变比几何合法更重要
一个增强在坐标上正确,不代表在业务上正确。道路监控中的汽车通常可以左右翻转,但带有固定文字方向的标志、具有上下方向的仪表界面,或者类别由颜色区分的产品,都可能因为翻转或颜色扰动改变原本语义。
因此判断增强时应先问:变换之后,人仍会给它标成同一个类别吗? 如果答案不稳定,这种增强就不应该仅因为框架支持而开启。
组合增强要防止脱离真实场景
Mosaic、MixUp 等组合方式可以快速增加目标数量、尺度和背景组合,对小目标或数据量有限的场景尤其有吸引力。但组合比例过高时,模型长期看到人工拼接边界、异常遮挡或不自然的物体密度,也可能学到新的伪特征。
实际使用时应定期抽样查看增强后的训练图像,并同时检查目标类别、边界框、可见比例和场景合理性。只要增强开始大量制造“部署时不会出现”的图像,它就已经从正则化手段变成了新的数据噪声。