
单片机与物联网 / 系统课时
异常恢复设计
异常恢复设计
本课解决外设偶发超时、通信失败或数据异常时系统被拖死的问题:用有限超时、受控重试、默认值、错误码和降级状态,把故障限制在局部并保留自动恢复能力。
学习目标
- 为外设访问设置明确的超时和重试边界
- 使用错误码与状态机区分临时故障和持续故障
- 设计默认值、降级运行和周期性恢复探测
先定义可恢复边界
异常恢复不是“失败后一直重试”。每次外设调用都必须有结束条件,重试也必须有次数、间隔和退出路径。否则一个失联的传感器就可能长期占用 CPU、阻塞主循环,并导致看门狗复位。
建议把处理分为五步:单次操作超时、记录错误码、短间隔有限重试、超过阈值进入降级、在较长间隔后重新探测。业务代码只读取当前有效值和设备状态,不直接承担底层重试细节。
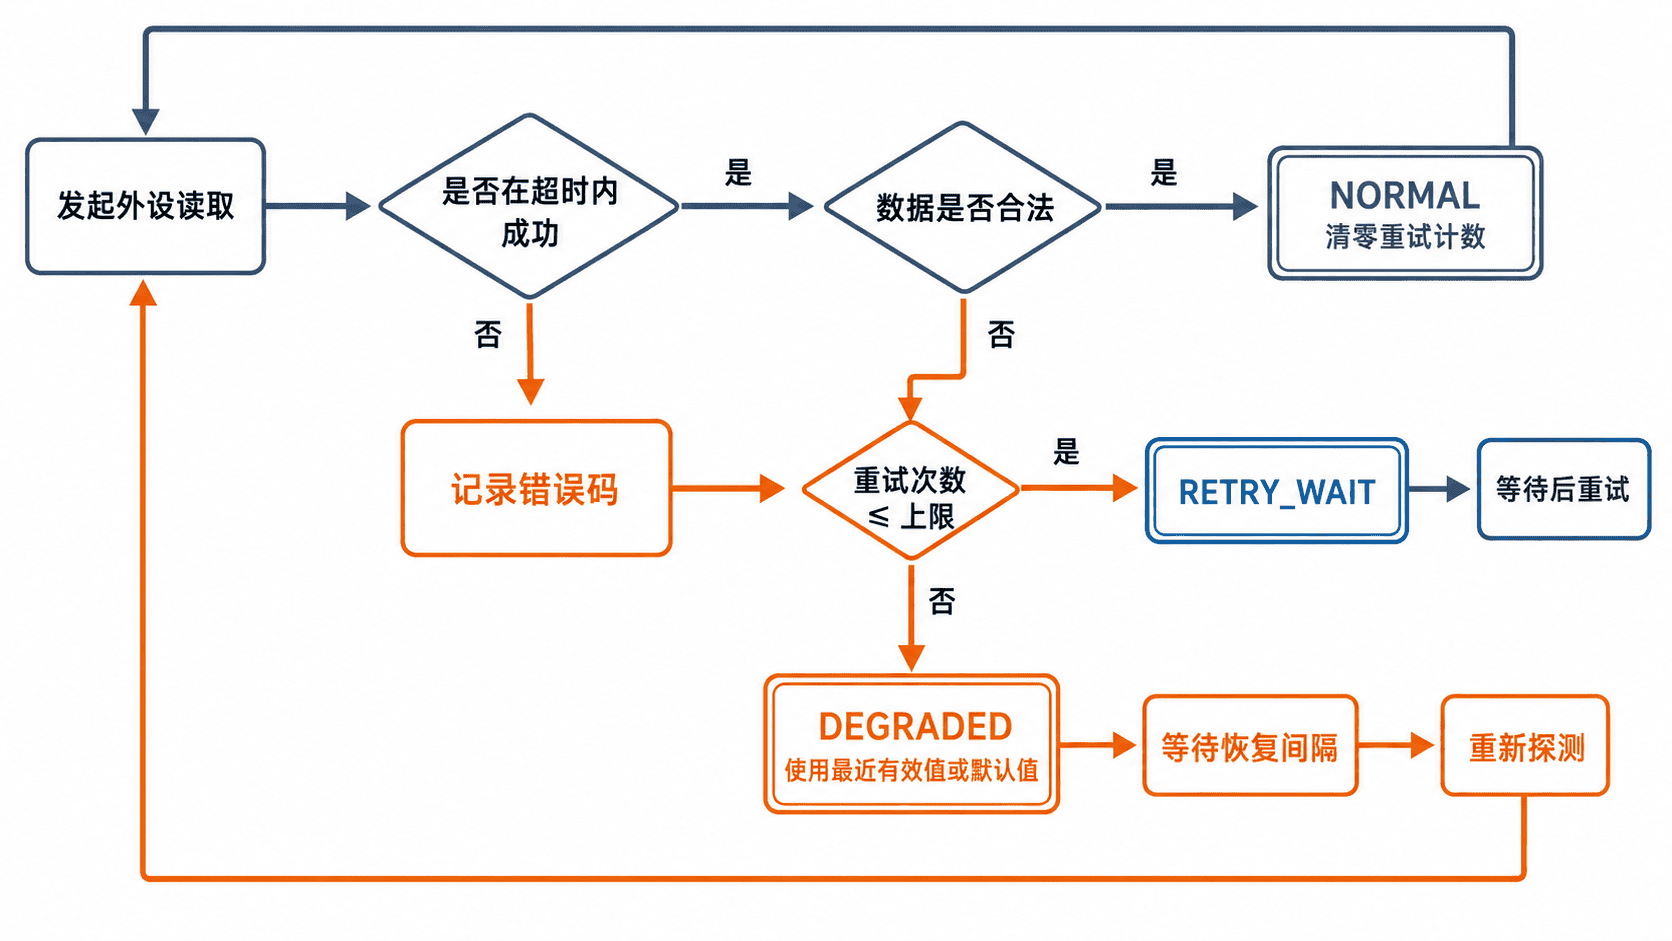
错误码与策略分工
错误码回答“发生了什么”,状态回答“系统现在怎么运行”。例如 ERR_TIMEOUT 表示本次调用超时,DEGRADED 表示系统已经停止高频重试并使用替代值。不要只返回 true 或 false,否则日志、告警和上层决策都无法区分根因。
默认值也要按业务风险选择。环境显示可以使用最近一次有效值,安全联锁则不能把旧值当作当前值;此时应进入安全状态并明确标记数据无效。降级不是隐藏故障,而是在保持核心功能的同时暴露故障状态。
非阻塞恢复状态机
下面是基于 STM32 HAL 时基的片段示例。Sensor_Read 由具体传感器驱动实现,并且必须在 timeout_ms 到达后返回,不能内部无限等待。主循环周期调用 SensorRecovery_Poll,代码不使用 HAL_Delay 阻塞重试。
#include "stm32f4xx_hal.h"
#include <math.h>
#include <stdbool.h>
#include <stdint.h>

#define SENSOR_MAX_FAILURES          3U
#define SENSOR_RETRY_DELAY_MS        200U
#define SENSOR_RECOVER_INTERVAL_MS   5000U
#define SENSOR_READ_TIMEOUT_MS       20U
#define SENSOR_DEFAULT_VALUE         25.0f

typedef enum {
    ERR_NONE = 0,
    ERR_TIMEOUT = 1001,
    ERR_IO = 1002,
    ERR_DATA_INVALID = 1003
} AppError;

typedef enum {
    SENSOR_NORMAL = 0,
    SENSOR_RETRY_WAIT,
    SENSOR_DEGRADED
} SensorState;

typedef struct {
    SensorState state;
    AppError last_error;
    uint8_t failure_count;
    uint32_t next_action_ms;
    float current_value;
    float last_good_value;
    bool has_good_value;
} SensorRecovery;

/* 由具体 I2C、SPI 或 ADC 驱动实现,必须遵守 timeout_ms。 */
HAL_StatusTypeDef Sensor_Read(float *value, uint32_t timeout_ms);

static bool TimeReached(uint32_t now, uint32_t deadline)
{
    return (int32_t)(now - deadline) >= 0;
}

static bool SensorValue_IsValid(float value)
{
    return isfinite(value) && value >= -40.0f && value <= 125.0f;
}

void SensorRecovery_Init(SensorRecovery *ctx)
{
    ctx->state = SENSOR_RETRY_WAIT;
    ctx->last_error = ERR_NONE;
    ctx->failure_count = 0U;
    ctx->next_action_ms = 0U;
    ctx->current_value = SENSOR_DEFAULT_VALUE;
    ctx->last_good_value = SENSOR_DEFAULT_VALUE;
    ctx->has_good_value = false;
}

void SensorRecovery_Poll(SensorRecovery *ctx)
{
    uint32_t now = HAL_GetTick();
    if (!TimeReached(now, ctx->next_action_ms)) {
        return;
    }

    float value = 0.0f;
    HAL_StatusTypeDef status = Sensor_Read(
        &value,
        SENSOR_READ_TIMEOUT_MS
    );

    if (status == HAL_OK && SensorValue_IsValid(value)) {
        ctx->state = SENSOR_NORMAL;
        ctx->last_error = ERR_NONE;
        ctx->failure_count = 0U;
        ctx->current_value = value;
        ctx->last_good_value = value;
        ctx->has_good_value = true;
        return;
    }

    if (status == HAL_TIMEOUT) {
        ctx->last_error = ERR_TIMEOUT;
    } else if (status != HAL_OK) {
        ctx->last_error = ERR_IO;
    } else {
        ctx->last_error = ERR_DATA_INVALID;
    }

    ctx->failure_count++;

    if (ctx->failure_count <= SENSOR_MAX_FAILURES) {
        ctx->state = SENSOR_RETRY_WAIT;
        ctx->next_action_ms = now + SENSOR_RETRY_DELAY_MS;
        return;
    }

    ctx->state = SENSOR_DEGRADED;
    ctx->failure_count = 0U;
    ctx->current_value = ctx->has_good_value
        ? ctx->last_good_value
        : SENSOR_DEFAULT_VALUE;
    ctx->next_action_ms = now + SENSOR_RECOVER_INTERVAL_MS;
}
预期结果
读取成功:状态为 SENSOR_NORMAL,错误码清零,更新当前值。
连续第 1~3 次失败:状态为 SENSOR_RETRY_WAIT,每 200 ms 再尝试一次。
连续第 4 次失败:状态为 SENSOR_DEGRADED,使用最近有效值或默认值。
进入降级 5000 ms 后:再次探测;成功则自动回到 SENSOR_NORMAL。
实际时间由 HAL_GetTick() 和主循环调用频率决定,允许存在一个调度周期的误差。
接入主循环与系统级处理
主循环应持续运行其他任务,只周期调用恢复状态机。显示、控制或通信模块读取 current_value 时,还要同时检查 state 和 last_error,避免把降级值误认为实时测量值。错误码发生变化时再记录日志,可防止同一故障高速刷屏。
看门狗是最后一道保护,不应代替超时和状态机。正常路径要持续喂狗;若底层驱动违反超时约定并永久阻塞,看门狗才负责复位。复位后还应读取复位原因和持久化故障计数,避免设备陷入无提示的反复重启。
验证恢复设计
测试时要主动注入故障,而不是只验证正常通信。可临时断开外设、让驱动返回超时、提供越界数据,并观察主循环是否仍能响应、错误码是否正确、重试间隔是否符合设计、降级值是否被明确标记。
恢复测试同样重要:故障解除后,设备应在设定探测周期内回到正常状态,清除临时错误,并重新更新实时值。若恢复后仍停留在降级状态,通常是状态转移条件、时间比较或失败计数没有正确复位。