
游戏 AI / 系统课时
搭一套巡逻与追逐群体
搭一套巡逻与追逐群体
一个可用的群体移动控制器,不应把 Wander、Pursue、Avoidance 和群体力写成彼此独立的“抢方向”逻辑,而要先确定当前模式,再计算对应行为,最后统一限幅并更新速度。本节用一个最小可运行示例串起巡逻、发现目标、追逐和避障的完整链路。
学习目标
- 组合 Wander、Seek、Pursue、Avoidance 与群体行为形成统一 Steering 输出
- 用模式切换区分巡逻与追逐,而不是让所有行为始终同时生效
- 通过限加速度、限速度和邻居查询保持群体移动稳定
先把控制链路分层
每帧可以拆成四层:感知、模式选择、行为组合、运动更新。感知层拿到目标、障碍和邻居;模式层决定当前是 Patrol 还是 Chase;行为层根据模式启用不同 Steering;运动层只负责限幅、积分和写回位置。
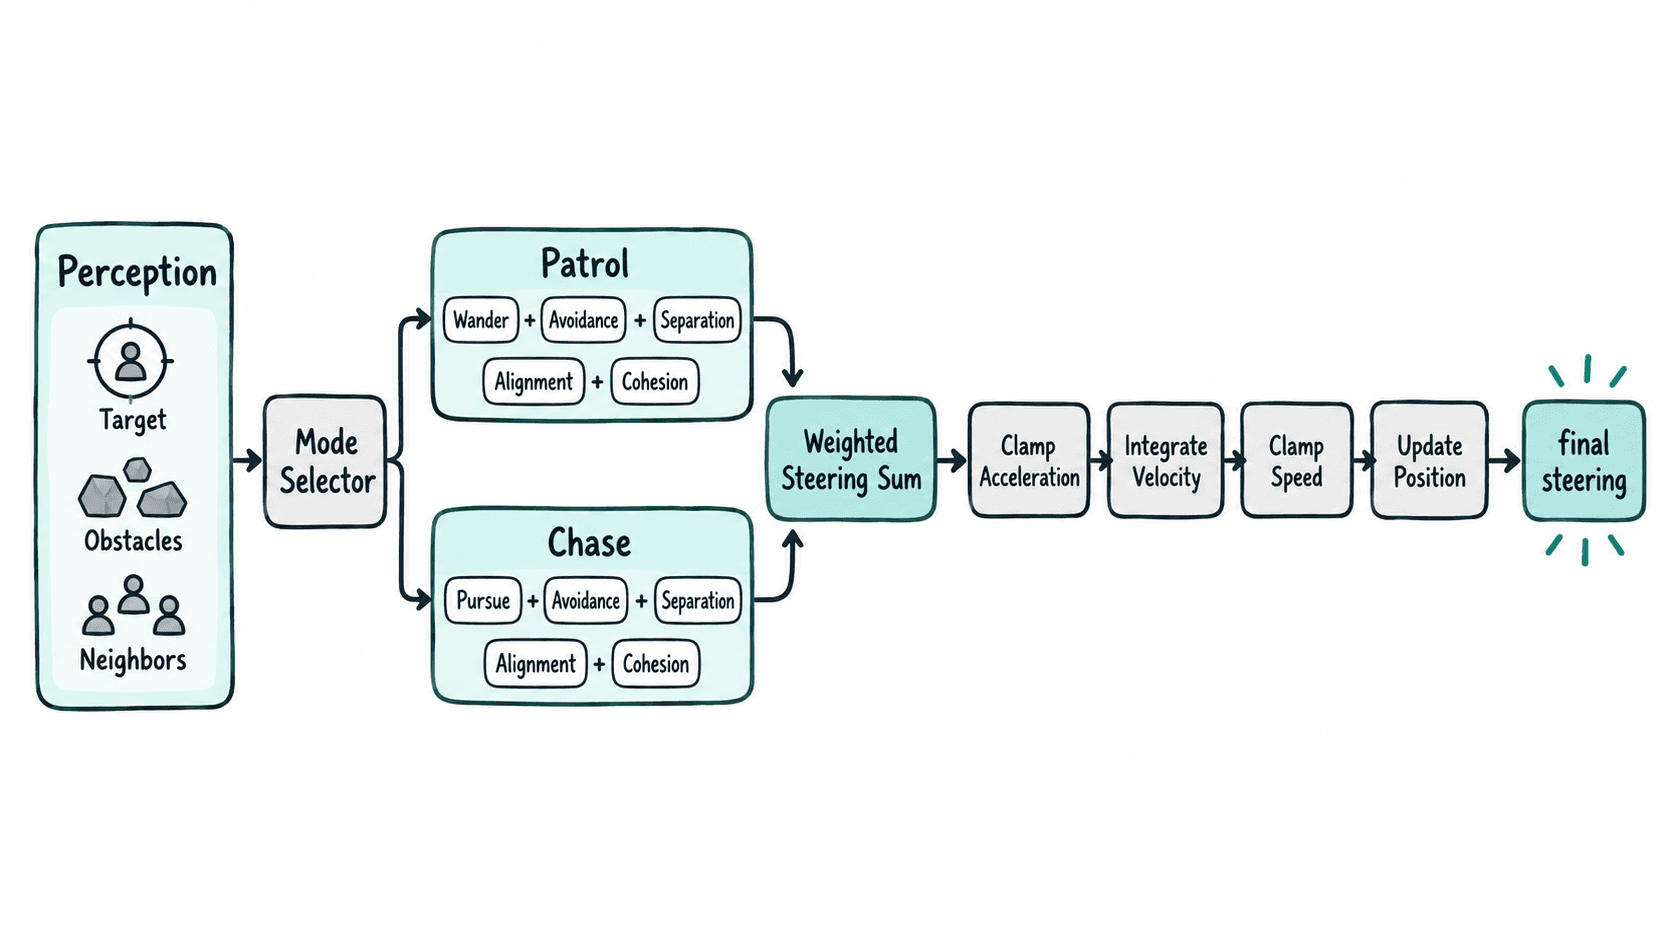
这种分层有两个直接收益。第一,模式决定“要做什么”,行为只负责“怎么转向”,职责不会混在一起。第二,安全行为可以在两种模式中复用,例如 Avoidance 和 Separation 始终保留,而 Wander 与 Pursue 只在各自模式生效。
巡逻与追逐分别组合
巡逻不等于纯随机。一个常见组合是 Wander 提供缓慢变化的前进方向,Avoidance 避开墙体和障碍,Separation 防止单位挤在一起,Alignment 与 Cohesion 让群体方向和中心保持一致。
进入追逐后,目标行为从 Wander 换成 Pursue。Pursue 不是直接追当前位置,而是根据目标速度估计短时间后的未来位置,再对预测点做 Seek。这样目标横向移动时,追逐者不会长期跟在目标身后画弧线。
权重可以理解为风格比例,但不要让它承担“紧急避障”的全部责任。实际系统里常把 Avoidance 做成高优先级或至少给足权重,再把群体行为控制在不会压过安全行为的范围。
用一个最小程序串起来
下面示例保留二维向量、巡逻/追逐模式,以及 Wander、Seek、Pursue、Avoidance、Separation、Alignment、Cohesion。它不依赖具体引擎,但计算顺序与实际项目一致,便于先验证组合方式。
from dataclasses import dataclass
from math import hypot

# Minimal 2D vector utilities keep the example engine-independent.
@dataclass
class Vec2:
    x: float
    y: float

    def __add__(self, other):
        return Vec2(self.x + other.x, self.y + other.y)

    def __sub__(self, other):
        return Vec2(self.x - other.x, self.y - other.y)

    def __mul__(self, scale):
        return Vec2(self.x * scale, self.y * scale)

    def length(self):
        return hypot(self.x, self.y)

    def normalized(self):
        size = self.length()
        return Vec2(0.0, 0.0) if size == 0 else Vec2(self.x / size, self.y / size)

    def clamp(self, max_length):
        size = self.length()
        return self if size <= max_length else self.normalized() * max_length

@dataclass
class Agent:
    pos: Vec2
    vel: Vec2

# Goal behaviors only return steering; they never update position directly.
def seek(agent, target_pos, max_speed):
    desired = (target_pos - agent.pos).normalized() * max_speed
    return desired - agent.vel

def pursue(agent, target, max_speed, prediction_time=0.8):
    future = target.pos + target.vel * prediction_time
    return seek(agent, future, max_speed)

def wander(agent, max_speed):
    forward = agent.vel.normalized()
    if forward.length() == 0:
        forward = Vec2(1.0, 0.0)
    desired = (forward + Vec2(0.0, 0.35)).normalized() * max_speed
    return desired - agent.vel

# Flocking behaviors use the same neighbor list and can be weighted independently.
def separation(agent, neighbors, radius):
    force = Vec2(0.0, 0.0)
    for other in neighbors:
        offset = agent.pos - other.pos
        distance = offset.length()
        if 0 < distance < radius:
            force = force + offset.normalized() * (radius - distance)
    return force

def alignment(agent, neighbors, max_speed):
    if not neighbors:
        return Vec2(0.0, 0.0)
    avg = Vec2(
        sum(n.vel.x for n in neighbors) / len(neighbors),
        sum(n.vel.y for n in neighbors) / len(neighbors),
    )
    return avg.normalized() * max_speed - agent.vel

def cohesion(agent, neighbors, max_speed):
    if not neighbors:
        return Vec2(0.0, 0.0)
    center = Vec2(
        sum(n.pos.x for n in neighbors) / len(neighbors),
        sum(n.pos.y for n in neighbors) / len(neighbors),
    )
    return seek(agent, center, max_speed)

# Safety steering is kept separate so it can receive a stronger weight.
def avoidance(agent, obstacles, radius=2.0):
    force = Vec2(0.0, 0.0)
    for obstacle in obstacles:
        offset = agent.pos - obstacle
        distance = offset.length()
        if 0 < distance < radius:
            force = force + offset.normalized() * (radius - distance)
    return force

# One update path combines mode-specific, safety, and flocking forces.
def update(agent, neighbors, obstacles, target, can_see_target, dt=1.0):
    max_speed = 3.0
    max_acceleration = 2.0

    goal = (
        pursue(agent, target, max_speed)
        if can_see_target
        else wander(agent, max_speed)
    )
    safety = avoidance(agent, obstacles) * 2.0
    group = (
        separation(agent, neighbors, 1.5) * 1.2
        + alignment(agent, neighbors, max_speed) * 0.3
        + cohesion(agent, neighbors, max_speed) * 0.25
    )

    steering = (goal + safety + group).clamp(max_acceleration)
    agent.vel = (agent.vel + steering * dt).clamp(max_speed)
    agent.pos = agent.pos + agent.vel * dt

    return ("CHASE" if can_see_target else "PATROL"), agent

target = Agent(Vec2(6.0, 1.0), Vec2(1.0, 0.0))
leader = Agent(Vec2(0.0, 0.0), Vec2(1.0, 0.0))
neighbor = Agent(Vec2(-0.8, 0.0), Vec2(1.0, 0.0))
obstacles = [Vec2(1.0, -0.5)]

mode, leader = update(
    leader,
    neighbors=[neighbor],
    obstacles=obstacles,
    target=target,
    can_see_target=True,
)

print(mode)
print(f"pos=({leader.pos.x:.2f}, {leader.pos.y:.2f})")
print(f"speed={leader.vel.length():.2f}")
预期输出
CHASE
pos=(1.83, 1.23)
speed=2.20
这里的关键不是数值本身,而是调用顺序:先选择巡逻或追逐目标力,再叠加安全与群体约束,最后统一限制加速度和速度。继续增加新的 Steering 行为时,也应让它们回到同一组合层,而不是让每个行为直接修改位置。
把避障放在群体风格之前
当角色前方出现障碍时,Avoidance 应优先保证不会撞墙;群体行为只负责在安全空间内维持队形。如果 Cohesion 太强,它会持续把角色拉回群体中心,可能抵消避障;如果 Separation 太强,又会让追逐队形像爆炸一样散开。
一个稳妥的调试顺序是先单独验证 Avoidance,再加入 Separation,确认单位不会重叠;随后加入 Alignment 和 Cohesion;最后切换 Patrol 与 Chase,观察模式变化时速度是否连续。发现问题时,先判断是“模式选错”“目标力异常”还是“群体力覆盖了目标力”,不要直接从所有权重一起改。
用可观测信息做验收
完成后至少把当前模式、最终 Steering、邻居数量和目标是否可见显示在调试面板或 Gizmo 中。巡逻场景应能看到群体持续移动但方向缓慢变化;目标进入感知范围后,模式切到 Chase,群体整体转向目标预测位置;遇到障碍时,路径可以暂时分散,但通过障碍后能重新收拢。
这套结构的价值在于可扩展:以后增加 Flee、Formation 或优先级避障时,只需扩展模式选择或行为组合,不必推翻运动更新层。只要所有行为最终都汇总为同一种 Steering 输出,群体移动就能继续保持可调试、可限幅和可复现。