
PLC 与工业控制 / 系统课时
读取通信诊断定位设备掉线
读取通信诊断定位设备掉线
PLC与上位机通信中断时,设备可能仍在运行,但HMI数据停止更新,甚至出现离线报警。本课使用一套可重复的诊断顺序,结合网络连通性、协议地址、超时计数和设备状态,定位故障发生在哪一层,并验证修复后数据确实恢复更新。
学习目标
- 能区分物理断链、IP网络异常、协议连接失败和数据更新停滞。
- 能使用Ping、TCP端口检测及PLC通信诊断计数定位故障。
- 能按照现场验收方法复现、修复并记录通信掉线问题。
根据故障现象确定排查入口
以一套输送分拣设备为例,PLC地址为192.168.10.10,上位机地址为192.168.10.20,子网掩码均为255.255.255.0。上位机通过Modbus TCP读取PLC的运行状态和产量,服务端监听TCP端口502。
现场先将故障分为四种,不要看到HMI画面不动就直接判断PLC掉线。
| 现场现象 | 优先检查 | 判断依据 |
|---|---|---|
| PLC网络接口Link灯熄灭 | 网线、端口、交换机供电 | 物理链路可能断开 |
| Link灯正常但Ping不通 | IP、子网、路由及访问策略 | 网络层可能异常 |
| Ping正常但通信驱动报错 | TCP端口、协议服务、站号与连接配置 | 应用层连接可能失败 |
| 通信显示在线但数据不变化 | 点位质量、时间戳、PLC变量及轮询任务 | 可能是数据更新链路异常 |
特别注意:Ping成功只能证明ICMP通信在测试时可达,不能证明Modbus TCP服务正常;Ping失败也不能单独证明设备已经离线,因为部分设备或网络策略会限制ICMP。
诊断过程中,首先记录故障发生时间、受影响设备、PLC的RUN/STOP状态以及HMI最后一次有效数据更新时间。如果电机仍在运转而画面数值冻结,应优先确认监控数据质量,不要直接执行设备复位。
沿通信链路逐层定位
一个常见的PLC监控链路包含上位机网卡、工业交换机、PLC以太网接口、协议服务器和PLC变量映射。诊断时从物理层向应用层逐项收缩故障范围。
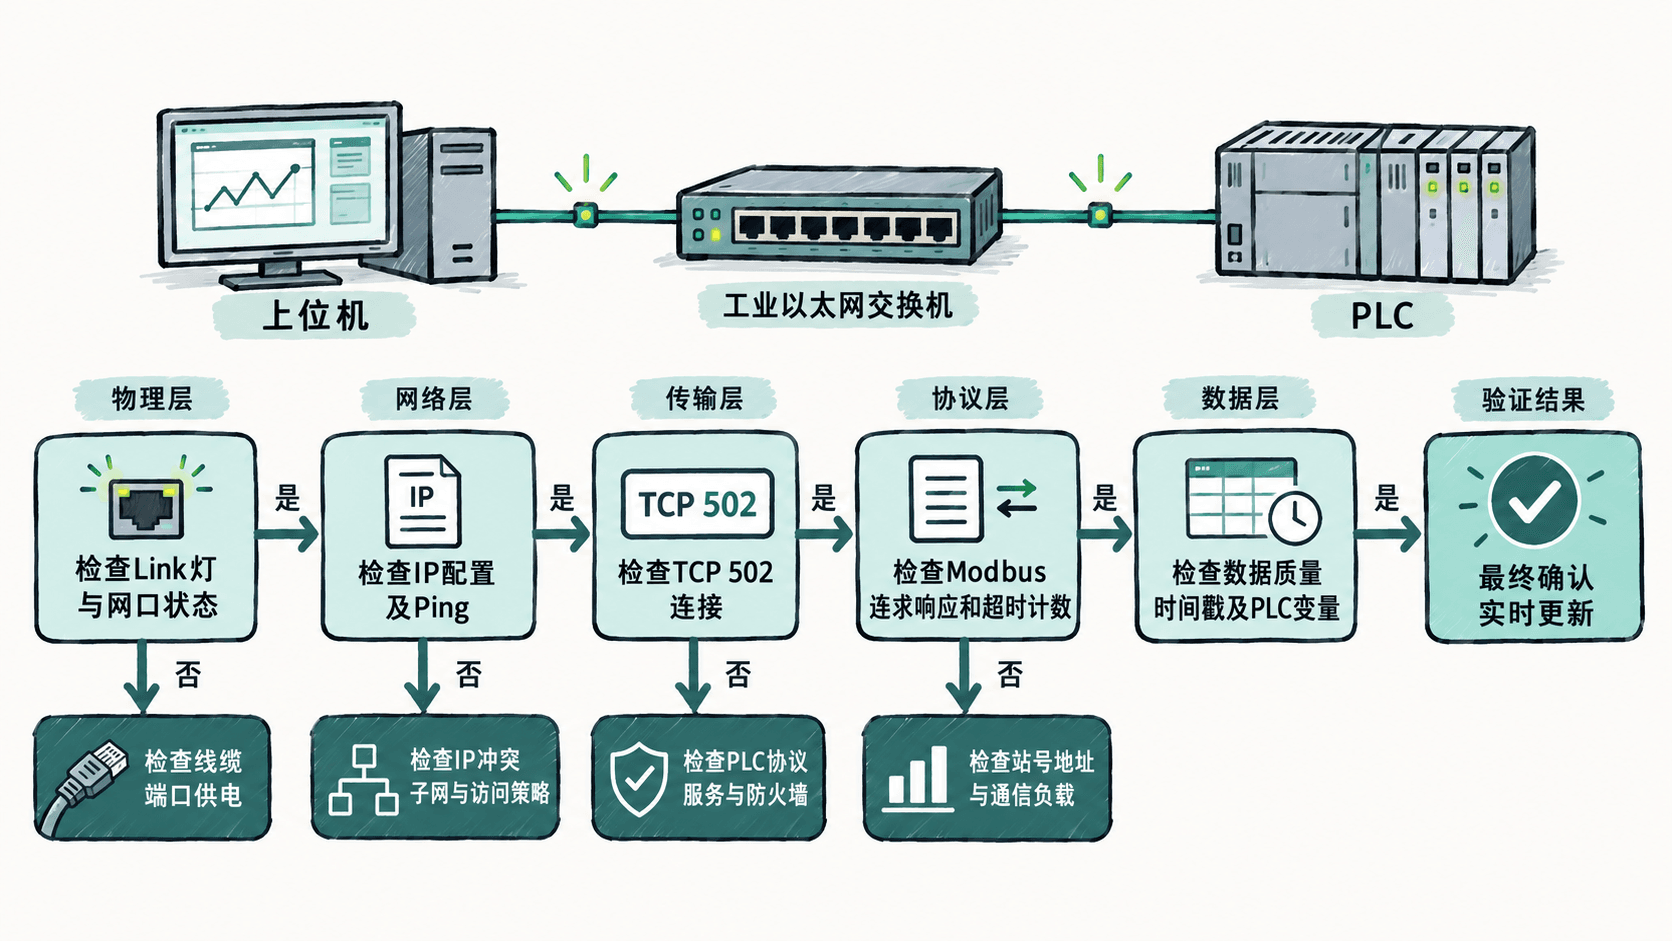
检查物理链路与IP设置
先观察PLC、交换机和上位机网口的Link指示灯。Link灯熄灭时,检查网线连接、端口状态与供电;Link灯正常时,再检查逻辑连通性。
在Windows上位机打开PowerShell,运行以下命令:
# 查看上位机网卡的IPv4配置
Get-NetIPConfiguration

# 测试PLC地址的ICMP连通性
ping -n 4 192.168.10.10

# 查看本机到目标地址的路由路径
tracert -d 192.168.10.10预期结果:在示例直连或同交换机网络中,正确配置的上位机应有192.168.10.20/24地址,并且允许ICMP的PLC能够响应Ping。以下是成功Ping的一种典型输出:
Reply from 192.168.10.10: bytes=32 time<1ms TTL=64
Reply from 192.168.10.10: bytes=32 time<1ms TTL=64
Reply from 192.168.10.10: bytes=32 time<1ms TTL=64
Reply from 192.168.10.10: bytes=32 time<1ms TTL=64实际延迟、TTL和语言会随设备与系统不同而变化,<1ms只是示例值。tracert在同一子网内通常直接到达目标,也可能因ICMP限制而出现超时。
如果上位机地址误设为192.168.20.20/24,且没有适当路由,便无法按预期访问192.168.10.10。应按现场IP地址规划修正上位机配置,而不是随意修改PLC地址。
检查TCP端口及协议服务
网络可达后,使用PowerShell检测Modbus TCP端口:
# 只验证TCP连接,尚未发送Modbus请求
Test-NetConnection -ComputerName 192.168.10.10 -Port 502
预期结果:服务监听且允许连接时,关键字段为:
ComputerName     : 192.168.10.10
RemoteAddress    : 192.168.10.10
RemotePort       : 502
TcpTestSucceeded : True如果TcpTestSucceeded为False,检查PLC是否启用Modbus TCP Server、设备是否确实监听502端口、交换机ACL或防火墙是否阻断,以及连接资源是否耗尽。
读取通信诊断与超时计数
对于Modbus TCP场景,应进入PLC工程软件的在线诊断或通信功能块监视页面,同时查看上位机Modbus驱动的错误统计。具体菜单名称随PLC品牌和工程软件版本而变化,不能把某品牌的诊断字段当作所有设备的统一标准。
重点记录以下数据:
| 诊断数据 | 示例观察值 | 说明 |
|---|---|---|
| TCP连接状态 | Connected | TCP连接已建立 |
| 请求次数 | 1250 | 客户端累计发出请求数 |
| 成功响应次数 | 1242 | 累计收到有效响应次数 |
| 超时次数 | 8 | 请求在超时期限内未得到有效响应 |
| 最近错误 | Timeout | 最近一次请求等待超时 |
| 数据最后更新时间 | 14:32:08 | 最近成功刷新时刻 |
表中字段和值是现场诊断记录示例,不代表某种PLC必然提供相同字段。某些驱动还会把协议异常响应、校验错误与网络超时分别计数。
例如,在一次测试窗口中发送200次请求,其中8次超时,则超时率为:
如果轮询周期为200ms、响应超时设置为1000ms,客户端并非每隔200ms一定收到新数据。连续请求失败或重试排队可能使画面明显滞后,应结合驱动的调度方式判断。
按照以下顺序观察计数变化:
- 记录当前成功响应与超时次数。
- 保持设备正常运行或在安全仿真环境中持续轮询60秒。
- 再次读取计数,计算本窗口的新增请求和新增超时。
- 如果成功次数持续增长且数据时间戳更新,通信通常处于正常工作状态。
- 如果请求增加但成功响应不增加,重点检查服务端响应、协议参数与通信负载。
- 如果请求次数也不增加,检查上位机轮询任务是否停止、驱动是否禁用或数据组是否失去订阅。
还应区分两种不同错误:请求无响应属于超时;服务端返回Modbus异常码,例如02非法数据地址,则说明通信已有响应,故障重点应转向寄存器映射,而非网线。
区分通信正常与数据停止更新
PLC和上位机之间保持TCP连接,并不代表全部变量都实时更新。可能出现驱动仍显示Connected,但点位的时间戳不变、质量为Bad,或者PLC内部变量本身没有变化。
可选择两个点位交叉验证:一个是持续变化的PLC心跳计数器,另一个是输送电机运行状态MotorRunning。心跳计数器由PLC周期任务递增,例如每秒增加1;电机状态则只在实际运行条件变化时更新。
检查顺序如下:
- 在PLC在线监控中确认心跳计数器持续递增。
- 在上位机查看对应点位的值、质量标识和采集时间戳。
- 如果PLC心跳变化而上位机不变,检查寄存器映射、轮询任务和驱动缓存。
- 如果PLC与上位机心跳都变化,但
MotorRunning始终不变,应核对PLC内部状态与点位地址,不能仅凭数值不变认定通信失败。
对于Modbus TCP,还需核对寄存器起始地址。某些客户端显示40001形式的参考地址,另一些使用从0开始的协议偏移。两者是否对应同一寄存器,取决于客户端的地址解释方式;应使用设备寄存器表与实际读数验证。
如果某个点位只有在HMI页面打开时才轮询,关闭页面后更新时间戳停止也可能是正常的驱动策略。验收时需要明确数据组是否配置为持续采集。
复现故障并完成恢复验收
现场验收宜在允许停机的窗口或仿真环境中进行,不能通过直接拔除正在控制危险运动设备的通信线缆来验证恢复逻辑。
推荐执行三组受控测试:
| 测试项目 | 操作条件 | 合格判据 |
|---|---|---|
| 正常通信 | 连续轮询60秒 | 心跳更新,数据质量有效,无新增超时 |
| 模拟通信中断 | 在测试网络中受控阻断TCP 502 | 驱动报告连接异常,画面标记数据失效 |
| 恢复连接 | 撤销阻断并恢复轮询 | 在约定恢复期限内重新读取有效数据 |
例如,项目约定通信故障判定不超过3秒、恢复后5秒内重新取得有效数据。它们属于本案例的验收目标,不是Modbus TCP协议规定的统一时间。实际工程需结合超时、重试、轮询周期和安全要求确定。
恢复时应遵循先排除物理与网络故障,再恢复协议服务,最后验证数据有效性的顺序。不要仅凭HMI离线图标消失就宣布修复成功。
验收记录至少填写故障时间、设备IP、受影响点位、网络测试结果、端口测试结果、超时计数前后值、根因、修复操作、恢复耗时和测试人员。
完成验收的最终标准是:通信诊断无持续增长的异常计数,关键点位能够按约定周期更新,故障期间的数据失效状态可识别,且通信恢复不会绕过设备自身的启动与安全联锁。