
工业通信与现场总线 / 系统课时
处理字节序与浮点数映射
处理字节序与浮点数映射
Modbus 寄存器一次只承载 16 位数据,但设备常把 32 位整数和 IEEE 754 浮点数拆到两个连续寄存器中。真正容易出错的不是传输,而是两个字节如何组成寄存器、两个寄存器又按什么顺序组成 32 位值。本节用同一个浮点数验证四种常见排列,并建立可靠的解析方法。
学习目标
- 区分寄存器内部的字节序与两个寄存器之间的字序
- 识别 ABCD、BADC、CDAB、DCBA 四种常见 32 位排列
- 用已知测试值验证设备文档中的浮点数映射方式
两层顺序不能混为一谈
假设一个 32 位浮点数在规范字节序下由四个字节 A B C D 构成。映射到两个 16 位 Modbus 寄存器后,需要同时回答两个问题:一个寄存器内部是 AB 还是 BA,以及高 16 位字和低 16 位字谁排在前面。
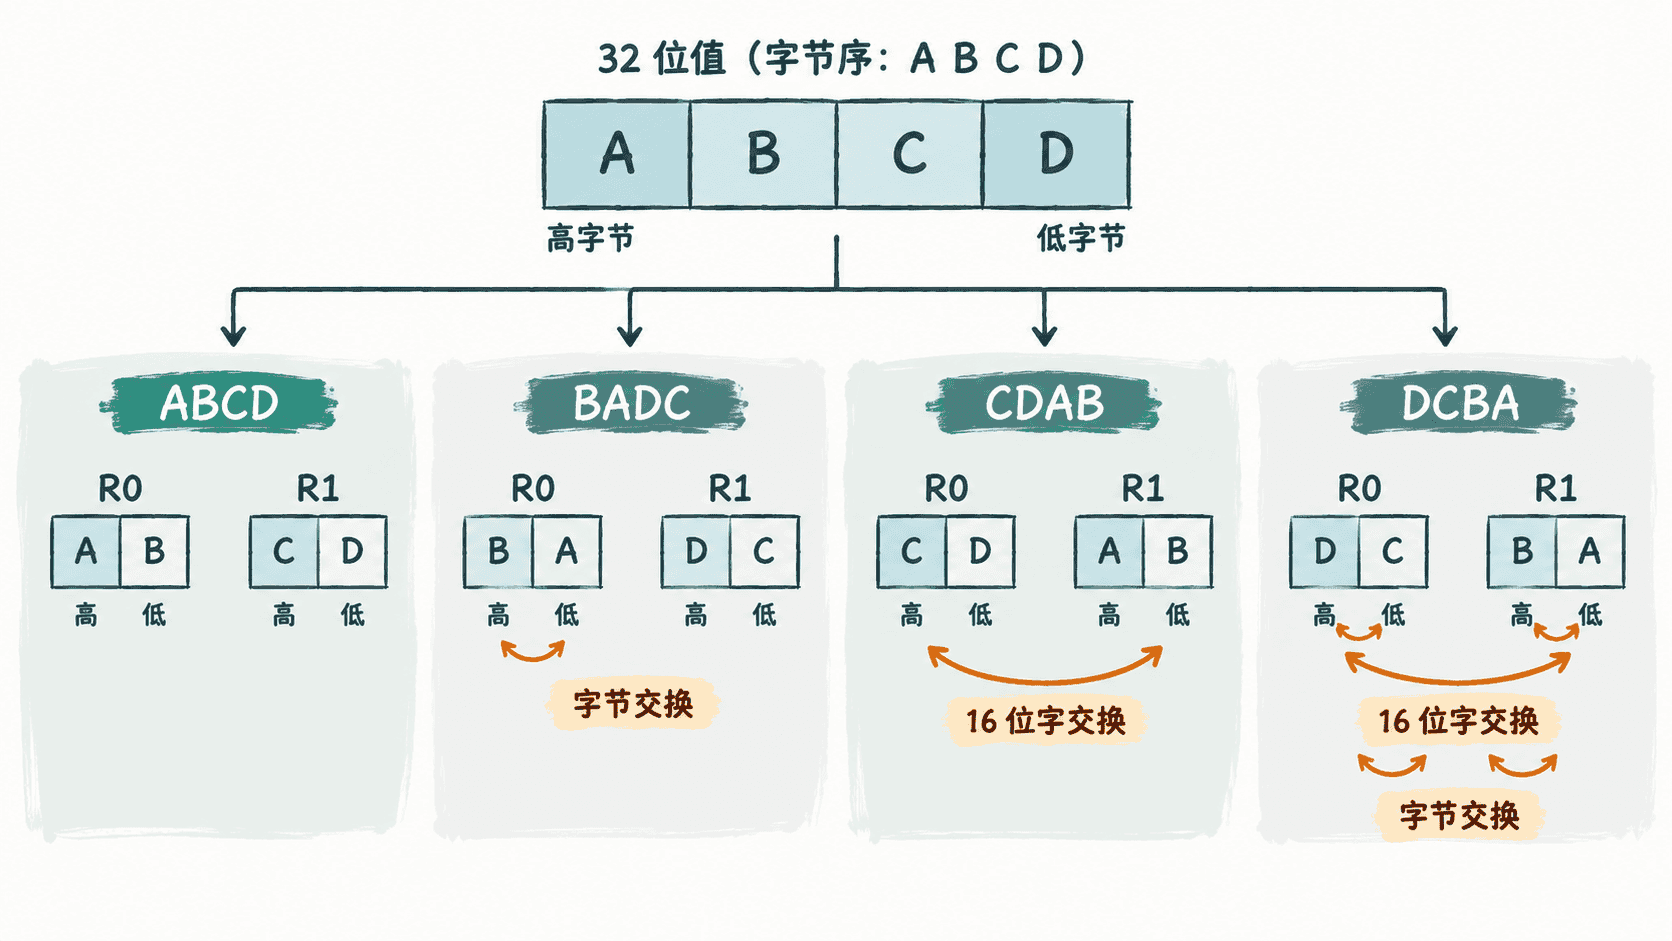
常见写法可以归纳为:
| 排列 | 第一个寄存器 | 第二个寄存器 | 特征 |
|---|---|---|---|
| ABCD | AB | CD | 字节与字都保持顺序 |
| BADC | BA | DC | 每个 16 位寄存器内部交换字节 |
| CDAB | CD | AB | 两个 16 位字交换 |
| DCBA | DC | BA | 字交换且每个字内部再交换字节 |
用已知浮点数验证排列
IEEE 754 单精度浮点数 12.5 的标准 32 位字节为 41 48 00 00。下面的完整 Python 程序先按四种排列生成两个寄存器,再使用相同规则还原浮点数。实际接入设备时,只需把 registers 换成读回的两个寄存器值。
import struct


def encode_registers(value: float, order: str) -> list[int]:
    raw = struct.pack(">f", value)
    a, b, c, d = raw
    layouts = {
        "ABCD": bytes([a, b, c, d]),
        "BADC": bytes([b, a, d, c]),
        "CDAB": bytes([c, d, a, b]),
        "DCBA": bytes([d, c, b, a]),
    }
    arranged = layouts[order]
    return [
        int.from_bytes(arranged[0:2], "big"),
        int.from_bytes(arranged[2:4], "big"),
    ]


def decode_registers(registers: list[int], order: str) -> float:
    arranged = b"".join(reg.to_bytes(2, "big") for reg in registers)
    inverse = {
        "ABCD": [0, 1, 2, 3],
        "BADC": [1, 0, 3, 2],
        "CDAB": [2, 3, 0, 1],
        "DCBA": [3, 2, 1, 0],
    }
    raw = bytes(arranged[i] for i in inverse[order])
    return struct.unpack(">f", raw)[0]


for order in ("ABCD", "BADC", "CDAB", "DCBA"):
    registers = encode_registers(12.5, order)
    decoded = decode_registers(registers, order)
    print(order, [f"0x{reg:04X}" for reg in registers], decoded)
预期输出
ABCD ['0x4148', '0x0000'] 12.5
BADC ['0x4841', '0x0000'] 12.5
CDAB ['0x0000', '0x4148'] 12.5
DCBA ['0x0000', '0x4841'] 12.5
这个结果说明,同一个物理量在不同设备中可能对应完全不同的寄存器原始值。只要编码与解码采用同一种排列,最终都能恢复为 12.5。
解析异常时按原始字节定位
最典型的故障现象是通信没有超时,功能码也正常,但得到极大值、极小值、负数或接近零的异常浮点数。这时不要先修改比例系数,而应先保存两个寄存器的十六进制原始值。
例如设备说明测试值应为 12.5,实际读到 0x0000 0x4148,而程序按照 ABCD 解析,就说明链路已经正确读到数据,只是两个 16 位字的顺序与程序假设不同。将解析规则切换为 CDAB 后即可恢复正确值。
工程调试时最好让设备端输出一个明确且稳定的已知值,再分别尝试四种排列。找到唯一合理结果后,把该规则固定到设备型号或点位配置中,而不是在业务代码里根据数值大小进行猜测。这样才能把“通信正确”和“数据解释正确”作为两个独立问题验证。