
工业通信与现场总线 / 系统课时
建立可复现的故障证据链
建立可复现的故障证据链
偶发通信故障最难的不是“看到一次异常”,而是证明异常在什么条件下出现、经过哪条链路传播,以及修复后是否真正消失。本节把拓扑、配置、日志、报文和复现步骤组织成一条可重复验证的证据链,让排障从经验判断变成可复核实验。
学习目标
- 建立覆盖拓扑、配置、日志、报文和复现条件的故障证据集
- 按时间与因果关系关联多来源证据,缩小故障发生位置
- 使用固定复现步骤和验收条件验证修复是否有效
先固定故障发生时的现场
排查前先回答一个问题:下一次故障出现时,能不能拿到与这一次可比较的数据? 如果每次使用不同拓扑、不同配置、不同负载和不同抓包位置,即使现象相同,也很难证明根因相同。
至少固定以下信息:设备型号与固件、主从站或控制器角色、网络连接关系、协议参数、业务负载、测试起止时间,以及故障发生前后是否有人修改配置。配置文件和工程文件应保存版本或校验值,而不是只记录“参数已经检查过”。
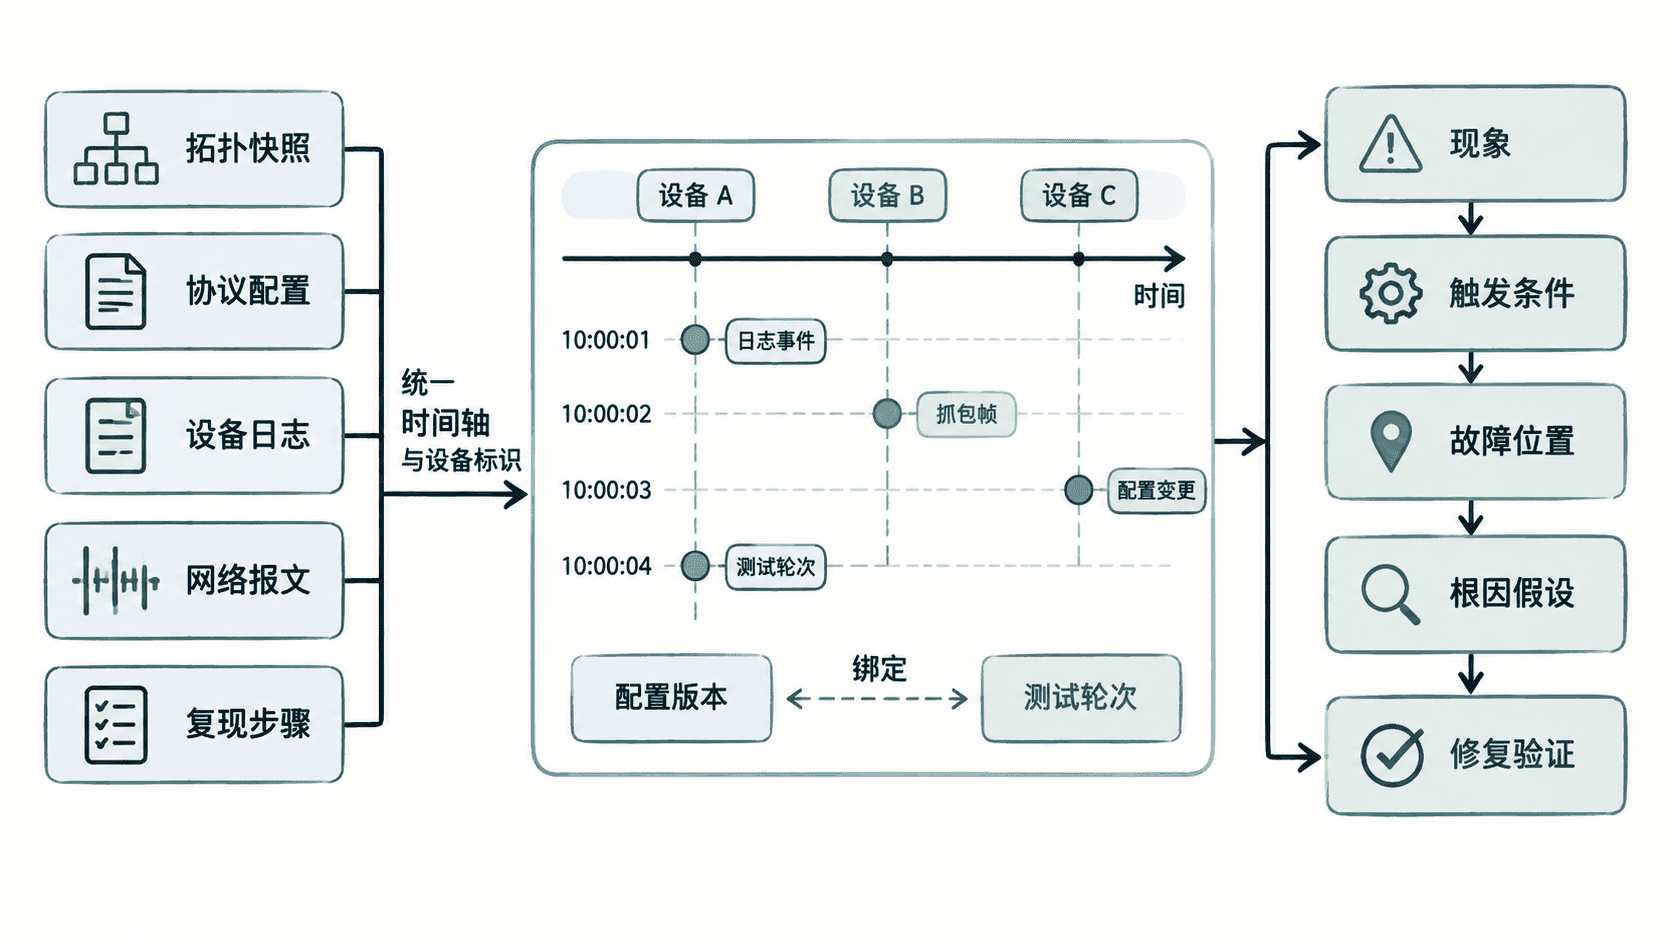
统一时间与测试编号
日志、抓包和控制器事件往往来自不同设备。若时间基准相差几秒,报文超时与设备报警就可能被错误关联。测试前应同步时钟;无法统一时钟时,至少制造一个所有数据源都能观察到的标志事件,例如断开并恢复某个测试连接,再记录各系统中的时间偏移。
每次复现还要分配唯一测试编号,例如 CASE-017。该编号应同时出现在测试记录、抓包文件名、日志目录和配置快照说明中,使任何一条证据都能追溯到同一次实验。
下面的命令片段可用于 Linux 测试机记录接口信息、路由和抓包。实际接口名、路径和主机地址需要按现场替换。
CASE_ID="CASE-017"
OUT="<PATH>/${CASE_ID}"
mkdir -p "$OUT"

ip -details link show > "$OUT/link.txt"
ip route show > "$OUT/route.txt"
date --iso-8601=seconds > "$OUT/start-time.txt"
tcpdump -i eth0 -nn -s 0 -w "$OUT/traffic.pcap" host <HOST>
预期结果
<PATH>/CASE-017/ 下生成 link.txt、route.txt、start-time.txt,并持续写入 traffic.pcap;tcpdump 在手动停止前保持抓包状态。<PATH>、<HOST> 和采集时间都是现场动态值。工业以太网协议还可能需要交换机镜像端口或专用 TAP,不能默认普通主机网卡一定能看到目标链路上的全部流量。
把现象翻译成可验证条件
“偶尔掉线”“通信很慢”不能直接用于复现。应把现象改写为机器或观察者可以明确判断的条件,例如“连续运行 20 分钟后,站号 3 连续出现 3 次响应超时”“负载超过某值后 EtherCAT 从 OP 退回 SAFE-OP”。
一条可用的复现记录通常包含四部分:初始条件、刺激动作、预期正常行为和失败判据。例如先恢复指定工程和固件,稳定运行 5 分钟,再启动固定负载;若控制器日志出现目标错误码,同时抓包中对应请求没有按协议时限获得响应,则判定故障复现成功。
按时间线关联日志和报文
定位时从最接近用户现象的时间点向前回溯,而不是从抓包第一帧开始逐帧阅读。先在控制器或设备日志中找到异常时间,再检查该时间附近是否存在重传、超时、异常状态字、链路重协商或周期抖动。
例如日志在 10:32:14.250 报告从站超时,而报文显示最后一个正常响应出现在 10:32:14.100,随后只有请求没有响应,那么可以先把范围缩小到“请求已发送之后、响应返回之前”。如果同一时刻交换机端口也发生链路事件,则应进一步调查物理链路;如果链路稳定而设备内部日志显示任务阻塞,则重点转向设备处理能力和调度。
证据链的关键不是收集越多越好,而是每条证据能够回答一个问题:故障在哪里开始,后续现象只是结果还是新的根因。
用对照实验验证修复
修复之后必须重新执行与原故障相同的复现步骤,并保留修复前后的两组证据。只看到“一次没出错”不足以证明问题解决,应使用相同负载、持续时间和失败判据进行多轮测试。
验收记录至少应写明修复内容、修复后的配置版本、重复次数和结果。如果原问题平均 10 分钟出现一次,而修复后只运行 2 分钟,测试强度明显不足;如果原故障只在高总线负载时出现,也不能用空载运行作为验收。
一个完整证据链最终应该能够让另一名工程师在不了解现场口头背景的情况下,依据同一拓扑和配置重建环境,按步骤触发故障,利用日志与报文看到相同现象,再应用修复并得到可重复的正常结果。做到这一点,偶发故障才真正从“经验问题”变成了可验证的工程问题。