
工业通信与现场总线 / 系统课时
测量时延抖动与周期超限
测量时延抖动与周期超限
周期性工业通信不仅要求“最终收到报文”,还要求报文在预算时间内到达。本节用抓包时间戳和主站周期统计把平均时延、最大时延与抖动量化出来,再通过负载、操作系统调度和从站处理时间的证据定位周期超限来源。
学习目标
- 从抓包时间戳计算响应时间和周期抖动
- 区分网络排队、主站调度和从站处理造成的时延
- 建立周期预算并验证优化前后的最坏情况是否满足要求
先明确测量指标
平均响应时间只能描述总体水平,不能证明实时性。工业控制更关注最大响应时间、长尾分布以及周期抖动,因为一次偶发的超限就可能导致看门狗触发或控制周期错过截止时间。
对于请求—响应通信,可把单次响应时间定义为从主站发送请求到收到对应响应之间的时间差。若控制任务计划每 毫秒启动一次,第 次实际启动间隔为 ,则可用 描述该周期相对目标值的偏差。
从抓包时间戳计算响应时间
以 Modbus TCP 为例,可以让 tshark 输出帧时间、事务标识和请求或响应字段,再用事务 ID 配对。下面先抓取 20 秒流量并写入文件,便于后续重复分析。
timeout 20s tshark -i eth0 -f "tcp port 502" -w modbus-latency.pcapng预期输出
Capturing on 'eth0'
<COUNT> packets captured
<COUNT> 取决于实际总线负载。抓包完成后,可导出绝对时间戳、事务 ID 和帧号进行分析。
tshark -r modbus-latency.pcapng -Y modbus -T fields -e frame.number -e frame.time_epoch -e modbus.trans_id -e modbus.func_code预期输出
1	<TIME>	<ID>	3
2	<TIME>	<ID>	3
...
同一事务 ID 的请求和响应时间戳相减即可得到一次往返响应时间。若协议没有事务 ID,则需要结合方向、站号、功能码和报文顺序进行配对,避免把相邻的其他报文误认为响应。
把时延拆成三类来源
单次响应时间通常可以拆成主站发起延迟、网络传输与排队、从站处理三个部分。仅看一个总时间值无法知道瓶颈在哪,因此需要把抓包结果与主站任务统计、设备诊断值放在同一时间轴上观察。
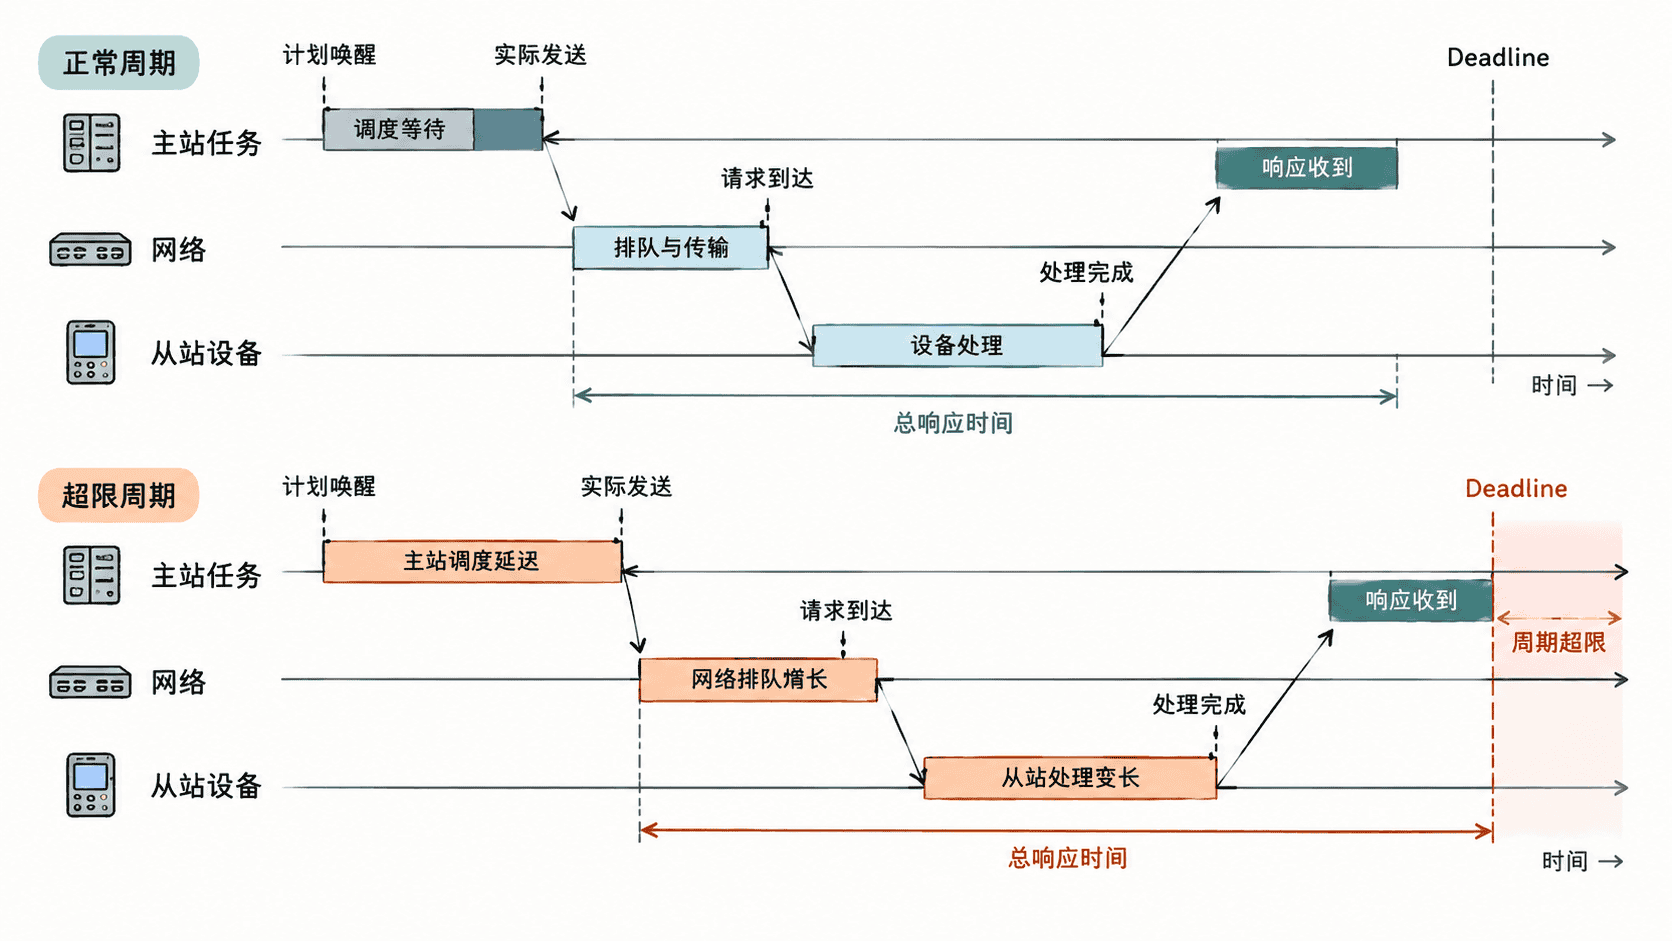
如果抓包显示请求本身就比计划时间晚发出,而网络往返时间仍稳定,应优先检查主站 CPU 占用、线程优先级、垃圾回收、中断风暴或非实时操作系统调度。若请求按时发送,但高负载时请求与响应之间的间隔显著增加,则需要检查交换机队列、带宽占用、广播流量和链路重传。
如果请求到达从站后,响应发送时间随设备内部负载明显变化,而网络传输时间稳定,则瓶颈更可能是 PLC 扫描周期、设备固件任务或应用处理。此时单纯升级交换机通常不会解决问题。
统计周期抖动和最坏情况
抓包得到时间戳后,应至少统计样本数、平均值、最大值和高分位值。只记录平均值容易掩盖少量严重超限。下面的 Python 示例读取一列以毫秒表示的周期测量值,并计算基本统计量;文件 period_ms.txt 每行放一个实测周期。
from pathlib import Path
from statistics import mean

samples = [float(line) for line in Path("period_ms.txt").read_text().splitlines() if line.strip()]
samples.sort()

def percentile(values, p):
    index = round((len(values) - 1) * p)
    return values[index]

print(f"samples={len(samples)}")
print(f"mean_ms={mean(samples):.3f}")
print(f"max_ms={max(samples):.3f}")
print(f"p99_ms={percentile(samples, 0.99):.3f}")
预期输出
samples=<COUNT>
mean_ms=<TIME>
max_ms=<TIME>
p99_ms=<TIME>
<COUNT> 和 <TIME> 由实际采样数据决定。若目标周期是 10 ms,而平均值为 9.8 ms、最大值却达到 18 ms,就不能因为平均值合格而判定系统满足实时性要求。
按证据定位超限根因
定位时应保持负载可控,并逐步增加变量。先在低网络负载、低 CPU 占用下建立基线,再增加正常业务流量;随后分别观察主站任务调度延迟、链路利用率、重传和从站处理时间。这样才能判断超限是随哪个因素同步出现。
网络负载问题通常表现为利用率上升时延迟同步扩大;主站调度问题则可能在网络空闲时仍出现周期启动偏移;设备处理问题常体现为特定从站或特定功能请求变慢,而其他节点保持稳定。三者也可能叠加,因此应保留同一时间窗口内的抓包、主站日志和设备诊断数据。
优化完成后,用相同采样时长、相同业务负载和相同统计口径重新测量。真正有效的修复应让最大时延和高分位值一起下降,并让周期超限次数在规定的验收窗口内满足要求,而不仅是让平均值变得更漂亮。