
工业通信与现场总线 / 系统课时
测量周期抖动与丢帧
测量周期抖动与丢帧
EtherCAT 网络“偶尔卡一下”不能只看平均周期。本节同时记录实际循环周期、最大抖动和 Working Counter(WKC),把问题拆成实时任务调度、网卡发送接收和 EtherCAT 链路三个层面,从测量数据判断瓶颈在哪里。
学习目标
- 用单调时钟计算 EtherCAT 主站实际循环周期与最大抖动
- 使用 WKC 识别过程数据交换不完整的周期
- 根据抖动和 WKC 的组合现象区分主站调度问题与链路问题
先定义要测什么
假设目标控制周期为 ,第 次循环的实际间隔为 ,则本周期抖动可以写成 。平均周期接近目标值并不能证明实时性良好,因为一次数百微秒的长延迟就可能使驱动器错过期望的更新时间窗。
WKC 则是 EtherCAT 数据报被从站正确处理后累计得到的工作计数。主站通常会根据当前过程数据映射得到期望 WKC;若某周期实际 WKC 小于期望值,说明至少有部分过程数据没有按预期完成处理,需要继续检查从站状态、物理链路或报文交换。
在周期任务中采样
下面使用 SOEM 建立最小过程数据循环。程序以 1 ms 为目标周期,使用 CLOCK_MONOTONIC 统计相邻循环开始时间,记录最大抖动,并比较实际 WKC 与 SOEM 根据映射计算出的期望值。示例运行 5000 个周期,因此可以快速发现明显的调度尖峰或 WKC 异常。
#include <stdio.h>
#include <stdlib.h>
#include <stdint.h>
#include <time.h>
#include <unistd.h>
#include <ethercat.h>

#define EC_TIMEOUTMON 500
#define CYCLE_NS 1000000LL
#define LOOPS 5000

static char iomap[4096];

static int64_t ns_diff(struct timespec a, struct timespec b) {
    return (a.tv_sec - b.tv_sec) * 1000000000LL +
           (a.tv_nsec - b.tv_nsec);
}

static int64_t abs64(int64_t v) {
    return v < 0 ? -v : v;
}

int main(int argc, char *argv[]) {
    if (argc != 2) {
        fprintf(stderr, "usage: %s <ifname>\n", argv[0]);
        return 1;
    }

    if (!ec_init(argv[1]) || ec_config_init(FALSE) <= 0) {
        fprintf(stderr, "EtherCAT initialization failed\n");
        return 1;
    }

    ec_config_map(&iomap);
    ec_configdc();
    ec_statecheck(0, EC_STATE_SAFE_OP, EC_TIMEOUTSTATE * 4);

    ec_slave[0].state = EC_STATE_OPERATIONAL;
    ec_writestate(0);
    ec_statecheck(0, EC_STATE_OPERATIONAL, EC_TIMEOUTSTATE * 4);

    int expected_wkc = (ec_group[0].outputsWKC * 2) + ec_group[0].inputsWKC;
    int bad_wkc = 0;
    int64_t max_jitter = 0;
    struct timespec prev, now;

    clock_gettime(CLOCK_MONOTONIC, &prev);

    for (int i = 0; i < LOOPS; ++i) {
        struct timespec sleep_time = { .tv_sec = 0, .tv_nsec = CYCLE_NS };
        nanosleep(&sleep_time, NULL);
        clock_gettime(CLOCK_MONOTONIC, &now);

        int64_t period = ns_diff(now, prev);
        int64_t jitter = abs64(period - CYCLE_NS);
        if (jitter > max_jitter) max_jitter = jitter;
        prev = now;

        ec_send_processdata();
        int wkc = ec_receive_processdata(EC_TIMEOUTRET);
        if (wkc < expected_wkc) ++bad_wkc;
    }

    printf("expected_wkc=%d\n", expected_wkc);
    printf("max_jitter_us=%.1f\n", max_jitter / 1000.0);
    printf("bad_wkc_cycles=%d/%d\n", bad_wkc, LOOPS);

    ec_slave[0].state = EC_STATE_INIT;
    ec_writestate(0);
    ec_close();
    return 0;
}
编译并运行:
gcc cycle_probe.c -o cycle_probe -lsoem -lpthread
sudo ./cycle_probe <IFACE>
预期输出
expected_wkc=<WKC>
max_jitter_us=<JITTER_US>
bad_wkc_cycles=<BAD_COUNT>/5000<WKC>、<JITTER_US> 与 <BAD_COUNT> 都取决于实际从站映射、操作系统负载和网络状态。这个示例使用相对 nanosleep(),适合教学测量,不代表生产级实时循环;正式主站通常还会使用绝对时间唤醒、实时调度策略、CPU 亲和性以及更严格的内存与中断控制。
根据结果缩小范围
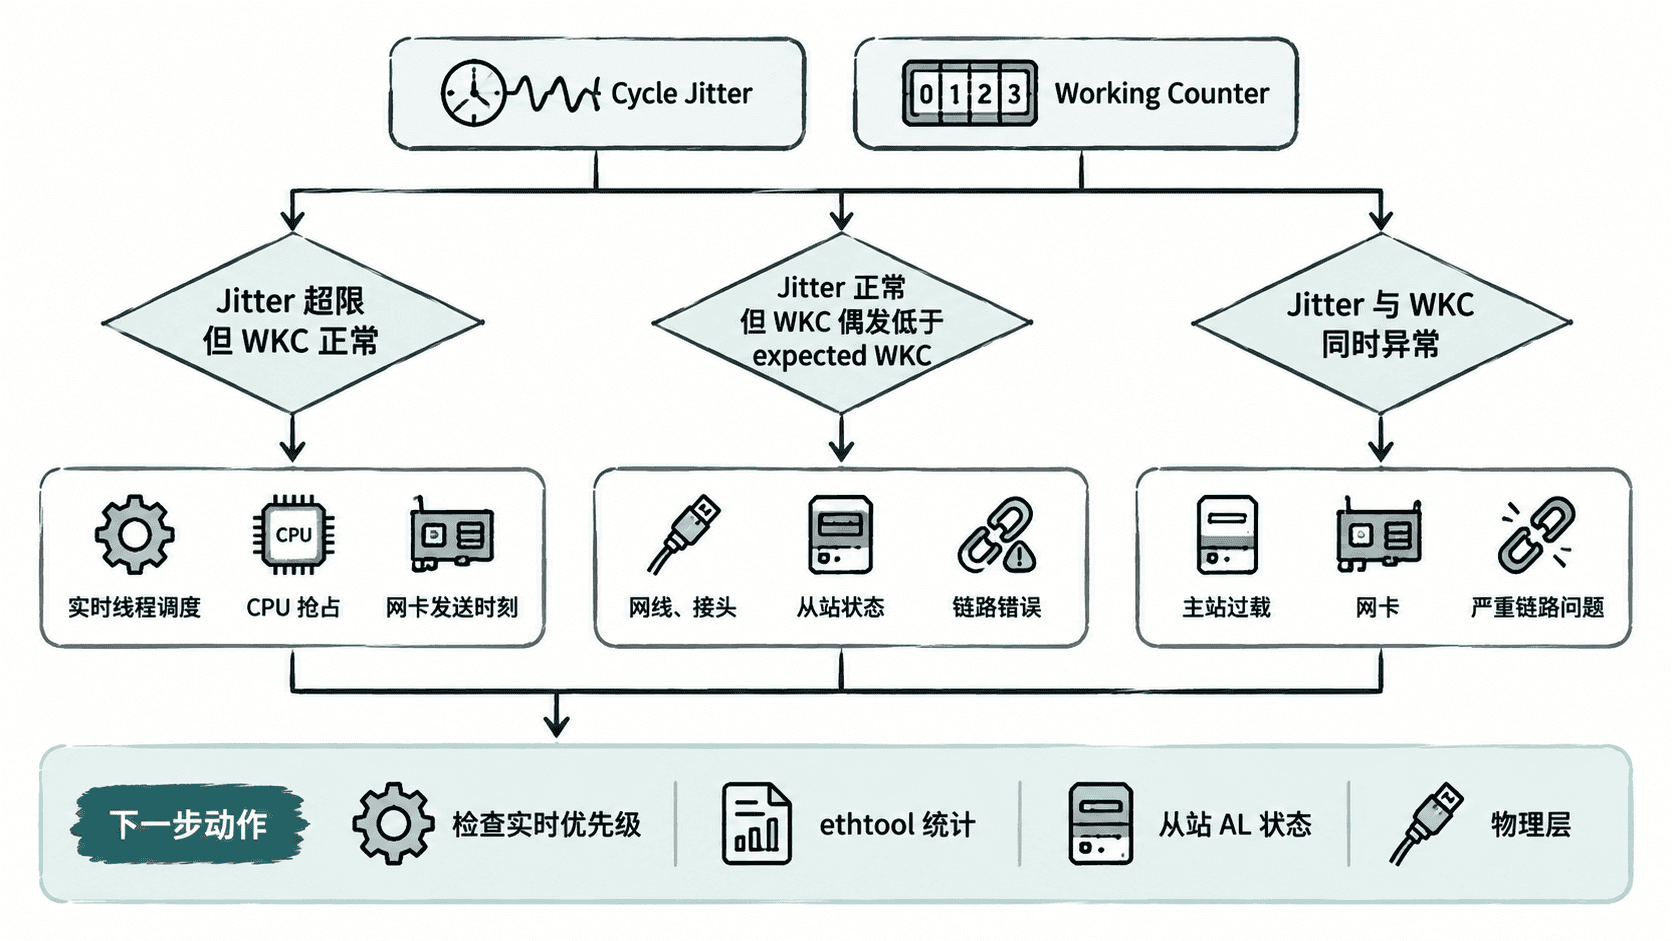
如果最大抖动明显超标,但 bad_wkc_cycles 始终为 0,优先检查主站侧。常见原因包括线程被普通任务抢占、CPU 频率或节能策略造成延迟、IRQ 与控制线程竞争,以及网卡中断处理延后。此时 EtherCAT 帧仍能完整交换,只是发送与处理时间不够稳定。
如果周期抖动平稳,而 WKC 偶尔低于期望值,应优先检查 EtherCAT 链路与从站状态,包括网线和接头、从站掉线或重启、端口错误计数以及设备没有保持在 OP 状态。WKC 异常不能简单等同于“物理丢帧”,因为从站状态不正确或过程数据未按预期处理同样会导致 WKC 偏低。
主站使用普通以太网控制器时,还可以辅助查看网卡统计:
ethtool -S <IFACE>预期结果
NIC statistics:
     <COUNTER_NAME>: <VALUE>
     ...
不同驱动暴露的计数器名称不同,因此应关注是否存在持续增长的 RX/TX error、drop、CRC 或类似错误,而不是依赖某个固定字段名。
建立可复现的验收线
测量时应同时保存目标周期、最大抖动、WKC 异常次数、CPU 负载以及测试持续时间。单次五秒测试只能发现明显问题,生产验收应在真实控制负载下持续更长时间,并关注最大值和异常次数,而不只看平均值。
当调高实时线程优先级或隔离 CPU 后抖动下降而 WKC 没有变化,瓶颈主要在主站调度;当更换线缆或修复从站链路后 WKC 异常消失而周期分布基本不变,则证据更指向网络侧。只有把周期时间与 WKC 放在同一条时间线上观察,才能避免把所有实时异常都误判为“EtherCAT 丢帧”。