
嵌入式 Linux 与 RTOS / 系统课时
控制启动时间和资源占用
控制启动时间和资源占用
优化嵌入式 Linux 启动速度时,最容易犯的错误是先删服务、先裁内核,却没有建立可重复的时间基线。本节从测量开始,把启动链拆成 Bootloader、Kernel、userspace 与应用就绪几个阶段,再沿关键路径优化,并同时检查内存、存储和 CPU 预算,避免用资源换来的“假快”。
学习目标
- 用串口时间戳、内核日志与
systemd-analyze分段测量启动时间。 - 根据关键路径选择内核裁剪、服务并行或延迟初始化策略。
- 建立内存、存储和 CPU 的资源预算与验收方法。
先把“启动完成”定义成产品事件
“systemd 到达 multi-user.target”不一定等于设备已经可用。对产品应定义一个可观察的就绪事件,例如屏幕出现首帧、控制回路开始采样、网络 API 能返回健康检查,或者某个 GPIO 翻转。只有终点固定,优化前后的数据才可比较。
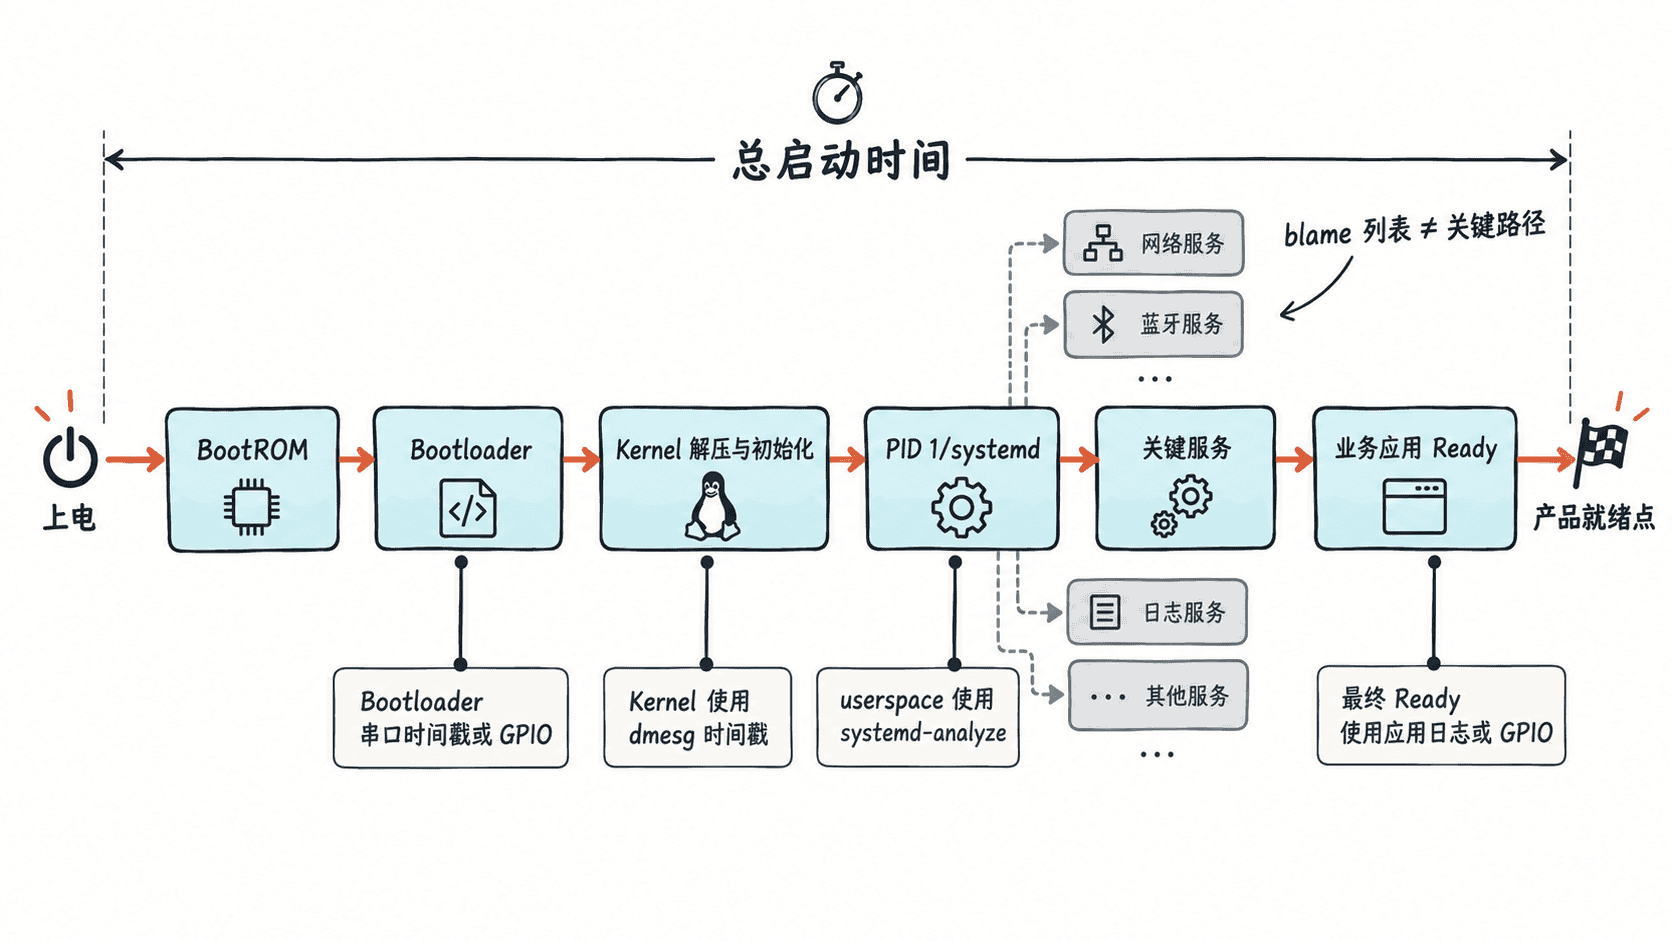
Bootloader 之前和之中的时间通常不在 Linux 日志范围内,因此需要串口打印、硬件计时器或 GPIO 边沿测量。内核接管之后,dmesg 时间戳可以看到驱动和子系统初始化;进入 systemd 后,再用 systemd-analyze 分析 userspace。把这些数据拼起来,才能避免只优化了其中一段。
用 systemd 找到真正的关键路径
在使用 systemd 的系统上,先记录总时间,再查看 critical chain。blame 适合找“单个服务花了多久”,但它不说明这些服务是否位于阻塞产品就绪的依赖链上,因此不能仅按 blame 排名逐个删除。
set -eu
systemd-analyze time
echo
echo 'critical chain:'
systemd-analyze critical-chain --no-pager
echo
echo 'slow units:'
systemd-analyze blame --no-pager | head -n 10
预期输出
Startup finished in <TIME> (kernel) + <TIME> (userspace) = <TIME>

critical chain:
<READY_TARGET> @<TIME>
└─<SERVICE_A>.service @<TIME> +<TIME>
  └─<SERVICE_B>.service @<TIME> +<TIME>

slow units:
<TIME> <SERVICE_X>.service
<TIME> <SERVICE_Y>.service<TIME>、目标名和服务名都取决于镜像与硬件。重复测量时应保持供电、存储介质、日志级别和外设连接条件一致,至少记录冷启动与热重启两组数据。
如果系统不用 systemd,仍可用同样思路:Bootloader 输出阶段时间,内核用带时间戳的串口日志或 dmesg,init 脚本与业务程序在关键点打印单调时钟时间。核心不是工具名称,而是让每一段都有可比较的起止证据。
按瓶颈类型优化而不是盲目裁剪
内核阶段慢,先确认是否有不需要的驱动、文件系统、网络协议或调试功能被编入;能做模块且不影响关键路径的功能可延后加载。但裁剪前必须确认恢复、升级、量产测试依赖,避免为了几百毫秒失去现场诊断能力。
userspace 阶段慢,应优先检查串行依赖。互不依赖的服务让 systemd 并行启动,不要人为添加宽泛的 After=;非首屏、非控制闭环、非首次网络响应所必需的服务,可以移出关键 target 或在产品 Ready 后延迟初始化。
I/O 密集型初始化要特别谨慎。把多个大服务“并行化”可能让闪存随机读更严重,最终反而更慢。优化后必须回到同一测量方法复测,比较总时间和关键路径,而不是只看单个服务的局部时间。
同时核对内存、存储和 CPU 预算
启动变快但常驻内存超预算、根分区没有升级余量或 CPU 长期满载,同样不合格。可以在产品 Ready 后采集一组资源快照,作为版本回归基线。
set -eu
echo 'memory:'
free -m
echo
echo 'storage:'
df -h / /var 2>/dev/null || df -h /
echo
echo 'top cpu processes:'
ps -eo pid,comm,%cpu,%mem --sort=-%cpu | head -n 6
预期输出
memory:
               total        used        free      shared  buff/cache   available
Mem:           <MB>         <MB>        <MB>       <MB>        <MB>        <MB>

storage:
Filesystem      Size  Used Avail Use% Mounted on
<DEVICE>        <SIZE> <SIZE> <SIZE> <PERCENT> /
<DEVICE>        <SIZE> <SIZE> <SIZE> <PERCENT> /var

top cpu processes:
    PID COMMAND         %CPU %MEM
   <ID> <PROCESS>       <PERCENT> <PERCENT>
动态值会因设备和负载变化。真正的预算应由产品约束反推,例如给 OTA 预留镜像与回滚空间,给峰值业务保留足够可用内存,并分别记录空闲、典型负载和压力场景下的 CPU 占用。
用回归门槛保护优化结果
把启动时间和资源预算纳入版本验收,而不是一次性人工观察。至少记录总启动时间、Kernel 时间、userspace 时间、产品 Ready 时间、峰值与稳定态内存、根分区剩余空间和典型 CPU 占用。新版本超过门槛时,再回看 critical chain、内核日志和包体变化。
这样建立起来的优化闭环是“定义 Ready → 分段测量 → 找关键路径 → 只改瓶颈 → 同条件复测 → 检查资源预算”。它比单纯追求某个漂亮的 systemd-analyze 数字更适合真实量产设备,因为最终约束的是产品可用时间和长期资源余量。