
嵌入式 Linux 与 RTOS / 系统课时
管理内存映射与 DMA 缓冲
管理内存映射与 DMA 缓冲
驱动同时面对 CPU 虚拟地址、物理内存、设备寄存器和 DMA 地址。把这些地址混在一起,轻则数据不一致,重则直接访问异常。本篇用 MMIO 与 DMA 两条主线,建立可直接用于驱动代码的分配、映射和同步边界。
学习目标
- 区分
kmalloc、vmalloc、ioremap与 DMA API 的职责 - 正确访问 MMIO,并区分 CPU 指针与设备可见的 DMA 地址
- 根据一致性需求选择 coherent 或 streaming DMA,并处理缓存所有权
先把四类内存用途分开
kmalloc 适合较小的普通内核缓冲区,返回 CPU 可直接访问的虚拟地址,并提供物理连续内存,因此可作为 dma_map_single() 的常见输入,但仍必须经过 DMA API 得到设备地址。vmalloc 只保证虚拟连续,底层页通常分散,不能把返回值直接当成单段 DMA 缓冲区。
ioremap 的对象不是普通 RAM,而是设备树或总线资源描述的 MMIO 区域。映射后得到 __iomem 指针,应通过 readl()、writel() 等访问器读写。dma_alloc_coherent() 则一次返回 CPU 地址和 dma_addr_t:前者供驱动访问,后者才写入设备 DMA 寄存器或描述符。
| API | 主要用途 | CPU 看到的结果 | 能否直接给设备做 DMA 地址 |
|---|---|---|---|
kmalloc |
普通、小型内核缓冲 | 普通虚拟地址 | 不能,先 dma_map_single() |
vmalloc |
大块虚拟连续内存 | 虚拟连续地址 | 不能直接作为单段 DMA 地址 |
ioremap |
映射设备 MMIO | __iomem 地址 |
不适用 |
dma_alloc_coherent |
一致性 DMA 缓冲 | CPU 指针 + dma_addr_t |
使用返回的 dma_addr_t |
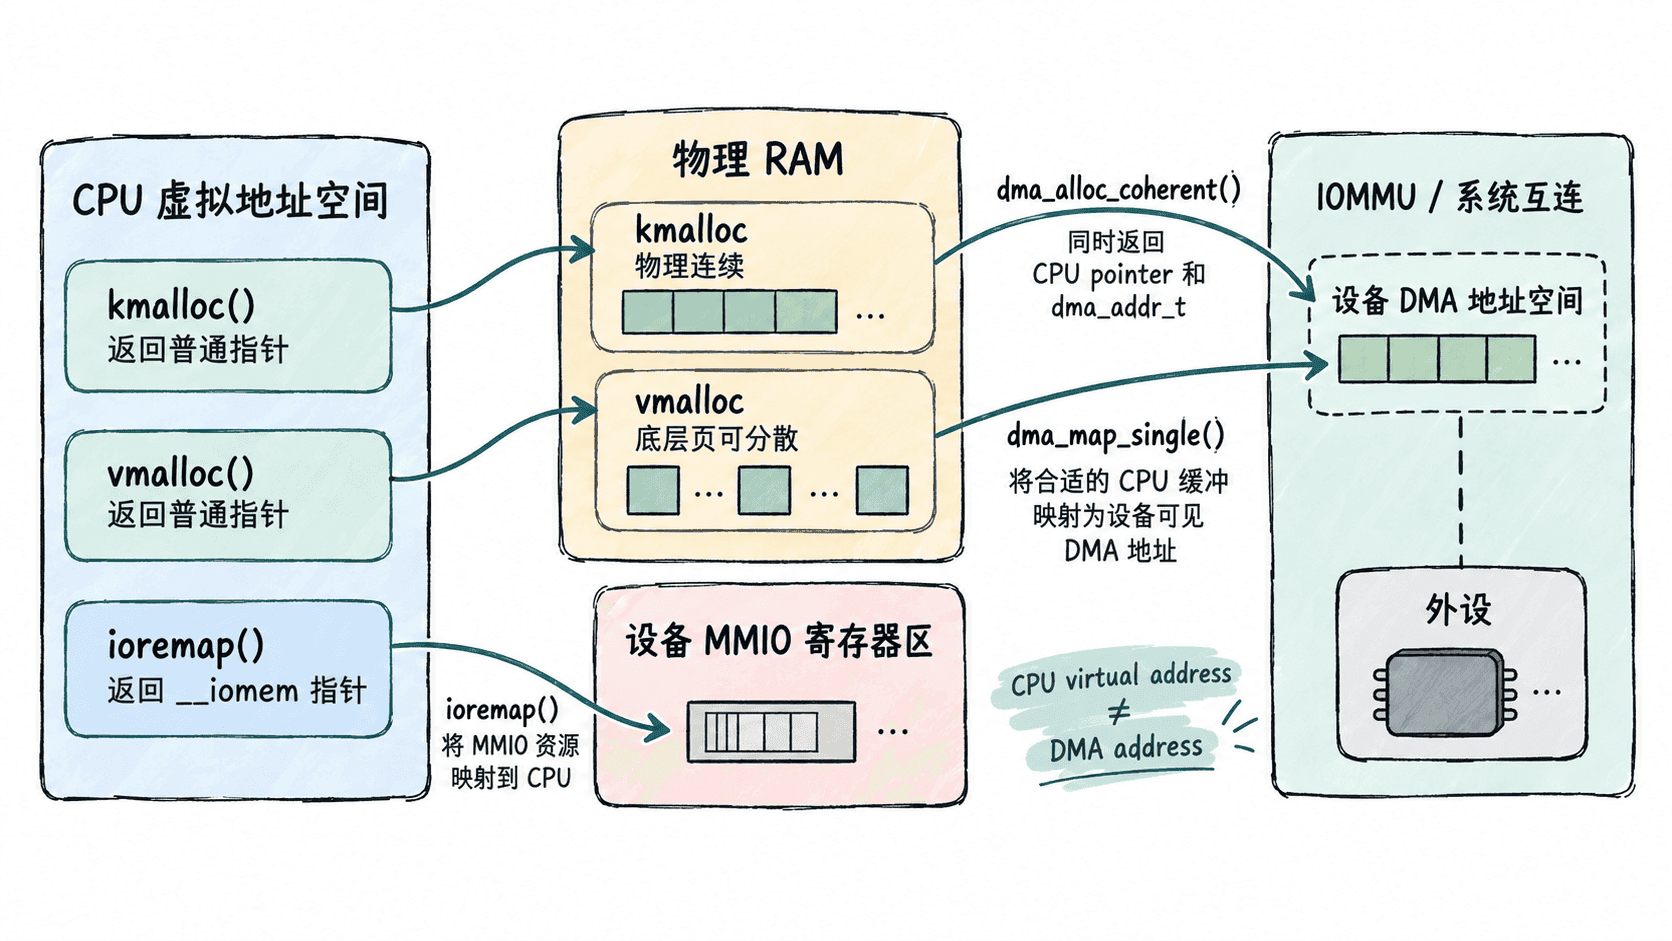
MMIO 只通过映射和访问器操作
平台驱动通常从资源中取得寄存器范围,再由托管接口完成映射。不要把设备物理地址强转成普通指针,也不要对 __iomem 指针做普通解引用;访问器会保留架构所需的 I/O 语义和顺序约束。
下面是片段示例,依赖平台驱动的 probe() 上下文以及设备树中的 reg 资源:
#include <linux/err.h>
#include <linux/io.h>
#include <linux/platform_device.h>

static int demo_hw_init(struct platform_device *pdev)
{
    void __iomem *regs;
    u32 status;

    regs = devm_platform_ioremap_resource(pdev, 0);
    if (IS_ERR(regs))
        return PTR_ERR(regs);

    /* 偏移量必须来自芯片手册,不能把普通内存访问替代 MMIO 访问器。 */
    writel(0x1, regs + 0x04);
    status = readl(regs + 0x08);

    dev_info(&pdev->dev, "status=0x%08x\n", status);
    return 0;
}
生效行为是:资源映射随设备生命周期自动释放,寄存器读写经 MMIO 访问器完成。验证时应结合芯片手册确认偏移和位定义,并检查内核日志中的 status;其值由真实硬件状态决定。
DMA 地址必须由 DMA API 产生
最容易出错的写法是把 cpu_addr、virt_to_phys() 的结果或 kmalloc() 返回值直接写入设备 DMA 寄存器。IOMMU、总线地址转换和设备 DMA mask 都可能让设备看到的地址与 CPU 地址不同,因此驱动应只使用 DMA API 返回的 dma_addr_t。
持续由 CPU 与设备共享的小型描述符环常用 coherent DMA。下面是片段示例,依赖有效的 struct device *dev,并要求释放时使用完全匹配的大小和地址:
#include <linux/dma-mapping.h>
#include <linux/mm.h>

struct demo_dma_buf {
    void *cpu_addr;
    dma_addr_t dma_addr;
    size_t len;
};

static int demo_dma_alloc(struct device *dev, struct demo_dma_buf *buf)
{
    buf->len = PAGE_SIZE;
    buf->cpu_addr = dma_alloc_coherent(dev, buf->len,
                                       &buf->dma_addr, GFP_KERNEL);
    if (!buf->cpu_addr)
        return -ENOMEM;

    /* CPU 访问 cpu_addr;写给设备的只能是 dma_addr。 */
    memset(buf->cpu_addr, 0, buf->len);
    return 0;
}

static void demo_dma_free(struct device *dev, struct demo_dma_buf *buf)
{
    dma_free_coherent(dev, buf->len, buf->cpu_addr, buf->dma_addr);
}
这类内存不需要驱动显式做 CPU cache clean/invalidate,但“缓存一致”不等于“操作顺序自动正确”。在填完描述符后再敲设备 doorbell 时,仍应按设备协议使用合适的内存屏障,避免设备先看到启动位、后看到描述符内容。
Streaming DMA 要遵守所有权边界
一次性或批量传输通常先分配普通缓冲,再用 dma_map_single()、dma_map_sg() 等建立 streaming 映射。映射可能失败,必须检查 dma_mapping_error();完成传输后要用参数匹配的 dma_unmap_*() 解除映射。
如果一个 streaming 映射长期保留并在 CPU 与设备之间反复移交,应在 CPU 读取设备写入数据前调用 dma_sync_single_for_cpu(),在 CPU 修改后再次交给设备前调用 dma_sync_single_for_device()。方向参数必须与真实数据流一致,不能为了省事长期使用错误方向。
判断地址能否交给设备时只问一个问题:这个值是不是 DMA API 明确返回的设备地址。CPU 普通指针用于读写内存,__iomem 指针用于 MMIO,dma_addr_t 用于设备 DMA;把三者分开,绝大多数映射与一致性错误都会在代码评审阶段被挡住。