
嵌入式 Linux 与 RTOS / 系统课时
排查内存泄漏与 OOM
排查内存泄漏与 OOM
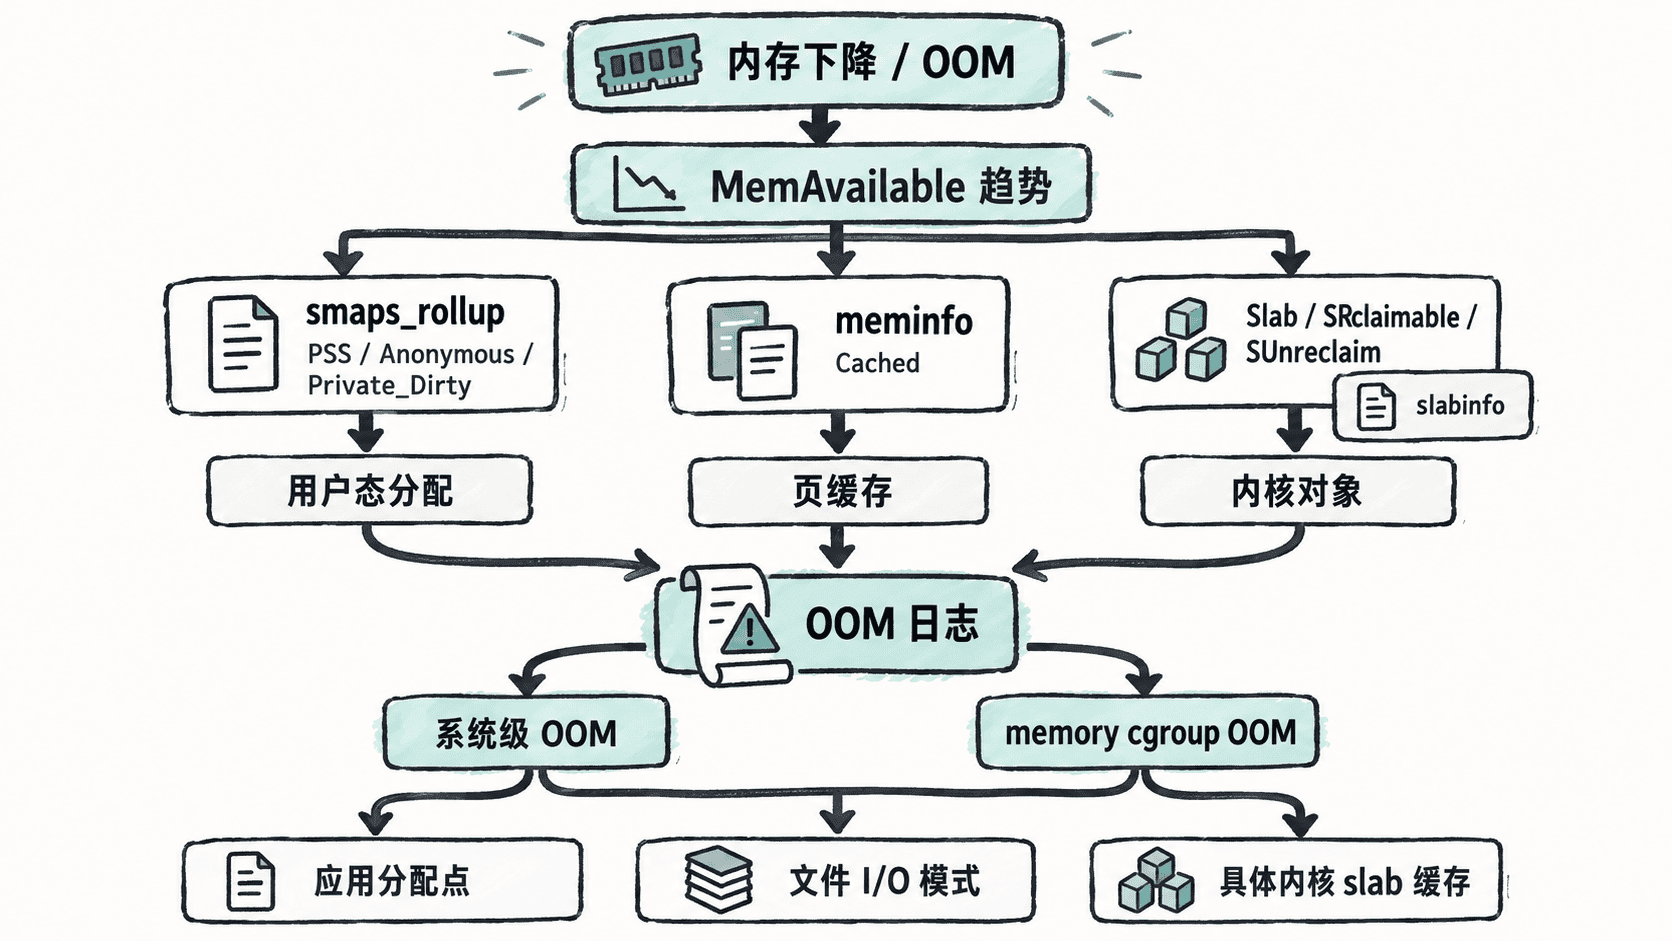
遇到内存持续下降或 OOM 时,只看 MemFree 很容易误判。本节把 /proc/meminfo、进程 smaps_rollup、slab 统计和 OOM 日志放到同一条证据链里,区分用户态泄漏、页缓存增长和内核对象增长,再决定追踪哪类分配来源。
学习目标
- 用
MemAvailable、进程 PSS 与匿名页判断用户态内存是否持续增长。 - 用
Cached、Slab、SReclaimable和SUnreclaim区分页缓存与内核对象压力。 - 从 OOM 日志确认触发范围和被杀进程,并把异常增长追到具体进程或 slab 缓存。
先把内存增长分成三类
Linux 会把空闲页用于页缓存,因此 MemFree 低并不等于泄漏。更有诊断价值的是趋势:用户态泄漏通常表现为某个进程的 PSS、匿名页或私有脏页持续上涨;页缓存增长通常伴随 Cached 上升且可被回收;内核对象增长则常体现为 Slab,尤其 SUnreclaim 持续增加。
建立可重复的内存快照
下面脚本一次采集系统、目标进程和 slab 的关键指标。把它保存为 mem-snapshot.sh,执行时传入目标进程名;如果没有权限读取 /proc/slabinfo,脚本会明确提示,而不是把缺失数据误当成 0。
#!/bin/sh
PROC_NAME="$1"
[ -n "$PROC_NAME" ] || { echo "usage: $0 process-name"; exit 2; }
PID="$(pidof "$PROC_NAME" | awk '{print $1}')"
[ -n "$PID" ] || { echo "process not running"; exit 1; }
[ -r "/proc/$PID/smaps_rollup" ] || { echo "cannot read target process"; exit 1; }

date '+time=%Y-%m-%d %H:%M:%S'
grep -E '^(MemAvailable|Cached|Dirty|Slab|SReclaimable|SUnreclaim):' /proc/meminfo
grep -E '^(Rss|Pss|Private_Clean|Private_Dirty|Anonymous|Swap):' "/proc/$PID/smaps_rollup"

if [ -r /proc/slabinfo ]; then
  awk 'NR > 2 { bytes=$3*$4; print bytes, $1 }' /proc/slabinfo |
    sort -nr | head -n 5
else
  echo "slabinfo: unavailable"
fi
预期结果会包含时间戳、系统可用内存、缓存与 slab 指标,以及目标进程的 RSS/PSS 等字段;数值会随负载变化。最后几行若可读取 slabinfo,会列出按“对象数乘对象大小”估算的前几个 slab 缓存。
连续以固定间隔采样时,关注趋势而不是单点:PSS 与 Anonymous 同步上升而业务负载回落后不下降,优先怀疑用户态泄漏;Cached 上升但 PSS 稳定,先检查文件 I/O 与缓存回收;SUnreclaim 与某个 slab 缓存同步增长,则应转向对应内核子系统。
从 OOM 日志确认触发范围
发生 OOM 后,先保留内核日志,再判断是整机内存耗尽还是 memory cgroup 达到限制:
dmesg | grep -iE 'out of memory|oom-killer|killed process|memory cgroup' | tail -n 20预期结果:若近期发生过 OOM,会出现 OOM 触发信息和被杀进程;若没有匹配输出,只能说明当前内核 ring buffer 中没有找到这些记录,不能据此证明系统从未发生 OOM。
系统级 OOM 通常伴随整机内存统计与 victim 选择;memory cgroup OOM 则可能在系统仍有可用内存时发生,因为某个容器或服务已达到自己的限制。两者的修复方向不同:前者要看全局分配与回收,后者还必须核对 cgroup 的内存上限和该组内进程。
把异常增长追到分配来源
确认是用户态增长后,再把范围从“进程变大”缩小到“哪类分配不释放”。有调试镜像和对应运行库时,可以在诊断构建中启用 AddressSanitizer 与 LeakSanitizer;资源受限的板卡则更适合先在相同代码路径的可控环境复现,再结合应用自身的分配计数、对象生命周期日志或堆分析工具定位。
如果增长来自内核,先用 /proc/slabinfo 找到持续扩大的缓存名称,再映射到对应子系统。例如 dentry、inode、网络缓冲或驱动私有 kmem cache 的增长,处理方法完全不同。不要直接执行 drop_caches 作为“修复”:它最多改变可回收缓存的现状,既不能证明没有泄漏,也不会释放仍被引用的用户态页或不可回收内核对象。
最终验收应同时满足两个条件:在相同业务负载下,异常指标不再单调增长;压力解除后,MemAvailable 能恢复到稳定区间且 OOM 不再复现。这样才能把“看起来内存变多了”与真正修复分开。