
嵌入式 Linux 与 RTOS / 系统课时
适配时钟、复位与电源资源
适配时钟、复位与电源资源
很多“驱动已经 probe,却读不到寄存器”或“设备完全没有响应”的根因,并不在总线协议,而在外设依赖的时钟、复位或供电没有进入可用状态。本篇把这三类资源放进同一条探测链路,建立设备树表达、驱动获取、启用顺序和失败回滚之间的对应关系。
学习目标
- 能用
clocks、resets和<name>-supply属性表达设备依赖。 - 能按供电、时钟、复位的约束组织 probe,并按相反顺序释放资源。
- 能根据内核日志和 debugfs 区分“资源不存在”“provider 尚未就绪”和“资源已获取但未启用”。
先把三类资源看成访问门槛
regulator 决定器件或电压域是否供电,clock 决定逻辑是否获得工作节拍,reset 决定模块是否仍被保持在复位状态。很多 MMIO 外设只有在这些前提满足后,寄存器访问才有意义。
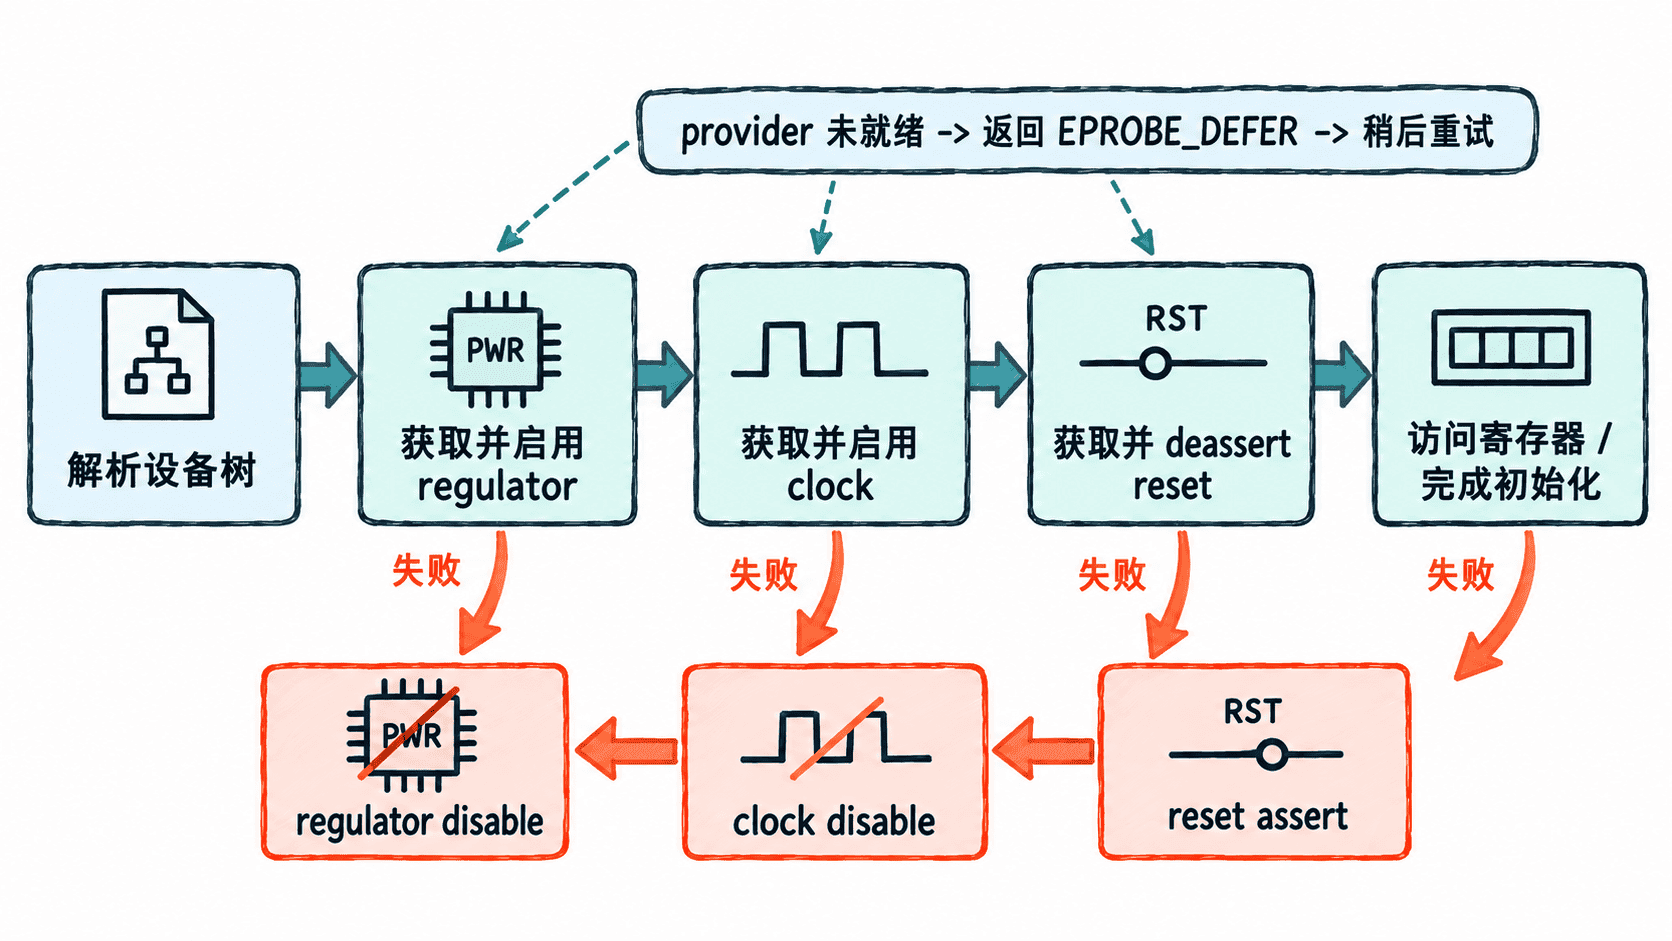
设备树只负责描述依赖关系,并不等于“写了属性就自动开资源”。驱动仍要通过 regulator、common clock framework 和 reset controller API 获取句柄并完成 enable、deassert 等动作。provider 尚未注册时,consumer 还可能返回 -EPROBE_DEFER,稍后重新 probe。
在设备树中表达依赖
下面是片段示例,展示一个 MMIO 外设依赖 3.3 V 电源、核心时钟和复位线。#clock-cells、#reset-cells 的参数数量由 provider binding 决定,因此 <12>、<7> 只是板级示意值。
peripheral@12340000 {
    compatible = "vendor,demo-peripheral";
    reg = <0x12340000 0x1000>;

    vdd-supply = <&vdd_3v3>;

    clocks = <&clkctrl 12>;
    clock-names = "core";

    resets = <&rstctrl 7>;
    reset-names = "core";

    status = "okay";
};
驱动调用 devm_regulator_get(dev, "vdd") 时,对应的是设备树属性 vdd-supply;调用 devm_clk_get(dev, "core") 和 devm_reset_control_get_exclusive(dev, "core") 时,则分别通过 clock-names 和 reset-names 找到对应资源。名字不一致时,资源本身存在也可能获取失败。
按依赖顺序完成 probe
多数外设都适合遵循“先供电,再开时钟,再撤复位,最后访问寄存器”的思路;真正顺序仍应以芯片手册为准。下面是片段示例,依赖平台驱动上下文和一个含 vdd、clk、rst 字段的私有结构体。
static int demo_probe(struct platform_device *pdev)
{
    struct device *dev = &pdev->dev;
    struct demo_priv *priv;
    int ret;

    priv = devm_kzalloc(dev, sizeof(*priv), GFP_KERNEL);
    if (!priv)
        return -ENOMEM;

    priv->vdd = devm_regulator_get(dev, "vdd");
    if (IS_ERR(priv->vdd))
        return dev_err_probe(dev, PTR_ERR(priv->vdd), "get vdd failed\n");

    ret = regulator_enable(priv->vdd);
    if (ret)
        return dev_err_probe(dev, ret, "enable vdd failed\n");

    priv->clk = devm_clk_get(dev, "core");
    if (IS_ERR(priv->clk)) {
        ret = dev_err_probe(dev, PTR_ERR(priv->clk), "get core clock failed\n");
        goto err_power;
    }

    ret = clk_prepare_enable(priv->clk);
    if (ret)
        goto err_power;

    priv->rst = devm_reset_control_get_exclusive(dev, "core");
    if (IS_ERR(priv->rst)) {
        ret = dev_err_probe(dev, PTR_ERR(priv->rst), "get reset failed\n");
        goto err_clock;
    }

    ret = reset_control_deassert(priv->rst);
    if (ret)
        goto err_clock;

    platform_set_drvdata(pdev, priv);
    return 0;

err_clock:
    clk_disable_unprepare(priv->clk);
err_power:
    regulator_disable(priv->vdd);
    return ret;
}
这段代码的关键不是固定 API 模板,而是成功路径按依赖正向打开,失败路径按相反顺序回滚。如果驱动在撤复位后还有更多可能失败的初始化步骤,还应在对应错误路径重新 assert reset,避免卸载或重试时把硬件留在半初始化状态。
用日志和 debugfs 判断卡在哪一层
先看 probe 日志,再看时钟和 regulator 的实际状态。下面命令中的 <DRIVER>、<CLOCK> 按实际名称替换;debugfs 节点是否存在取决于内核配置。
dmesg | grep -Ei '<DRIVER>|probe|clock|reset|regulator'
grep -w '<CLOCK>' /sys/kernel/debug/clk/clk_summary
cat /sys/kernel/debug/regulator/regulator_summary
预期结果不是固定数值,而是能看到目标资源的存在性与启用状态;时钟频率、引用计数和 regulator 名称会随平台变化。
<CLOCK> ... enable_count <N> ... rate <FREQ>
<REGULATOR> ... <STATE> ... <VOLTAGE>
如果日志反复出现 deferred probe,优先确认 clock/reset/regulator provider 自己是否已成功 probe,以及设备树 phandle 是否指向正确节点;如果资源能获取但 enable_count 仍为 0,检查驱动是否真正执行了 enable 路径;如果时钟已开、复位仍未撤销,则继续查 reset 名称、极性和芯片手册要求。
验收资源链路
完成适配后,不要只以“驱动没有报错”作为通过标准。至少确认设备节点成功绑定、目标时钟进入预期频率、必要电源 rail 已启用,并在驱动允许的情况下确认 reset 已退出。随后再读设备 ID、状态寄存器或执行一次真实总线事务,才能证明资源链路已经支撑起外设访问。
当外设表现为“偶发可用”“冷启动失败但重启正常”时,更要回到这条依赖链检查时序和回滚,而不是先修改总线超时。时钟、复位和电源是驱动访问硬件之前的前置条件,只有它们的状态与数据手册一致,后续寄存器调试才有意义。