
数据结构与算法 / 系统课时
用前缀计数解决子数组问题
用前缀计数解决子数组问题
很多子数组题表面上要求枚举左右端点,真正可利用的是“区间结果等于两个前缀状态之差”。本节用前缀和配合哈希计数,把寻找目标子数组从平方级枚举降为一次线性扫描,并处理负数与重复前缀。
学习目标
- 把连续子数组条件改写成两个前缀状态之间的关系
- 用哈希表统计历史前缀状态出现次数,而不是只记录是否出现
- 正确处理初始前缀、重复状态以及包含负数的数组
把子数组改写成前缀状态差
设 prefix[t] 表示前 t 个元素之和,那么下标区间 [l, r] 的元素和等于 prefix[r + 1] - prefix[l]。因此,要寻找和等于 k 的子数组,在扫描到当前前缀和 p 时,只需要知道历史上有多少个前缀和等于 p - k。
这一步把“选择两个端点”改写成了“查询一个历史状态”。如果 p - k 曾出现三次,就意味着以当前位置结尾的合法子数组有三个,而不是只有一个,所以哈希表必须保存出现次数。
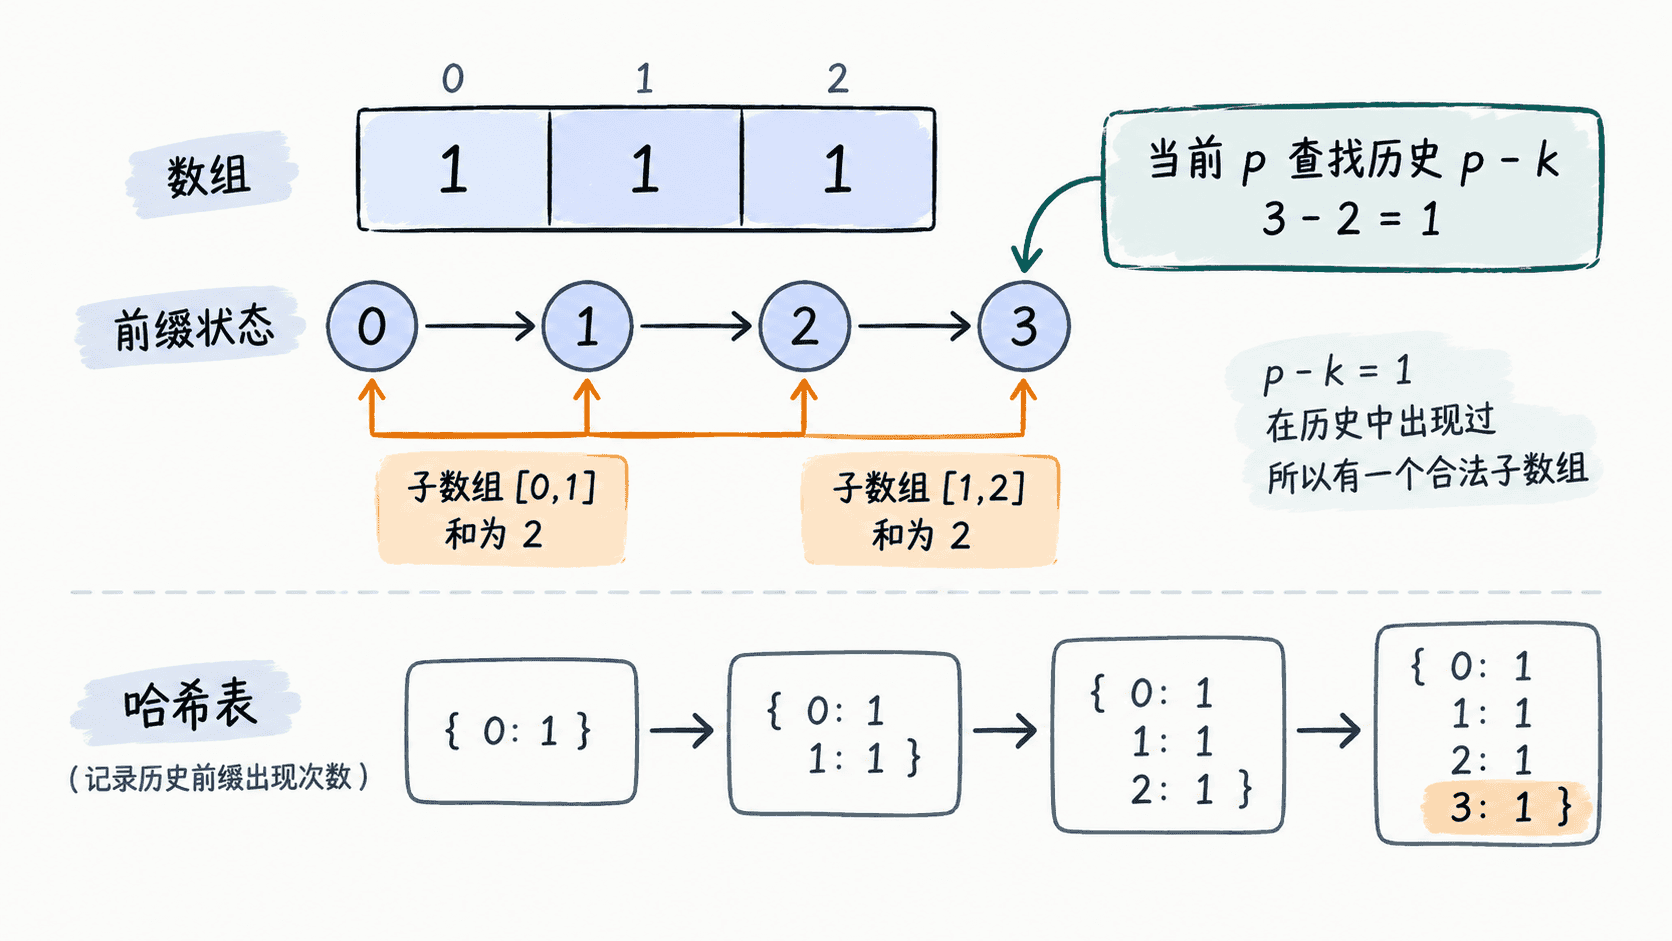
哈希表开始时要放入 0: 1。它表示在读取任何元素之前,前缀和 0 已经出现一次,这样从数组下标 0 开始、元素和恰好等于 k 的子数组也能被统一统计。
扫描时先查询再记录
扫描每个元素时,顺序是:先更新当前前缀和,再查询 prefix - k 的历史次数,最后把当前前缀和写入哈希表。尤其当 k = 0 时,如果先记录当前状态再查询,就会把当前前缀和与自己配对,错误地统计一个空子数组。
下面的完整程序实现 LeetCode 560 类问题,并额外用一个目标和为 0 的例子验证重复前缀计数。
from collections import defaultdict
from typing import List


def subarray_sum(nums: List[int], k: int) -> int:
    count = defaultdict(int)
    count[0] = 1  # 空前缀,使从下标 0 开始的合法区间也能被统计

    prefix = 0
    answer = 0

    for value in nums:
        prefix += value
        # 这里只查询已经出现过的前缀,避免把当前位置与自身配对
        answer += count[prefix - k]
        count[prefix] += 1

    return answer


if __name__ == "__main__":
    print(subarray_sum([1, 1, 1], 2))
    print(subarray_sum([1, -1, 0], 0))
预期输出
2
3
第一个数组有两个和为 2 的连续子数组;第二个数组存在重复前缀和,因此同一个当前状态可能一次匹配多个历史位置。
为什么不能直接换成滑动窗口
滑动窗口通常依赖某种单调性:窗口扩大后结果只朝一个方向变化,缩小时朝另一个方向变化。数组允许负数时,这个条件会失效。例如加入一个负数可能让窗口和下降,此时无法仅根据当前和决定移动左端还是右端。
前缀计数不要求元素为正。它只利用等式 当前前缀 - 历史前缀 = 目标值,因此正数、负数和 0 都能统一处理。若题目明确限制为非负数组,并且只要求满足某种单调区间条件,滑动窗口才可能是更自然的方案。
记住三个边界
首先,初始化 count[0] = 1,否则会漏掉从数组开头形成的合法子数组。其次,哈希值保存的是出现次数而不是布尔值,因为不同起点可以共享同一个前缀状态。最后,在 Java、C++ 等固定宽度整数语言中,如果数组长度和值域较大,前缀和应使用足够宽的整数类型以避免溢出。
这类题真正需要识别的不是“前缀和”三个字,而是条件能否写成“当前累计状态减去某个历史累计状态”。一旦能这样改写,哈希计数通常就能把双端点枚举压缩成一次线性扫描。