
数据结构与算法 / 系统课时
用排序去重控制重复分支
用排序去重控制重复分支
含重复元素的回溯题,真正要去掉的不是“重复值”,而是会生成同一结果的等价分支。本篇用排序和层级边界区分同层去重、路径内再次使用与元素索引复用,最终形成一套可迁移到组合、子集和排列题的判断规则。
学习目标
- 识别同层重复分支与路径中合法重复值的区别
- 使用排序配合
start或used正确去重 - 根据题意决定下一层从
i还是i + 1继续搜索
重复答案通常来自同层等价选择
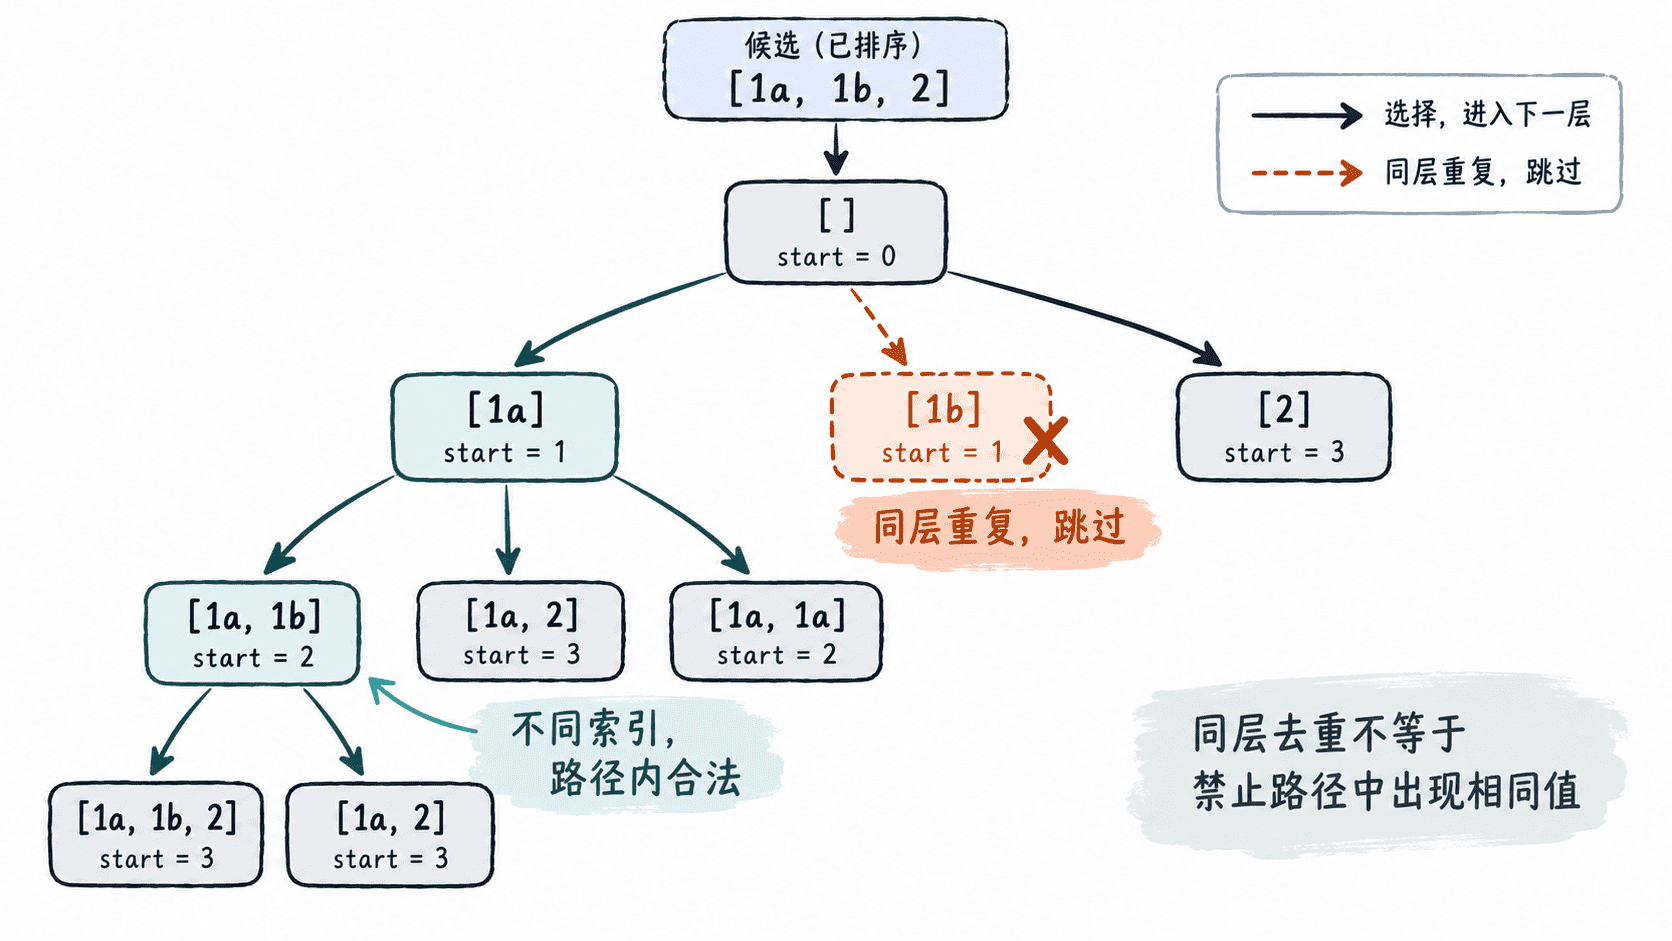
设输入中有两个值都为 1。若它们在同一递归层承担完全相同的角色,那么“先选第一个 1”和“先选第二个 1”会展开出等价子树,保留两棵子树只会制造重复答案。
但路径中出现两个 1 不一定错误。例如数组里本来就有两个 1,题目又允许每个索引使用一次,那么先选第一个 1、进入下一层后再选第二个 1,表示使用了两个不同元素,应该保留。
用排序和层级边界建立去重规则
排序让相同值相邻,因此可以只比较当前元素和前一个元素。组合与子集通常使用 start 表示本层可以选择的起点,核心条件是 i > start && nums[i] == nums[i - 1]:只有“当前层的第二个及以后相同值”才跳过。
这里的 i > start 很重要。若写成 i > 0,就会把上一层已经选择过某个值的情况也误判为重复,从而删掉合法路径。
元素能否在同一路径中再次使用,是另一条独立规则。递归到 i + 1 表示当前索引最多使用一次;递归到 i 表示下一层还可以继续选择当前元素,常见于允许无限次复用候选数的题目。去重条件控制横向兄弟分支,递归起点控制纵向路径复用。
主示例:组合总和中的同层去重
下面实现经典的 Combination Sum II:数组可能含重复值,每个索引最多使用一次,要求返回所有和为目标值的不同组合。
import java.util.ArrayList;
import java.util.Arrays;
import java.util.List;

public class Main {
    public static void main(String[] args) {
        int[] candidates = {10, 1, 2, 7, 6, 1, 5};
        int target = 8;

        Arrays.sort(candidates);
        List<List<Integer>> result = new ArrayList<>();
        backtrack(candidates, target, 0, new ArrayList<>(), result);

        System.out.println(result);
    }

    private static void backtrack(
            int[] candidates,
            int remain,
            int start,
            List<Integer> path,
            List<List<Integer>> result) {
        if (remain == 0) {
            result.add(new ArrayList<>(path));
            return;
        }

        for (int i = start; i < candidates.length; i++) {
            if (i > start && candidates[i] == candidates[i - 1]) {
                continue; // 只跳过当前递归层中的等值兄弟分支
            }
            if (candidates[i] > remain) {
                break; // 已排序,后续元素只会更大
            }

            path.add(candidates[i]);
            backtrack(candidates, remain - candidates[i], i + 1, path, result);
            path.remove(path.size() - 1);
        }
    }
}
预期输出:
[[1, 1, 6], [1, 2, 5], [1, 7], [2, 6]]第一次在根层遇到值 1 时会进入递归;根层的第二个 1 因为 i > start 且与前一个值相同而被跳过。进入第一条 1 分支后,新的 start 已变化,此时另一个 1 不再属于“同层重复”,所以组合 [1, 1, 6] 能正常产生。
迁移到排列和子集
子集去重与组合几乎相同:先排序,再用 i > start 跳过当前层重复值。排列没有 start 单调右移,而是用 used[i] 记录当前路径已占用的索引;常见条件是 nums[i] == nums[i - 1] && !used[i - 1],表示前一个等值元素在本层还没被使用时,不再从后一个等值元素开启等价分支。
判断重复题时先问两个问题:当前分支和同层前一个分支是否会生成同一批结果,以及当前索引在更深路径中是否允许再次使用。 前者决定去重条件,后者决定递归边界;把这两件事分开,就不容易出现“去重过度”或“重复答案仍然存在”的错误。