
数据结构与算法 / 系统课时
把题意翻译成输入输出约束
把题意翻译成输入输出约束
刷题时最危险的不是不会某个算法,而是把题目读成了另一个问题。本节建立一套固定翻译法:先把自然语言压缩成输入、输出、边界和不变量,再据此筛选算法,避免在错误理解上继续推导。
学习目标
- 从题目描述中提取输入对象、输出形式和合法取值范围
- 区分显式约束、隐含语义与解题过程中必须保持的不变量
- 用一张约束清单快速排除与题意冲突的算法方向
先把题目改写成接口
读题后不要立刻搜索“像不像双指针”。先回答两个问题:程序拿到什么,最终必须交回什么。这一步相当于把故事性描述改写成函数接口,能立即暴露对象类型、下标语义和返回值要求。
例如题目说:“给定整数数组 nums 和整数 target,返回两个不同下标,使对应元素之和等于 target;保证恰好存在一个答案,且同一元素不能重复使用。”
可以先压缩成:
- 输入:整数数组
nums,整数target - 输出:两个下标
i、j - 核心关系:
nums[i] + nums[j] == target - 身份约束:
i != j - 解存在性:恰好一个有效答案
这里最容易读错的是“返回下标”与“返回值”、“两个不同下标”与“两个不同数值”。值相同并不代表不能选,例如 [3, 3] 配合目标值 6 仍可能合法,只要使用的是两个位置。
把约束分成三层
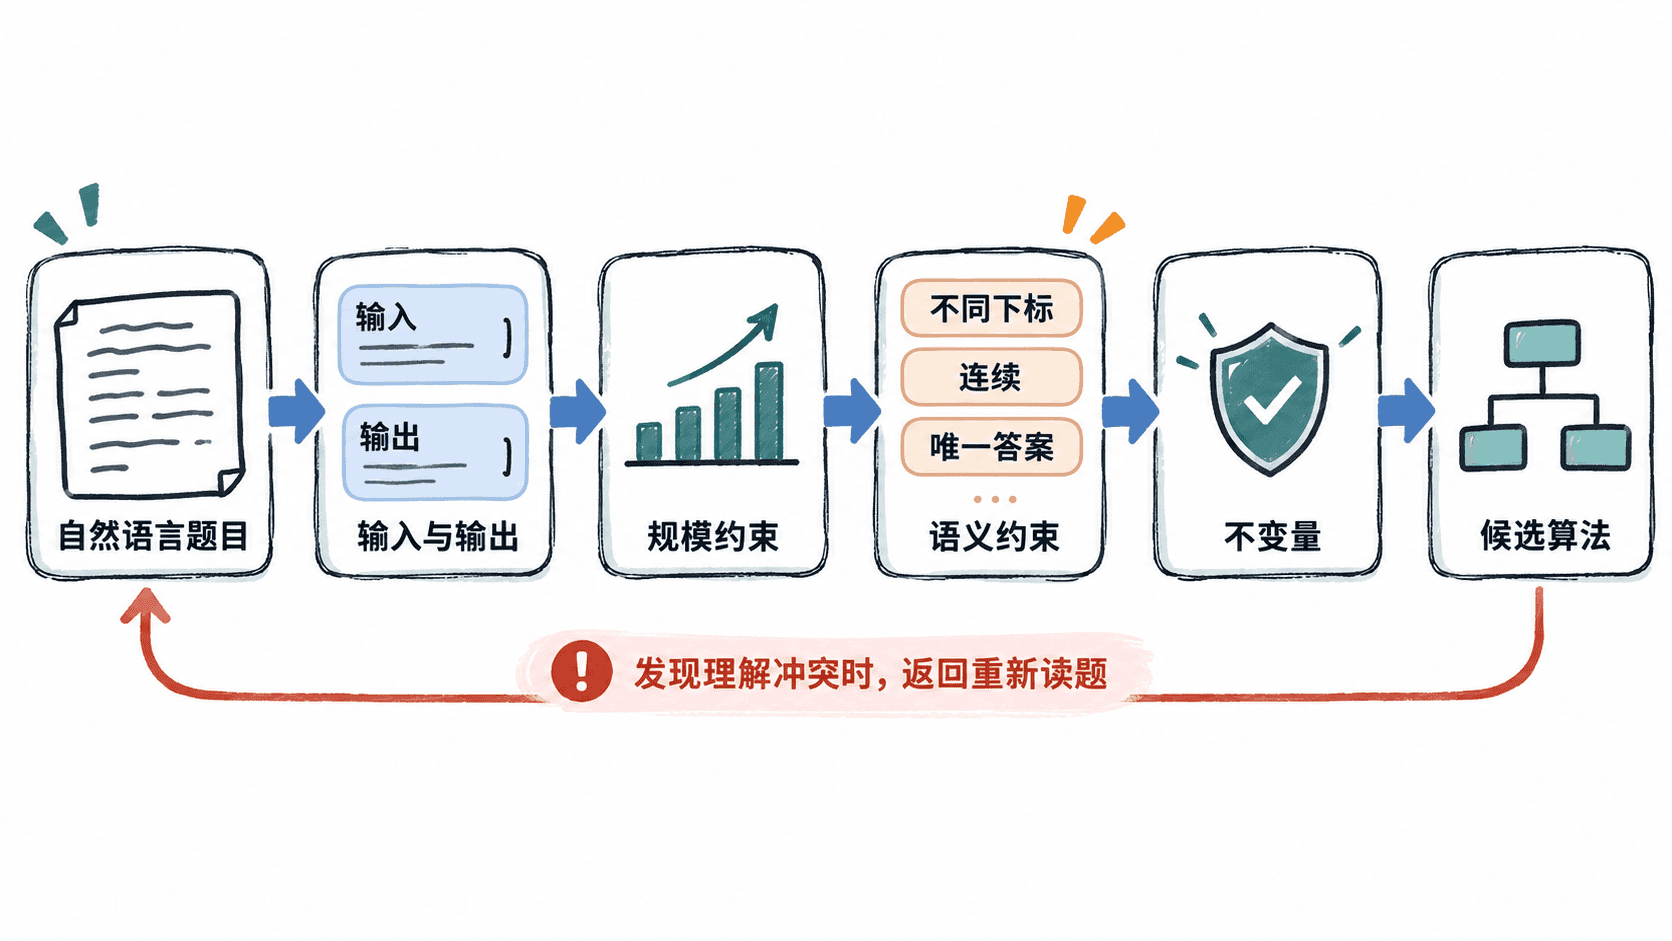
第一层是规模约束,例如数组长度上限、整数范围、图的点边数量。它决定时间和空间预算。若 n 只有几十,平方复杂度可能完全可接受;若 n 达到十万级,就要警惕 。
第二层是语义约束,例如“不能重复使用元素”“要求连续子数组”“只能向右移动”“答案唯一”。这些条件不一定直接出现在变量范围里,却会改变状态定义和算法选择。
第三层是输出约束,例如返回任意一个答案、全部答案、最短长度还是方案数量。即使输入相同,输出要求不同,也可能从布尔判断变成计数、路径恢复或枚举。
用不变量检查自己的理解
不变量不是“题目已经保证的事实”而已,它还包括算法运行过程中始终不能被破坏的条件。以滑动窗口为例,“窗口表示当前连续区间”就是结构不变量;以二分答案为例,“判定函数对答案具有单调性”才是算法成立的关键不变量。
读完题后,可以用一句话补完:“无论算法怎样推进,始终要保证 ______。”如果这句话写不出来,通常说明状态还没有定义清楚。
对于前面的两数之和例子,可以写成:“处理到位置 i 时,已记录的信息只来自此前位置,因此查到补数时不会重复使用当前位置。”这句话直接约束了哈希表的查询与插入顺序。
用约束反向筛选算法
算法选择应当来自约束,而不是题目表面的关键词。可以按下面顺序检查:
- 先看规模,估算能接受的复杂度数量级。
- 再看数据结构特征,例如是否有序、是否连续、是否是树或图。
- 检查语义约束是否要求去重、保序、原地修改或恢复方案。
- 最后验证候选算法的不变量是否真的成立。
当一个方向看起来“很像经典模板”却解释不了某条约束时,应优先怀疑方向而不是强行套模板。稳定的刷题习惯,是先得到一份准确的问题规格,再开始写代码;很多所谓“算法不会”,实际是输入、输出或边界在最开始就翻译错了。