
数据结构与算法 / 系统课时
用排序统一处理区间关系
用排序统一处理区间关系
区间题难点通常不在遍历,而在区间原本无序,导致重叠、包含和断开关系同时出现。把区间按左端点排序后,只需维护一个当前区间并线性扫描,就能稳定处理合并、覆盖统计和冲突判断。
学习目标
- 理解为什么按左端点排序后,区间关系会变得局部可判断
- 掌握“排序 + 维护当前区间”的标准扫描套路
- 能根据闭区间、半开区间等边界语义调整重叠条件
排序为什么能简化区间关系
设每个区间为 [start, end]。如果直接处理无序区间,一个新区间可能与前面任意多个区间发生关系,很难只看相邻元素得出结论。
按 start 从小到大排序后,扫描到新区间时,它的左端点不会小于之前区间的左端点。因此,只要前面已经把所有可合并区间压缩成一个“当前区间”,新区间是否与历史结果重叠,只需和当前结果的最后一个区间比较。
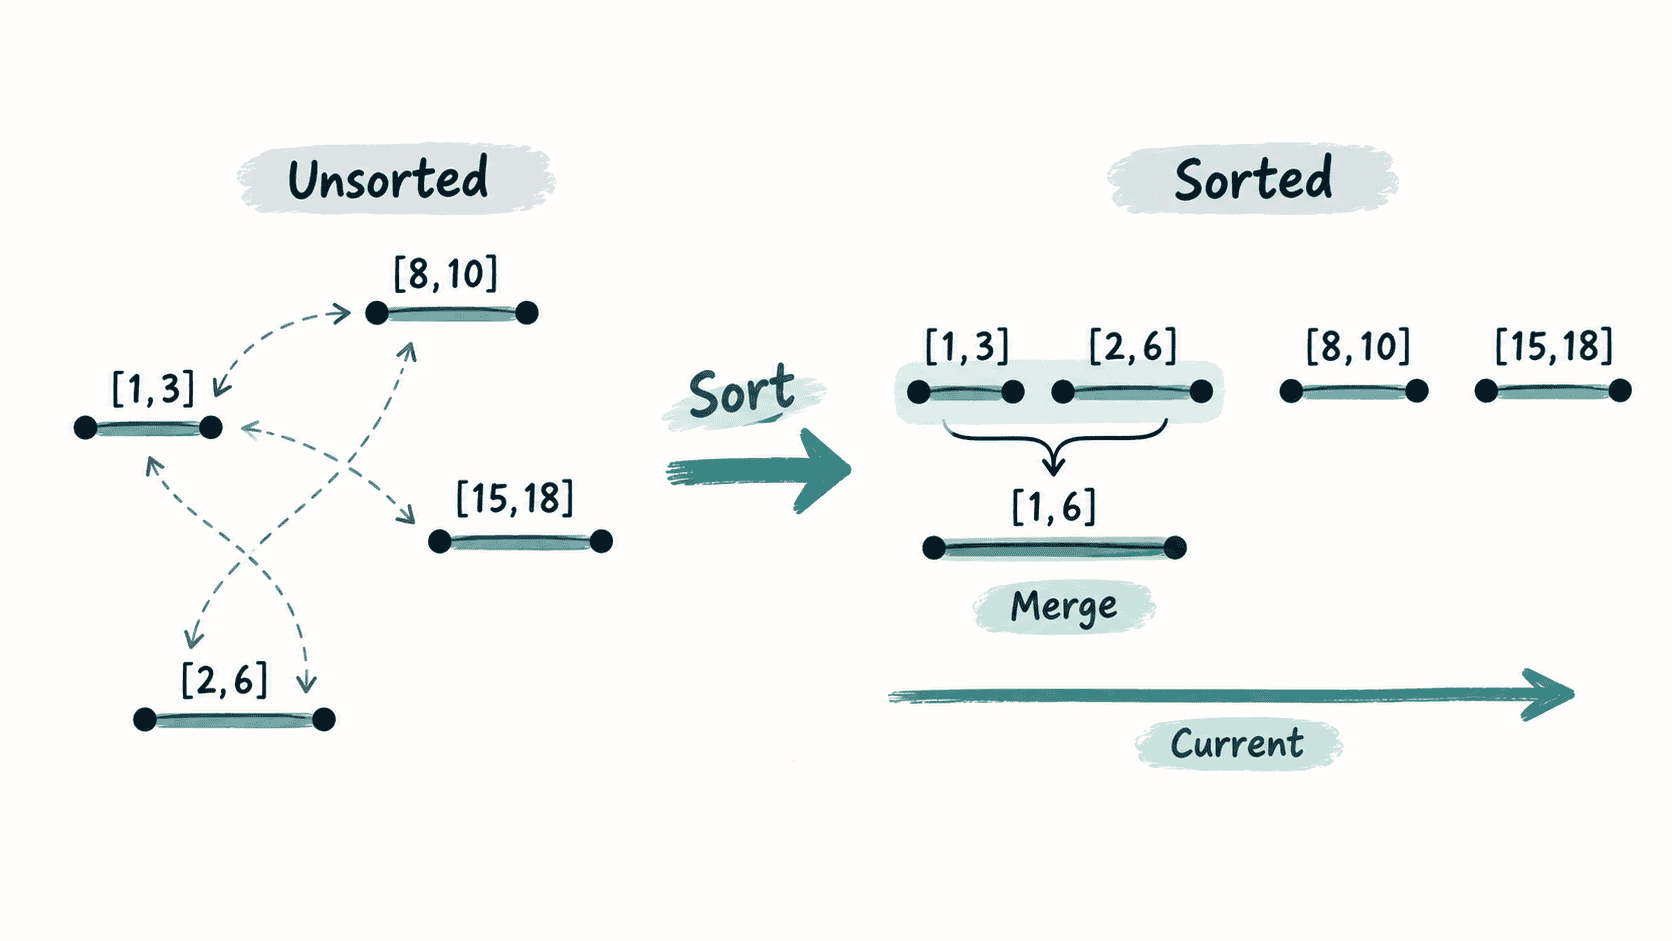
这里真正被排序建立的是一种单调性:后续区间只会从更靠右的位置开始。于是历史信息可以被压缩,不需要反复回头搜索。
标准扫描过程
合并闭区间时,可以把处理过程固定为三步:先按左端点排序;把第一个区间作为当前结果;之后逐个比较新区间的左端点与当前区间的右端点。
当 start <= current_end 时,两者存在重叠或接触,应把当前右端点更新为两者右端点的较大值。否则说明新区间已经完全位于当前区间右侧,可以把它作为新的结果区间。
这种写法的重要性质是:扫描到第 i 个区间时,结果列表中除最后一个区间外,其余区间都已经最终确定,不会再被后续区间改变。
用代码合并重叠区间
下面的程序合并一组闭区间。输入故意保持无序,用来验证排序步骤确实承担了统一关系的作用。
def merge_intervals(intervals):
    if not intervals:
        return []

    # 排序后,后续区间的左端点只会向右移动。
    intervals = sorted(intervals, key=lambda item: item[0])
    merged = [intervals[0][:]]

    for start, end in intervals[1:]:
        current_end = merged[-1][1]
        if start <= current_end:
            # 闭区间发生重叠时,只需扩展当前结果的右端点。
            merged[-1][1] = max(current_end, end)
        else:
            merged.append([start, end])

    return merged


if __name__ == "__main__":
    data = [[1, 3], [8, 10], [2, 6], [15, 18]]
    print(merge_intervals(data))
预期输出
[[1, 6], [8, 10], [15, 18]]排序耗时为 O(n log n),之后扫描一次为 O(n),所以总时间复杂度是 O(n log n)。除结果数组和排序本身的额外空间外,扫描阶段只维护常数个状态。
从合并迁移到其他区间题
“先排序,再只看当前关系”并不只用于合并区间。很多区间题只是维护状态不同。
判断会议是否冲突时,排序后检查相邻区间是否重叠即可;统计最少删除多少区间才能互不重叠时,通常按右端点排序并保留更早结束的区间;处理覆盖关系时,也可以在排序后维护目前见过的最远右端点。
关键不是死记“区间题一定按左端点排序”,而是先问:排序哪个端点,能让后续决策产生单调性? 合并问题关注新区间能否接到当前结果后面,因此按左端点排序最自然;贪心选择最多不重叠区间时,按右端点排序往往更合适。
边界条件决定比较符号
区间端点是否包含,会直接改变“接触算不算重叠”。对闭区间 [a, b] 和 [b, c],端点 b 同时属于两者,因此通常使用 start <= current_end 判断重叠。
若题目使用半开区间 [a, b),那么 [1, 3) 与 [3, 5) 没有公共元素,此时通常改为 start < current_end。此外还要检查空输入、单个区间、完全包含以及多个区间连续扩张等情况。
区间题看到“重叠、合并、覆盖、冲突”时,可以优先尝试先排序,把原本任意位置之间的关系变成从左到右的局部判断;一旦这种单调性成立,后续代码往往就只剩一次线性扫描。