
数据结构与算法 / 系统课时
用递归返回值处理二叉树问题
用递归返回值处理二叉树问题
二叉树递归最容易写乱的地方,是把“父节点传给当前节点的信息”和“当前子树返回给父节点的结果”混在一起。把这两个方向分开后,很多深度、路径、统计和最优值问题都会变成稳定的递归接口设计。
学习目标
- 区分向下传递的路径状态与向上返回的子树结果
- 能为二叉树递归设计清晰的参数和返回值
- 能判断答案应由返回值直接得到,还是需要额外汇总
先决定信息往哪个方向流
设计递归函数前,不要先写 dfs,先回答两个问题:当前节点需要从父节点知道什么,以及父节点需要从当前子树得到什么。
向下传递的信息通常与“从根到当前节点的路径”有关,例如当前深度、路径和、剩余目标值、路径上的最大值。这类状态放在递归参数里,因为它由父节点计算后交给子节点。
向上返回的信息通常描述“以当前节点为根的整棵子树”,例如子树高度、节点数、是否平衡、子树最大值。这类结果放在 return 中,因为父节点要等左右子树都算完后再组合。
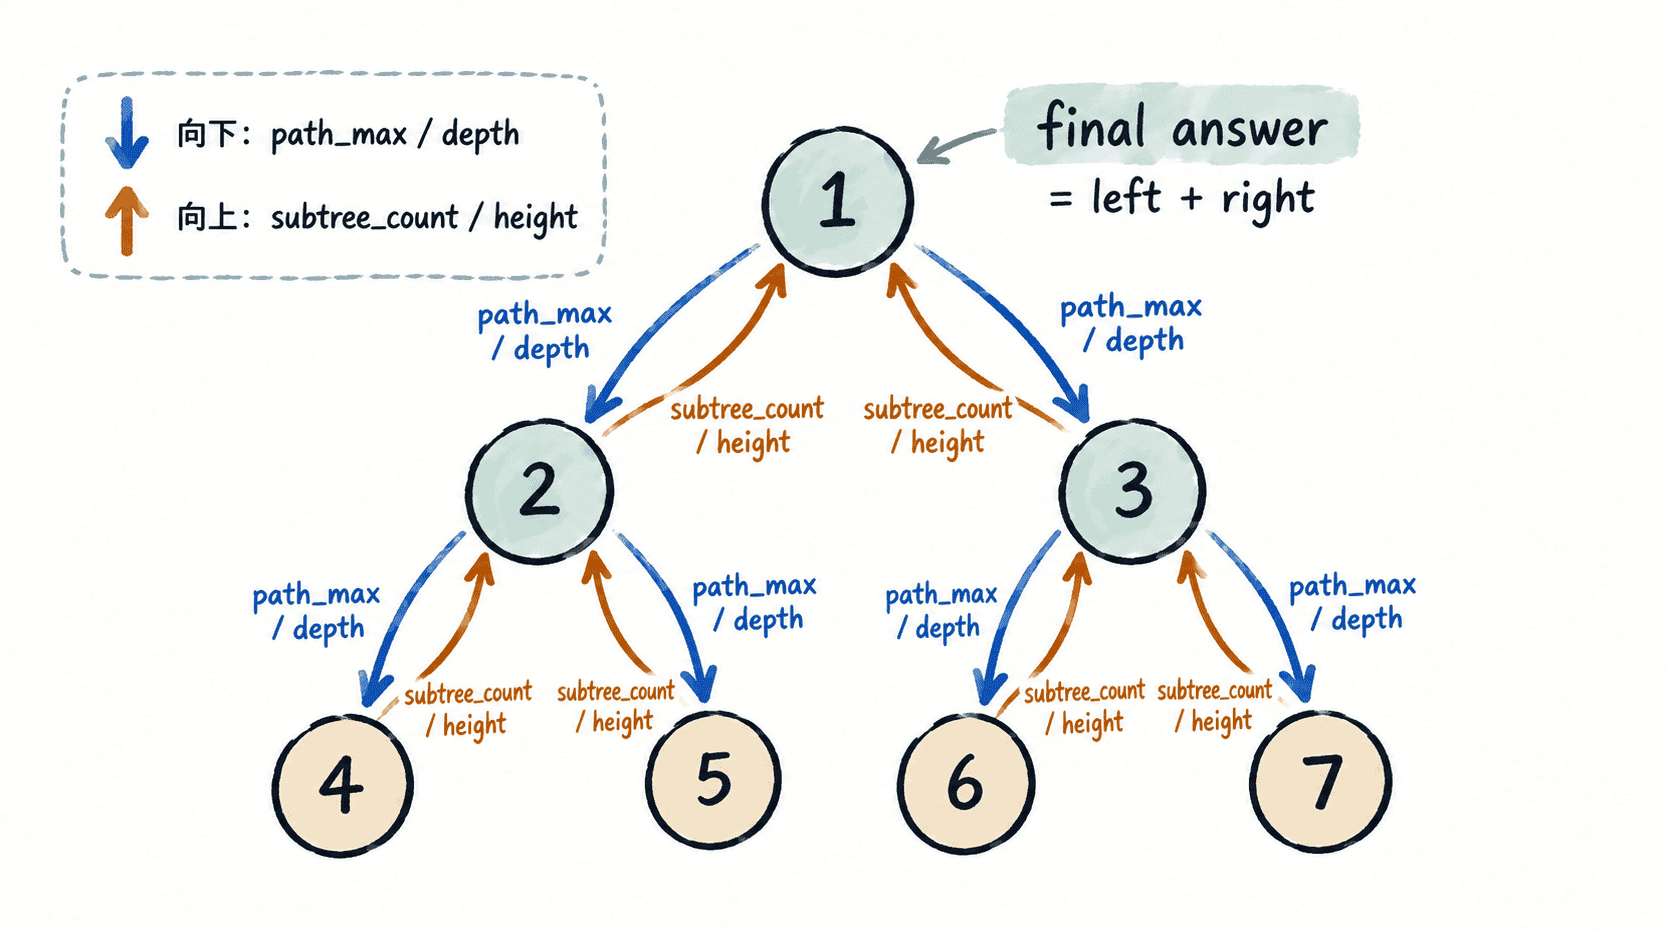
用一个递归同时处理上下行信息
以“好节点”为例:若从根到当前节点的路径上,没有任何节点值大于当前节点,则当前节点是好节点。为了判断当前节点,需要知道路径最大值,因此 path_max 必须向下传递;而父节点只关心当前子树一共有多少个好节点,因此递归函数返回计数。
递归接口可以直接写成:dfs(node, path_max) -> 当前子树中的好节点数量。当前节点只做三件事:判断自己是否满足条件、更新传给孩子的路径最大值、把左右子树返回的数量相加。
完整实现并验证
下面的树对应层序数据 3, 1, 4, 3, null, 1, 5。其中根节点 3、左子树中的 3、右子节点 4 和节点 5 都是好节点,因此答案为 4。
class TreeNode:
    def __init__(self, val, left=None, right=None):
        self.val = val
        self.left = left
        self.right = right


def count_good_nodes(root):
    if root is None:
        return 0

    def dfs(node, path_max):
        if node is None:
            return 0

        # path_max 来自父节点,描述根到当前节点之前的路径状态。
        is_good = 1 if node.val >= path_max else 0
        next_max = max(path_max, node.val)

        # 返回值只描述当前子树,供父节点继续向上汇总。
        left_count = dfs(node.left, next_max)
        right_count = dfs(node.right, next_max)
        return is_good + left_count + right_count

    return dfs(root, root.val)


if __name__ == "__main__":
    root = TreeNode(
        3,
        TreeNode(1, TreeNode(3)),
        TreeNode(4, TreeNode(1), TreeNode(5)),
    )
    print(count_good_nodes(root))
预期输出
4这个实现没有共享可变状态,递归函数的输入和输出都很明确:参数 path_max 只向下传,返回的整数只向上传,因此每一层都可以独立检查。
用返回值组合父节点答案
很多树题甚至不需要向下参数。例如最大深度只需要左右子树各自返回高度,然后父节点返回 1 + max(left, right);判断平衡树则可以让子树返回高度,并用特殊值表示“不平衡”。
另一类题的最终答案不能只靠某一个子树返回值表示。例如二叉树直径常让递归返回“当前节点向下的最大高度”,同时用额外变量记录 left_height + right_height 的最大值。这里要分清两个职责:返回值服务父节点继续递归,额外汇总量服务最终答案。
用三个问题固定递归设计
遇到新的二叉树题,可以按下面顺序检查:
- 当前节点做判断时,是否依赖根到这里的历史信息?如果依赖,把它设计成参数向下传。
- 父节点组合答案时,需要从当前子树获得什么最小信息?把它设计成返回值。
- 最终答案是否等同于根节点返回值?如果不是,再增加一个明确的汇总位置,而不是把多个含义塞进同一个返回值。
只要参数、返回值和最终答案各自承担单一职责,递归终止条件通常也会自然清晰:空节点返回对应的“空子树结果”,非空节点先递归左右孩子,再组合并返回。