
数据结构与算法 / 系统课时
用层序遍历处理树的分层信息
用层序遍历处理树的分层信息
当题目要求“按层”观察二叉树时,关键不是记住 BFS 模板,而是明确每一层的边界。做法是在处理一层前先记录队列长度,用这段固定数量的节点计算本层答案,再让它们的子节点进入下一层。
学习目标
- 用队列长度准确划分二叉树的层级边界
- 把同一套层序框架改造成层平均值、右视图和最短深度
- 避免把下一层节点误算进当前层
为什么队列能表示一层
层序遍历使用先进先出的队列。开始处理某一层时,队列里恰好保存这一层尚未访问的节点;访问这些节点的过程中,它们的左右孩子会继续入队,因此队列内容会逐渐混入下一层。
所以不能写成“队列不空就一直处理,期间顺便统计当前层”。正确做法是先保存 levelSize = queue.size(),随后只弹出这 levelSize 个节点。即使队列长度继续增长,本轮循环的边界也不会改变。
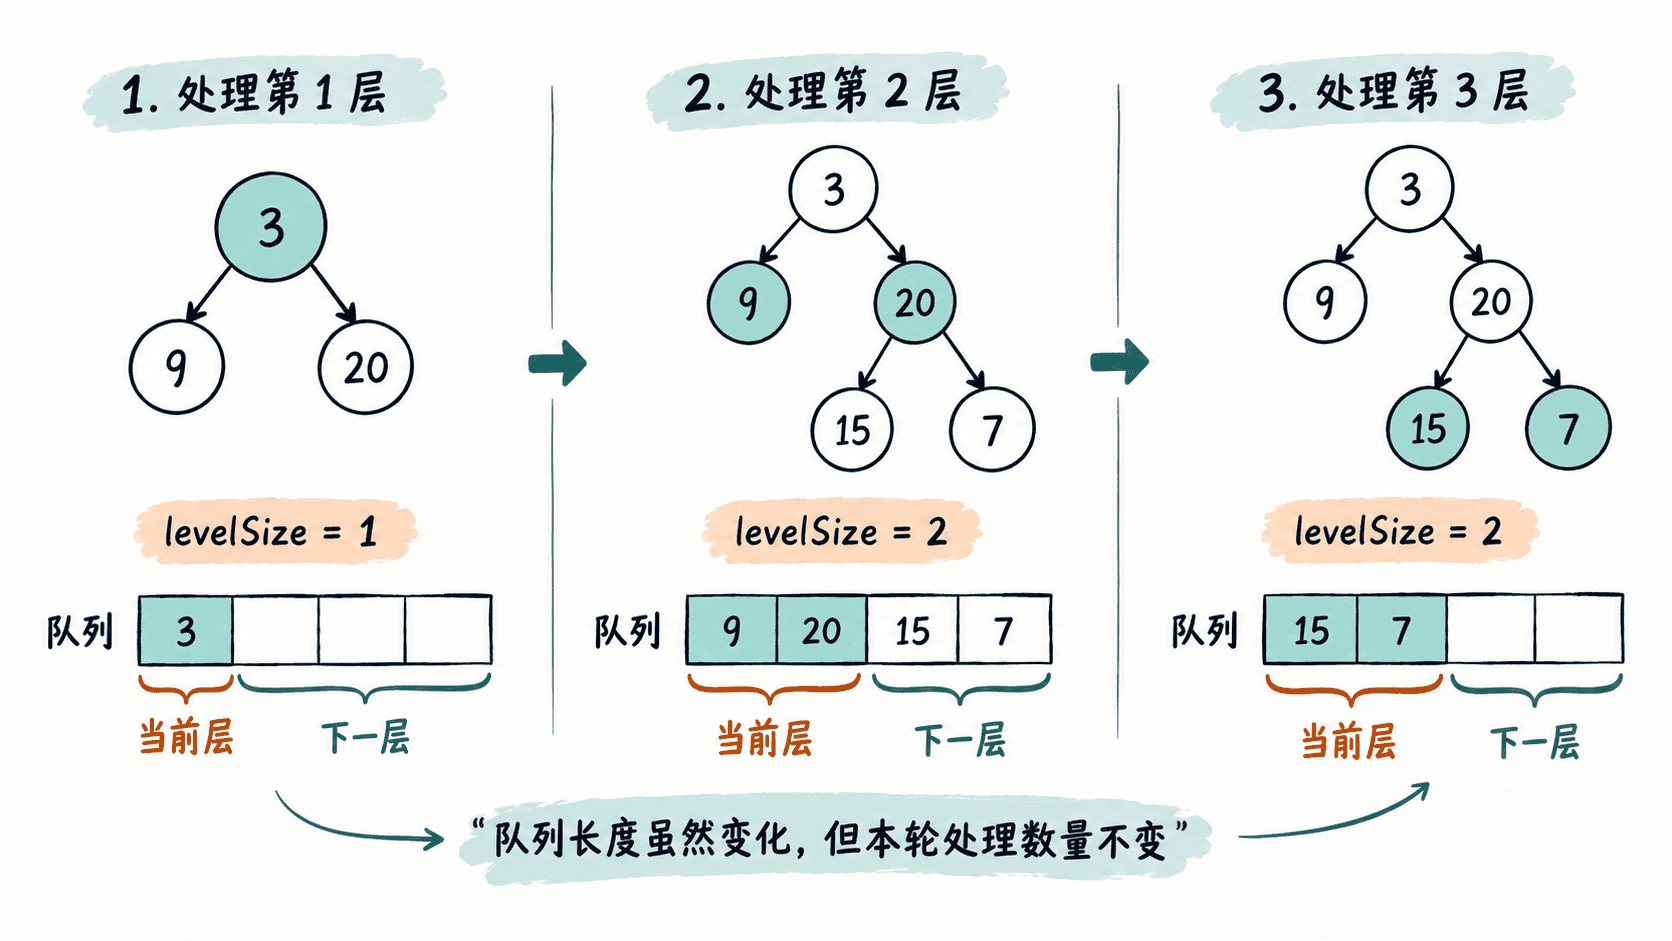
主示例:计算每层平均值
下面用完整 Java 程序计算二叉树每层节点值的平均数。核心步骤只有三个:记录当前层大小、累计这一层的值、把孩子加入队列。
import java.util.ArrayDeque;
import java.util.ArrayList;
import java.util.List;
import java.util.Queue;

public class LevelAverageDemo {
    static class TreeNode {
        int val;
        TreeNode left;
        TreeNode right;

        TreeNode(int val) {
            this.val = val;
        }
    }

    static List<Double> averageOfLevels(TreeNode root) {
        List<Double> result = new ArrayList<>();
        if (root == null) {
            return result;
        }

        Queue<TreeNode> queue = new ArrayDeque<>();
        queue.offer(root);

        while (!queue.isEmpty()) {
            int levelSize = queue.size();
            long sum = 0;

            // 只处理本轮开始时已经在队列中的节点。
            for (int i = 0; i < levelSize; i++) {
                TreeNode node = queue.poll();
                sum += node.val;

                if (node.left != null) {
                    queue.offer(node.left);
                }
                if (node.right != null) {
                    queue.offer(node.right);
                }
            }

            result.add((double) sum / levelSize);
        }

        return result;
    }

    public static void main(String[] args) {
        TreeNode root = new TreeNode(3);
        root.left = new TreeNode(9);
        root.right = new TreeNode(20);
        root.right.left = new TreeNode(15);
        root.right.right = new TreeNode(7);

        System.out.println(averageOfLevels(root));
    }
}
预期输出:
[3.0, 14.5, 11.0]这里用 long 保存层和,避免节点值较大或一层节点较多时先发生整数溢出;真正做除法时再转成 double。
同一框架如何切换题型
层平均值需要看完整层,所以在这一层的循环中累计总和,并在循环结束后计算平均值。
二叉树右视图只关心每层最后一个节点。只要在 i == levelSize - 1 时记录当前节点,就能得到从右侧看到的序列;这里依赖的不是“先访问右子树”,而是“知道这一层在哪里结束”。
最短深度关心第一次遇到叶子节点的层数。BFS 按深度从小到大访问,因此只要在某层发现第一个左右孩子都为空的节点,就可以立即返回当前深度,不必继续遍历更深层。
这三类题表面问题不同,但真正复用的是“以层为批次处理节点”的结构。遇到题目出现“每层、某一层、最浅、右侧看到”等信号时,应先考虑能否用这一层的固定边界直接产出答案。
常见边界错误
最常见的错误是在 for 循环条件里直接写实时的 queue.size()。因为访问节点时会不断加入孩子,循环上界随之变化,当前层和下一层就会混在一起。
另一个错误是把“节点出队顺序”误当成“层边界”。BFS 确实保证浅层先于深层,但如果题目要求每层单独统计,仍然必须显式记录 levelSize,否则无法可靠知道一层何时结束。
层序遍历的判断要点可以压缩成一句话:进入一层时先冻结队列长度,再用这一批节点计算本层答案。