
数据结构与算法 / 系统课时
用最小反例快速定位错误
用最小反例快速定位错误
代码能通过大多数样例却卡在少数边界时,继续盯着完整输入往往效率很低。更有效的方法是把失败样例不断缩小,直到只剩触发错误所必需的元素,再从空集、单元素、重复值、极端值和顺序变化等方向验证边界。
学习目标
- 能把复杂失败样例缩减成容易人工推演的最小反例
- 能按空集、单元素、重复值、极端值和顺序变化系统补测试
- 能根据最小反例反推初始化、边界条件或状态转移中的错误位置
为什么最小反例比大样例更有用
假设一个长度为 100 的数组得到错误答案,真正触发问题的可能只有其中一个负数、两个相邻重复值,或某个元素的位置。大样例同时包含太多变量,很难判断是哪条逻辑失效。
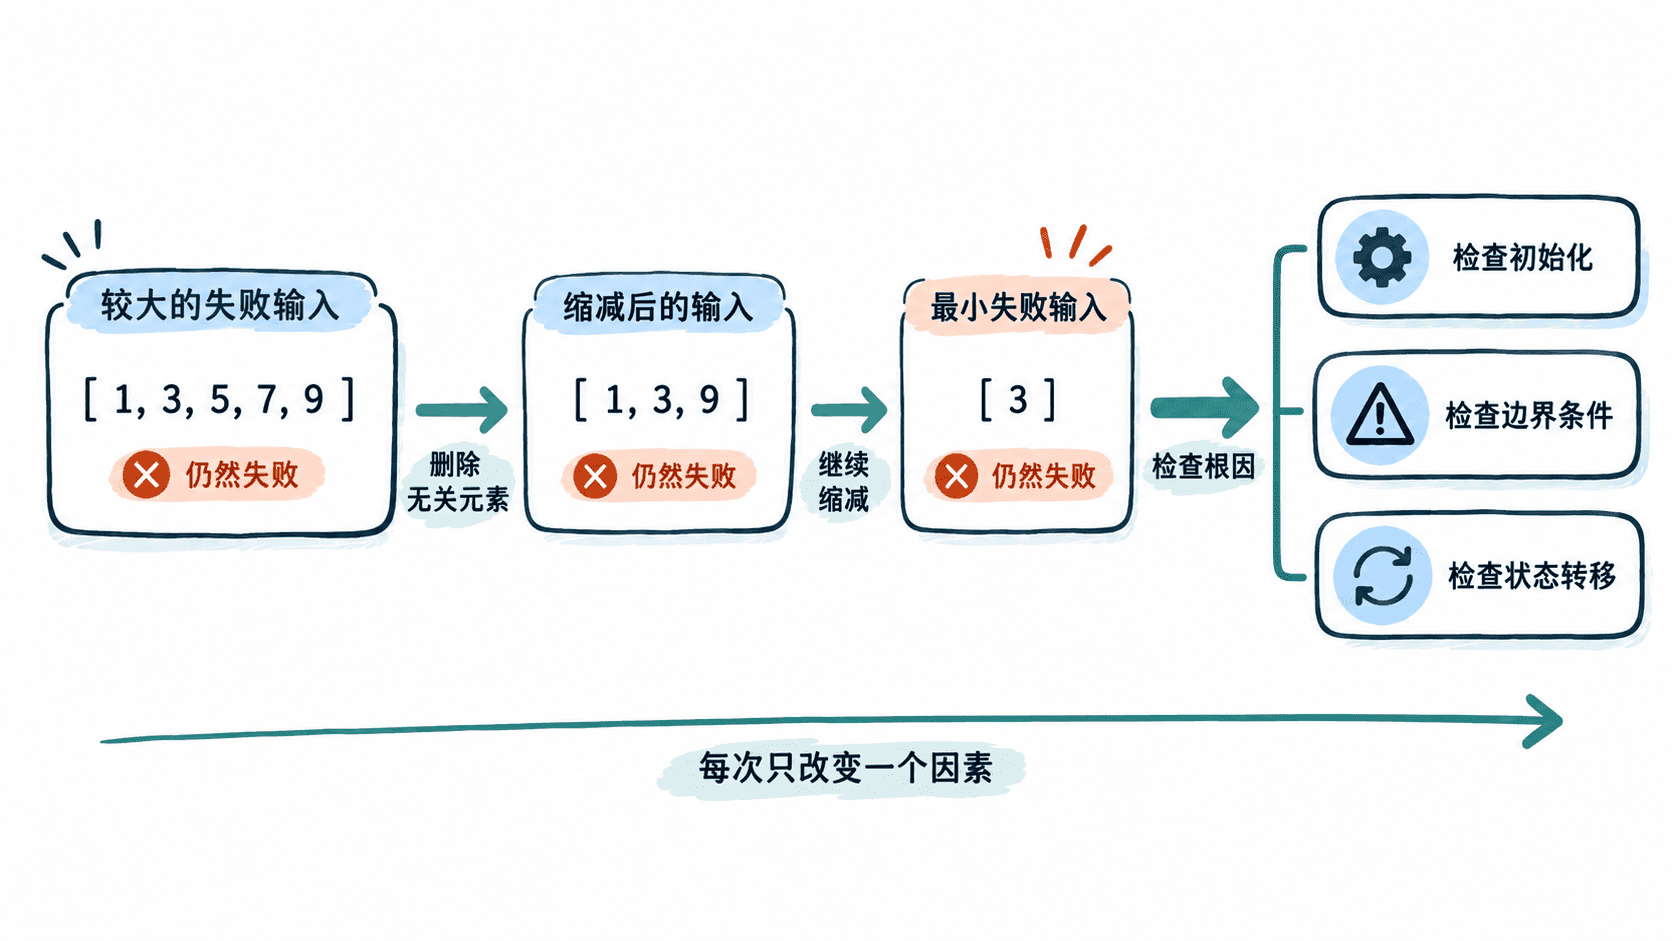
最小反例的目标不是寻找“更刁钻”的数据,而是删除与故障无关的部分。如果删除一个元素后仍然失败,就继续删;直到再删除任何关键元素都会让错误消失。此时输入与根因之间的关系通常已经足够直接。
用单元素反例暴露初始化错误
下面的最大子数组和实现看起来符合“负贡献就清零”的直觉,但它把答案也初始化为 0,因此无法处理全部为负数的输入。
def max_subarray_sum(nums):
    best = 0
    current = 0
    for x in nums:
        current = max(0, current + x)
        best = max(best, current)
    return best

cases = [
    ([5], 5),
    ([-1], -1),
    ([-2, -3], -2),
    ([2, -1, 2], 3),
]

for nums, expected in cases:
    actual = max_subarray_sum(nums)
    print(f"{nums}: actual={actual}, expected={expected}")
预期输出
[5]: actual=5, expected=5
[-1]: actual=0, expected=-1
[-2, -3]: actual=0, expected=-2
[2, -1, 2]: actual=3, expected=3
失败样例 [-2, -3] 还可以继续缩成 [-1]。只剩一个负数仍然错误,就说明问题与复杂的区间选择无关,而集中在初始值和“是否允许空子数组”这两个条件上。若题目要求子数组至少包含一个元素,答案就不能默认从 0 开始。
按五类边界主动造反例
拿到错误实现后,可以依次检查五类输入。空集用于检查循环是否执行、默认值是否合理,但前提是题目允许空输入;单元素最容易暴露初始化和下标边界问题;重复值常击穿错误的去重、哈希或双指针条件。
极端值不仅包括数值上限和下限,也包括全负、全正、长度最小或最大等结构极端;顺序变化则可以把同一批元素换成升序、降序或交错顺序,用来发现算法是否偷偷依赖了题目没有保证的排序条件。
从反例反推代码位置
最小反例确定后,再做一次手工执行。记录每一步真正影响答案的状态,只关注第一次偏离正确结果的位置:单元素立即错误,优先检查初始化;最后一个元素遗漏,优先检查循环上界;两个相等元素出错,优先检查严格与非严格比较;交换顺序后结果改变,则检查是否存在未声明的排序假设。
修复后不要只重新运行原失败样例。至少同时回归最小反例、一个正常样例和与它相邻的边界样例,确认修改没有把错误从一个分支移动到另一个分支。最小反例真正的价值,是把“答案不对”转换成一个可以逐行验证的具体条件。