
数据结构与算法 / 系统课时
用快速选择找到第K个元素
用快速选择找到第K个元素
当题目只要求第 K 大或第 K 小元素时,完整排序会做许多无关工作。快速选择借用快速排序的分区操作,每轮只保留可能包含目标下标的一侧,从而把“排好全部元素”改成“定位一个位置”。
学习目标
- 能把第 K 大或第 K 小转换成排序后的目标下标。
- 能使用分区结果判断继续搜索左侧、右侧还是直接返回。
- 能说明快速选择的平均复杂度、最坏情况与适用边界。
从排序问题改写成选择问题
假设数组长度为 n,按升序排列后,第 K 小元素的下标是 k - 1,第 K 大元素的下标是 n - k。快速选择不需要真的完成排序,只要让某个枢轴最终落到正确下标,并据此缩小搜索区间。
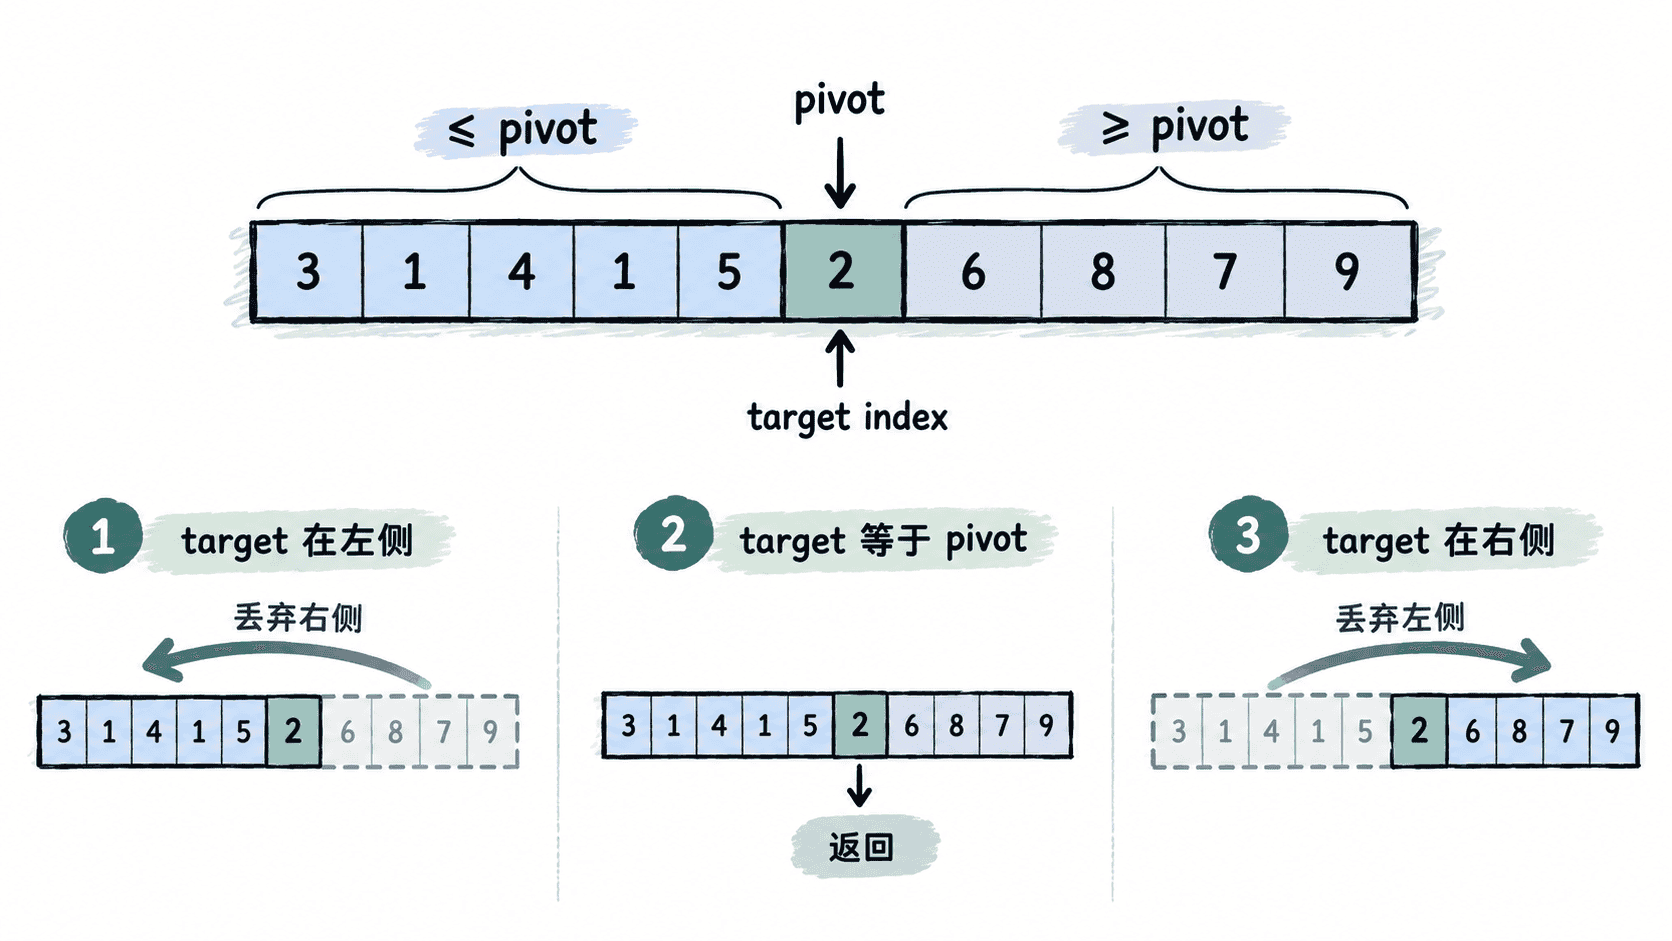
一次分区结束后,枢轴左边都不大于它,右边都不小于它。若枢轴下标正好等于目标下标,答案已经确定;若目标更小,只看左半区;若目标更大,只看右半区。
用随机枢轴避免固定坏分区
下面实现“数组中的第 K 大元素”。分区按升序组织,因此目标下标取 n - k。每轮随机选择枢轴,再把它交换到区间末尾完成 Lomuto 分区;主循环只收缩一侧,不再递归两边。
java
import java.util.Random;

public class QuickSelectDemo {
    private static final Random RANDOM = new Random();

    public static int findKthLargest(int[] nums, int k) {
        if (nums == null || k < 1 || k > nums.length) {
            throw new IllegalArgumentException("invalid k");
        }

        int target = nums.length - k;
        int left = 0;
        int right = nums.length - 1;

        while (left <= right) {
            int pivotIndex = left + RANDOM.nextInt(right - left + 1);
            swap(nums, pivotIndex, right);

            int finalPivot = partition(nums, left, right);

            if (finalPivot == target) {
                return nums[finalPivot];
            }
            if (finalPivot < target) {
                left = finalPivot + 1;
            } else {
                right = finalPivot - 1;
            }
        }

        throw new IllegalStateException("target not found");
    }

    private static int partition(int[] nums, int left, int right) {
        int pivot = nums[right];
        int store = left;

        // 把不大于 pivot 的元素集中到左侧,最终确定 pivot 的排序位置。
        for (int i = left; i < right; i++) {
            if (nums[i] <= pivot) {
                swap(nums, store, i);
                store++;
            }
        }

        swap(nums, store, right);
        return store;
    }

    private static void swap(int[] nums, int i, int j) {
        int tmp = nums[i];
        nums[i] = nums[j];
        nums[j] = tmp;
    }

    public static void main(String[] args) {
        int[] nums = {3, 2, 1, 5, 6, 4};
        System.out.println(findKthLargest(nums, 2));
    }
}
预期输出
text
5随机枢轴只影响分区过程,不影响最终答案;因此示例每次都应输出 5。
跟着一次分区做判断
设目标下标为 target。一次 partition 返回 p 后,只做三选一判断:p == target 直接返回;p < target 把左边界移动到 p + 1;p > target 把右边界移动到 p - 1。
关键点不是“把左右两边继续排好”,而是利用 p 已经处在最终排序位置这一事实排除一整侧。与快速排序相比,这正是快速选择能少做大量工作的原因。
复杂度与适用边界
随机枢轴通常能让问题规模快速缩小,期望时间复杂度为 ;极端情况下若连续得到很差的枢轴,最坏会退化到 。原地分区只使用常数级额外空间,但会修改输入数组。
当题目只需要一个或少量顺序统计量时,快速选择通常比完整排序更合适。若还需要整体有序结果,直接排序更简单;若数据持续到达并频繁查询第 K 大,固定大小堆往往比反复快速选择更适合。
按自己的节奏,确认真正理解。