
数据结构与算法 / 系统课时
用分治合并局部有序结果
用分治合并局部有序结果
有些数组问题既要求排序,又要求统计跨区间关系。直接枚举所有元素对通常是平方复杂度;分治可以先递归处理左右子区间,再利用“左右两边已经有序”这一条件,在一次线性合并中完成跨区间统计。
学习目标
- 识别“拆成子区间、递归求解、合并结果”的分治结构
- 理解有序子区间为什么能把跨区间统计降为线性扫描
- 用归并过程实现逆序对计数并分析复杂度
把答案拆成三部分
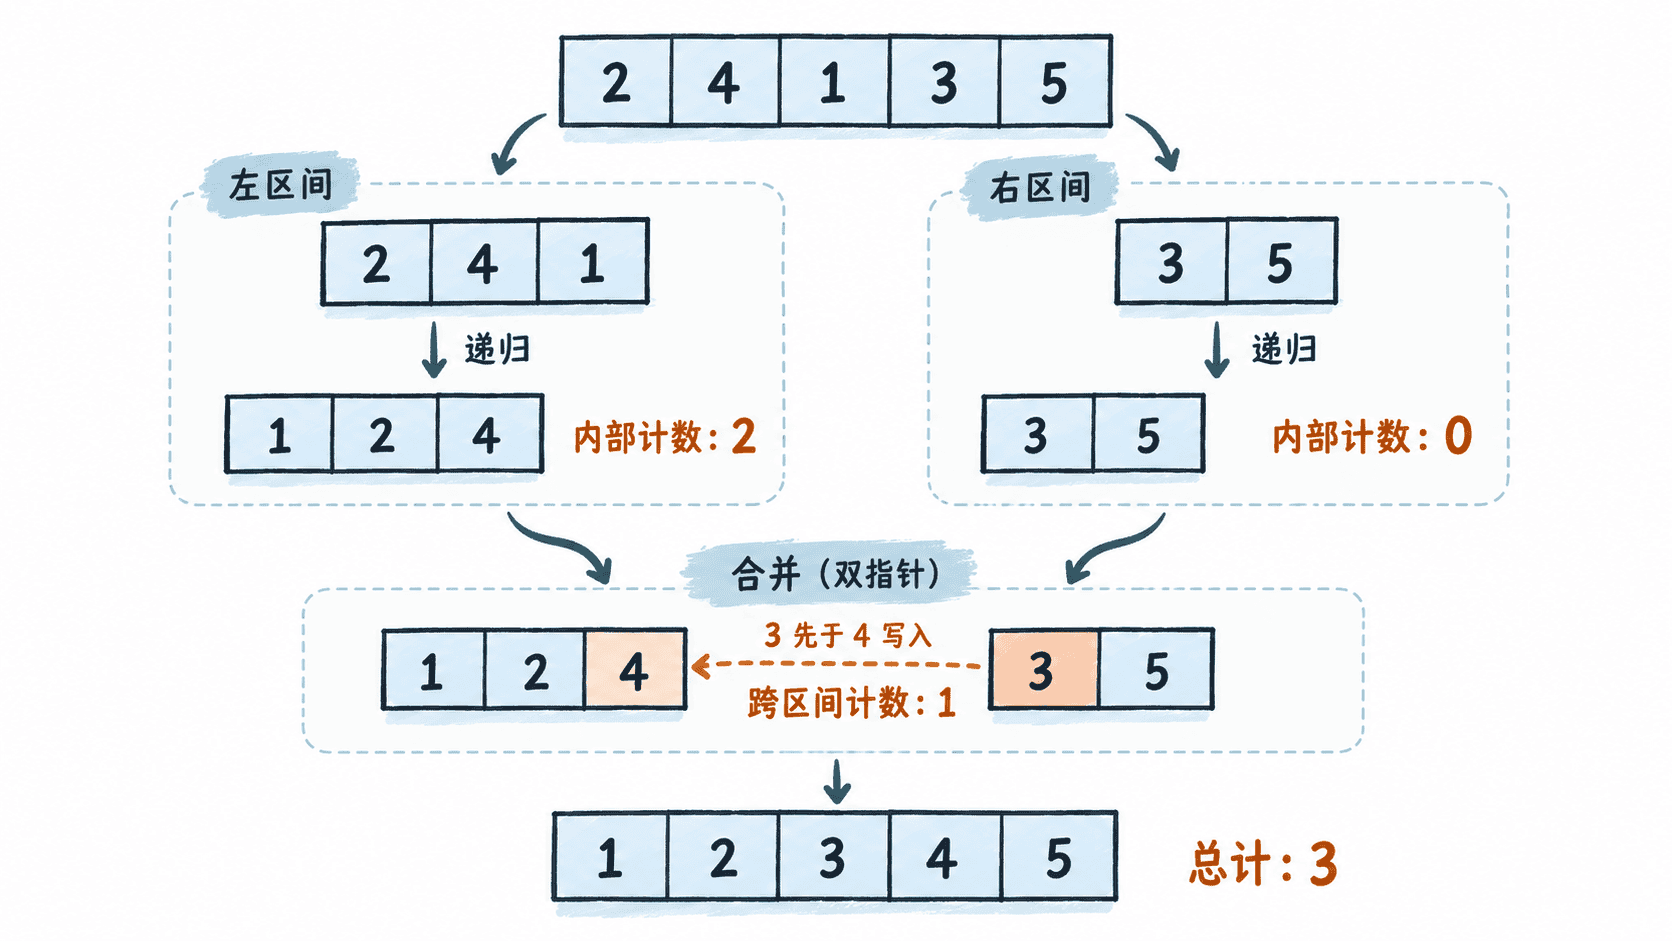
以逆序对为例:若 i < j 且 nums[i] > nums[j],则 (i, j) 是一个逆序对。对区间 [left, right] 从中点拆开后,全部逆序对只可能属于三类:左半区内部、右半区内部、一个元素在左边而另一个在右边。
前两类可以交给递归处理。真正需要在当前层解决的只有第三类,也就是跨越中点的逆序对。关键条件是:递归返回时,让左右子区间同时保持有序。
在合并时批量计数
设左右两段已经分别有序,指针 i 指向左段当前元素,j 指向右段当前元素。
当 nums[i] <= nums[j] 时,左侧当前元素不会与右侧当前元素形成逆序对,可以正常写入结果。反过来,如果 nums[i] > nums[j],因为左半区已经有序,所以从 i 到 mid 的所有元素都大于 nums[j],可以一次增加 mid - i + 1 个逆序对,而不是逐个比较。
这正是分治加速的核心:先用递归制造局部有序性,再在合并阶段批量推导关系数量。
完整实现
下面的程序同时统计逆序对并把原数组排好序。临时数组只创建一次,在所有递归层复用,避免每次合并都重新申请大数组。
import java.util.Arrays;

public class Main {
    private static long sortAndCount(int[] nums, int[] temp, int left, int right) {
        if (left >= right) {
            return 0;
        }

        int mid = left + (right - left) / 2;
        long count = sortAndCount(nums, temp, left, mid)
                + sortAndCount(nums, temp, mid + 1, right);

        int i = left;
        int j = mid + 1;
        int k = left;

        // 两个子区间都已排序,因此可以一次统计一批跨区间逆序对。
        while (i <= mid && j <= right) {
            if (nums[i] <= nums[j]) {
                temp[k++] = nums[i++];
            } else {
                count += mid - i + 1L;
                temp[k++] = nums[j++];
            }
        }

        while (i <= mid) {
            temp[k++] = nums[i++];
        }
        while (j <= right) {
            temp[k++] = nums[j++];
        }

        for (int p = left; p <= right; p++) {
            nums[p] = temp[p];
        }
        return count;
    }

    public static void main(String[] args) {
        int[] nums = {2, 4, 1, 3, 5};
        int[] temp = new int[nums.length];
        long count = sortAndCount(nums, temp, 0, nums.length - 1);

        System.out.println(count);
        System.out.println(Arrays.toString(nums));
    }
}
预期输出
3
[1, 2, 3, 4, 5]
三个逆序对分别是 (2, 1)、(4, 1) 和 (4, 3)。最终数组有序并不是额外目标,而是下一层合并能够快速统计跨区间关系的前提。
复杂度与常见边界
递归树共有 O(log n) 层,每一层的所有合并操作总共扫描 O(n) 个元素,因此时间复杂度为 O(n log n)。临时数组需要 O(n) 空间,递归调用栈需要 O(log n) 空间。
合并条件应写成 nums[i] <= nums[j]。相等元素不属于逆序对,如果误写成严格小于,就会把相等值错误计入答案。计数变量还应优先使用 long:当数组很长且接近降序时,逆序对数量可能远大于 int 能安全表示的范围。
这种套路不只用于逆序对。只要目标关系能够被拆成“左区间答案 + 右区间答案 + 跨区间答案”,并且局部有序性可以帮助快速计算第三部分,就值得考虑分治归并,而不是直接枚举所有元素对。