
数据结构与算法 / 系统课时
把记忆化改写成自底向上表格
把记忆化改写成自底向上表格
记忆化搜索已经写出正确递归关系后,下一步不是“重新想一套 DP”,而是把同一组状态按依赖顺序主动计算。本节用爬楼梯演示如何从递归状态、缓存和返回值,机械地改写成自底向上的表格实现。
学习目标
- 从记忆化搜索中提取状态、转移和边界条件
- 根据状态依赖方向确定正确的填表顺序
- 把递归调用改写成等价的迭代代码并验证结果
从记忆化里提取四个要素
假设状态 f(i) 表示到达第 i 级台阶的方法数。记忆化写法会在需要 f(i) 时递归计算 f(i - 1) 和 f(i - 2),并把结果缓存起来。
改成表格时,四个要素基本不变:状态含义仍是“到达第 i 级的方法数”;递归式变成赋值式;递归出口变成数组初始化;最终返回的状态仍然是 f(n) 对应的表格项。
最关键的变化只有一个:递归会自动先计算依赖项,而迭代必须由你显式安排计算顺序。
用依赖方向决定填表顺序
如果 dp[i] 依赖 dp[i - 1] 和 dp[i - 2],那么计算 dp[i] 之前,这两个更小下标必须已经完成。因此表格应从小到大填,而不是凭习惯选择正序或倒序。
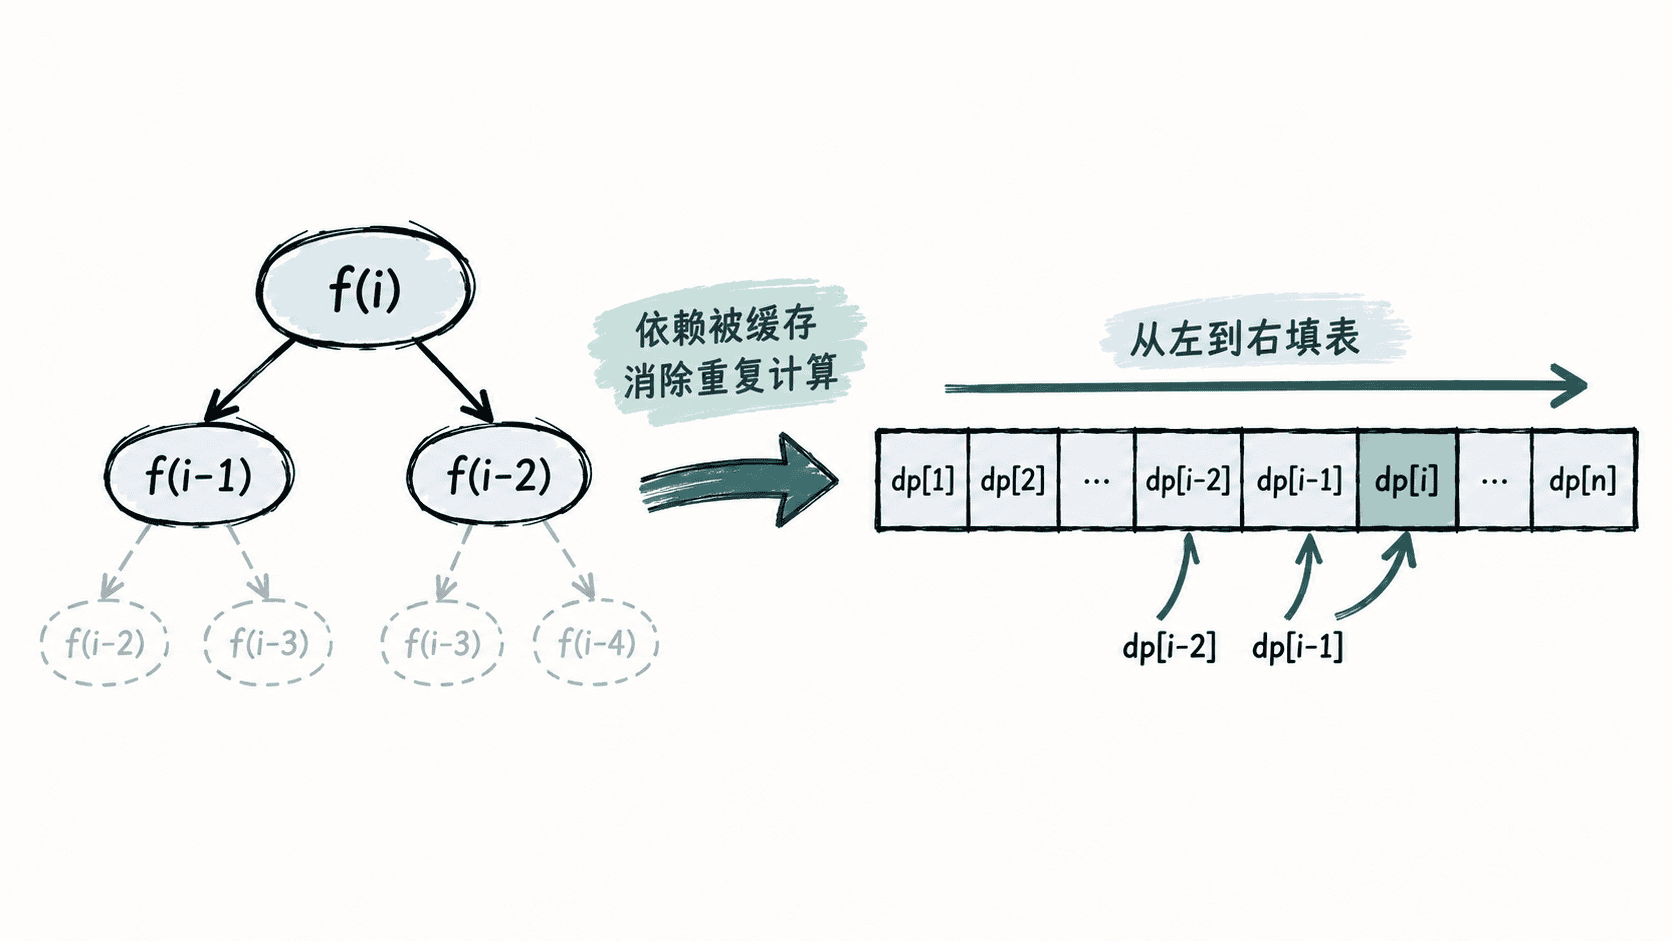
更一般地说,填表顺序就是状态依赖图的一种拓扑顺序:某个状态依赖谁,谁就必须先算。二维 DP 也一样,只是顺序可能表现为按行、按列、按区间长度或按其他维度递增。
完成等价的迭代实现
下面把爬楼梯的记忆化关系直接翻译成表格。dp[1] 和 dp[2] 对应递归出口,循环负责按依赖顺序计算后续状态。
python
def climb_stairs(n: int) -> int:
    if n <= 2:
        return n

    dp = [0] * (n + 1)
    dp[1] = 1
    dp[2] = 2

    # dp[i] 只读取已经完成的更小下标状态。
    for i in range(3, n + 1):
        dp[i] = dp[i - 1] + dp[i - 2]

    return dp[n]


if __name__ == "__main__":
    print(climb_stairs(5))
预期输出
text
8这个版本的时间复杂度是 ,空间复杂度也是 。与记忆化搜索相比,它不再依赖递归栈,状态计算次数也更容易直接从循环范围判断。
改写时按固定顺序检查
面对已经正确的记忆化代码,可以按以下顺序改写:
- 把“递归函数参数”确定为 DP 状态坐标。
- 把“递归出口”改成表格初始化。
- 把“递归返回表达式”改成状态转移赋值。
- 根据依赖关系确定循环方向和边界。
- 返回与原递归目标相同的最终状态。
如果某个状态在迭代时读到了“尚未计算”的位置,问题通常不在转移方程,而在填表顺序。先画清依赖,再决定循环,比背“二维 DP 一定从左上往右下”更可靠。
按自己的节奏,确认真正理解。