
数据结构与算法 / 系统课时
建立错题标签与复习节奏
建立错题标签与复习节奏
错题本如果只保存题目链接,很快会变成不会再打开的收藏夹。有效记录应当回答四个问题:错在什么地方、属于什么题型、真正的关键转折点是什么,以及什么时候再次独立重做,从而把一次错误转化成可重复训练的模式。
学习目标
- 能用错因、题型和关键转折点给错题建立可检索标签
- 能记录足够复现思路的信息,而不是抄完整题解
- 能安排由近到远的重做节奏,并依据掌握程度调整间隔
记录真正影响迁移的信息
一道错题最值得留下的不是完整代码,而是下次遇到相似题时能够触发正确思路的信息。建议每题只保存题目、题型、错因、关键转折点和下一次重做日期,必要时再补一句复杂度或边界提醒。
| 字段 | 应记录的内容 | 示例 |
|---|---|---|
| 题型 | 能指导选算法的模式 | 滑动窗口、单调栈、区间 DP |
| 错因 | 本次为什么没有独立做对 | 漏边界、状态定义错、复杂度超限 |
| 关键转折点 | 从卡住到可解的核心判断 | 窗口左端只需单调右移 |
| 重做日期 | 下一次不看答案重做的时间 | 第 3 天 |
“不会做”不是一个有效错因,因为它不能指导下一次训练。更好的描述是“看到连续子数组却没有想到维护窗口”“二分时没有明确左右边界语义”或“状态定义包含的信息不足以完成转移”。
标签不要按题号堆积
标签应当服务于检索。同一道题可以同时拥有一个主题型和一两个错因标签,例如“二分答案 + 边界条件”或“回溯 + 剪枝遗漏”。当同一个错因反复出现时,就可以跨题目集中训练,而不是机械地从头刷一遍题库。
题目难度通常不适合作为主要复习标签。两道同为中等难度的题,失败原因可能完全不同;反过来,一道简单题暴露出的循环不变量问题,也可能比某道困难题更值得优先复习。
用间隔重做代替连续重刷
刚看完题解立即重写,更多是在检验短期记忆。可以先采用“当天整理、隔天回忆、数天后独立重做、再过一到两周抽查”的递增间隔,并根据实际表现缩短或延长,而不是把固定天数当成必须遵守的公式。
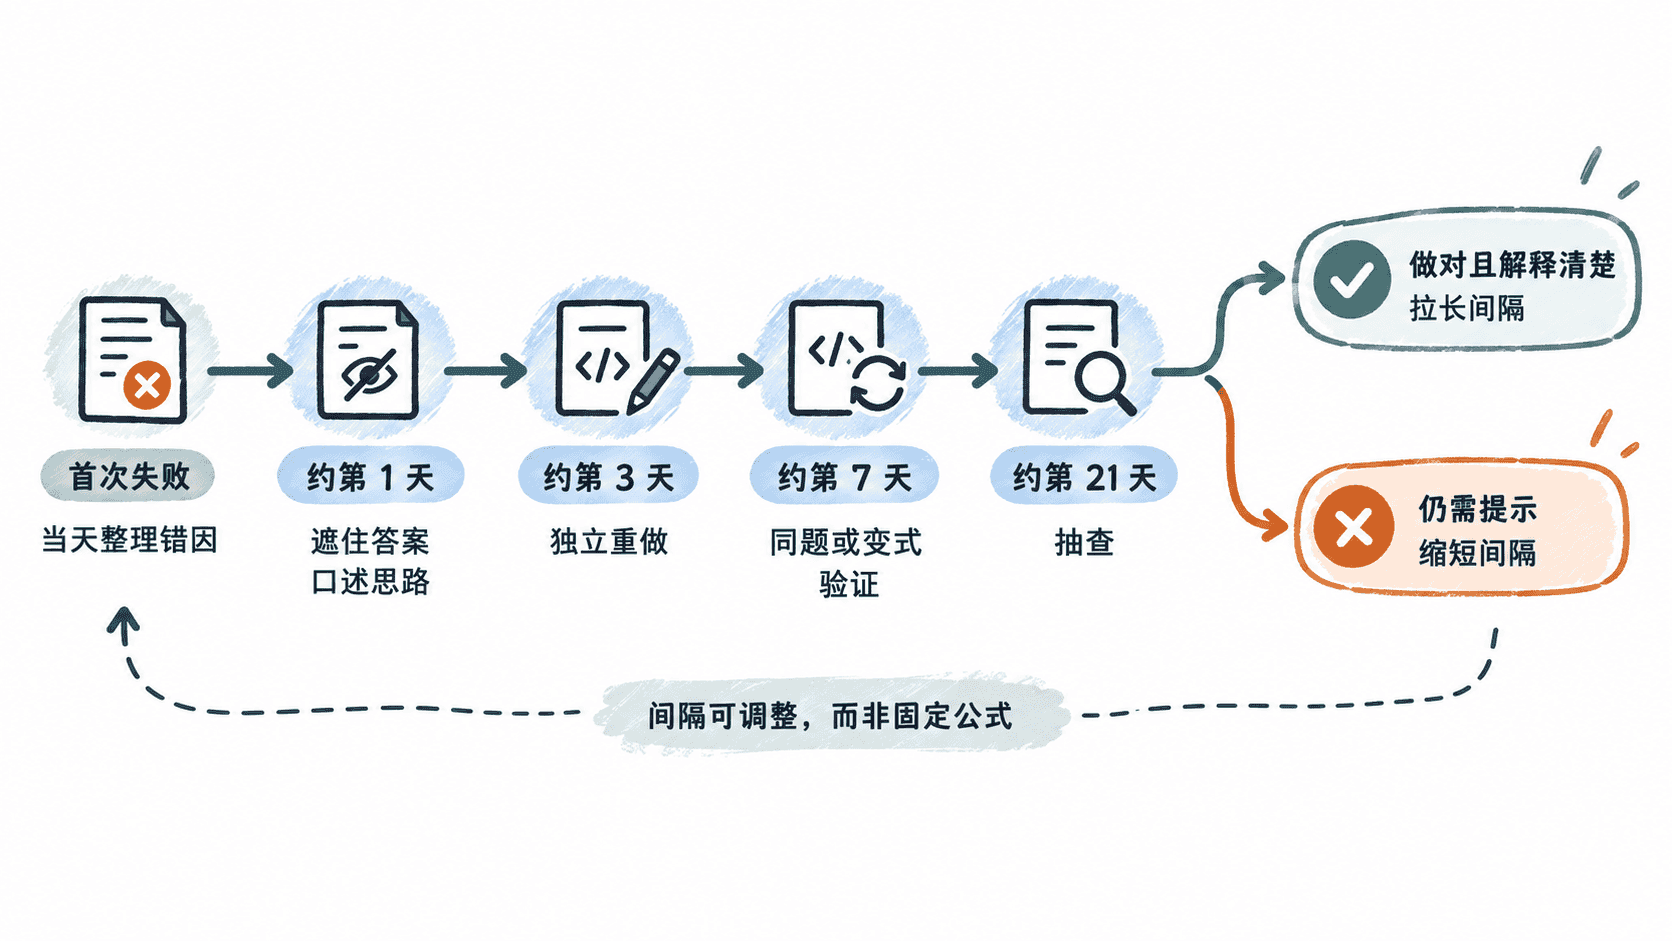
第一次复习可以只遮住题解,口述状态、数据结构或不变量;后续复习必须真正独立实现并通过样例。若能够不看提示写出代码,还应再解释为什么算法正确、复杂度是多少以及最容易错在哪个边界,避免只记住代码形状。
用重做结果决定下一次日期
每次复习后只需要做简单判定:完全独立完成并能解释关键点,就把下一次间隔拉长;思路正确但实现仍出现同类错误,就维持较短间隔;仍需要看提示,则重新记录这次暴露出的具体错因,并尽快再做一次。
最终应形成按“模式”而非按“题号”组织的错题库:看到某个标签,就能迅速回忆自己曾经在哪类判断上失误、正确突破口是什么,并用下一道相似题验证这种经验是否已经能够迁移。