
数据结构与算法 / 系统课时
建立从审题到复盘的六步流程
建立从审题到复盘的六步流程
刷题效率低,常见原因不是题做得少,而是每次都从零开始。把一次解题固定成读题、抽象、选型、实现、验证、复盘六步,可以让“想到什么写什么”变成可检查、可复用的训练闭环。
学习目标
- 能按六步流程推进一道题,并知道每一步应产出什么。
- 能在写代码前完成问题抽象与算法选型,减少无效实现。
- 能把错误归因沉淀成下一次可直接调用的判断规则。
六步流程要留下可检查的产物
六步不是机械打卡,而是把一次解题中的关键决策显式化。每一步都要留下一个可以检查的结果,否则很容易出现“代码写了很多,却说不清为什么这样做”的情况。
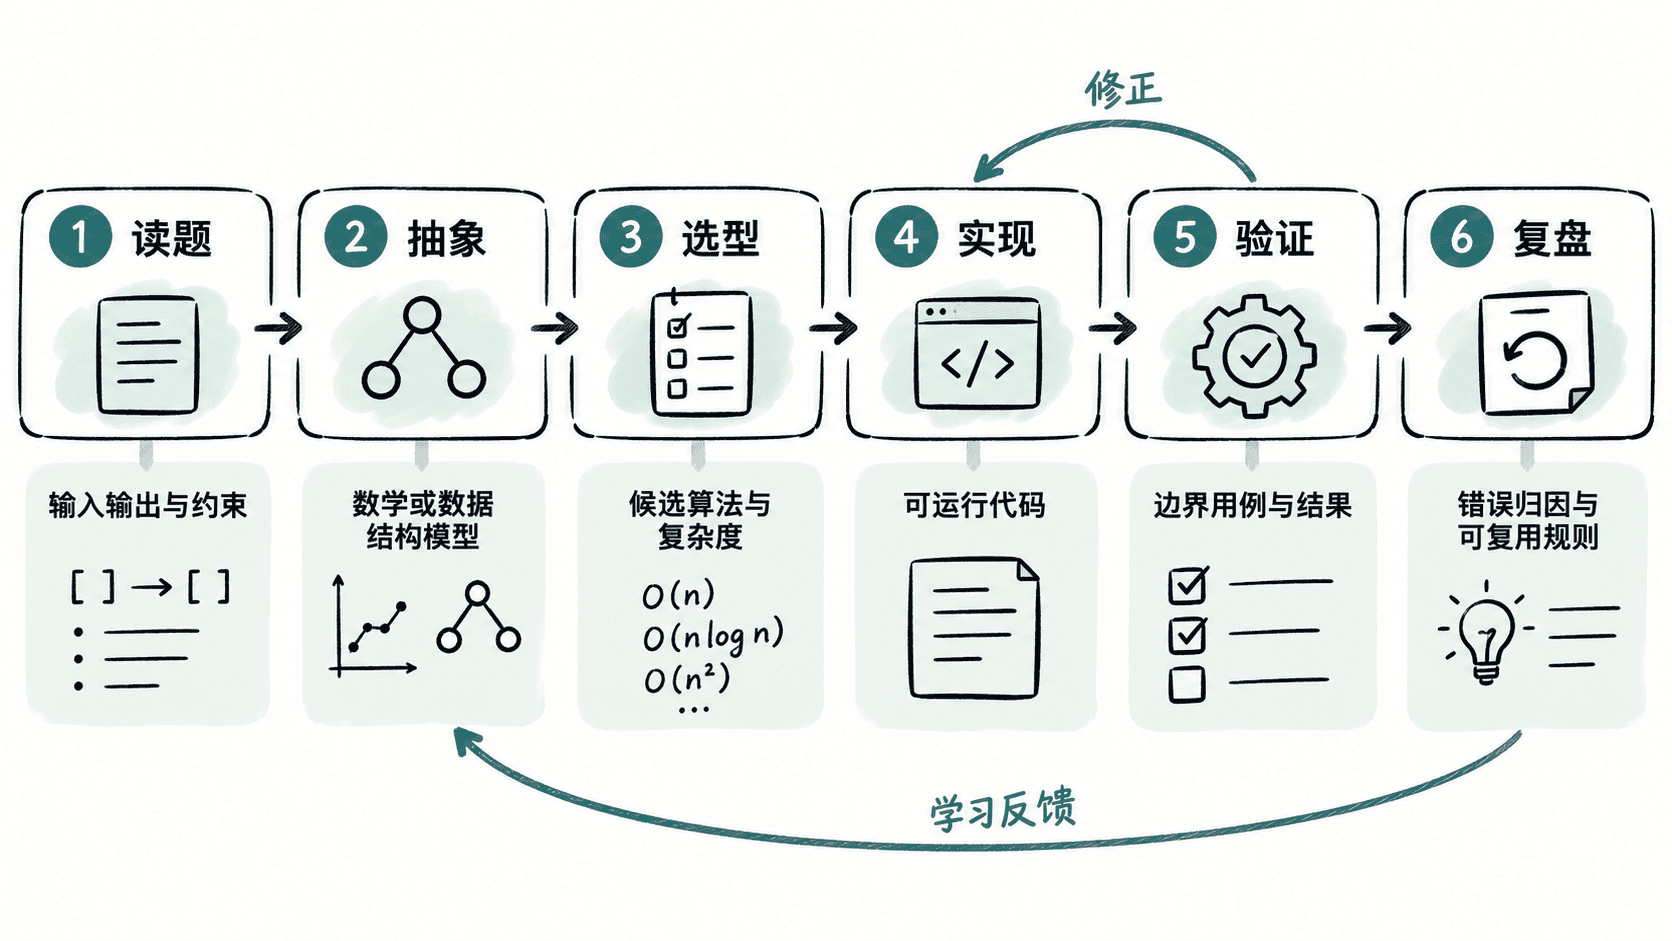
读题阶段只确认三件事:输入是什么、输出是什么、约束是什么。尤其要圈出数据规模、是否有序、是否允许修改原数组、答案是否唯一等条件,因为这些信息会直接影响后面的复杂度和数据结构选择。
抽象阶段要把故事语言翻译成算法语言。例如“找两个数之和等于目标值”,本质是对每个数 x 查找 target - x;“连续子数组”意味着不能随意重排元素;“最少步数”则常常对应最短路或动态规划。
选型阶段先比较候选方案,再动手编码。至少回答两个问题:时间复杂度能否通过约束,空间是否可接受。不要因为熟悉某个模板就强行套用。
实现阶段只把已经确定的思路翻成代码;验证阶段用样例、最小输入、重复值、边界值等用例检查结果;复盘阶段记录“最初为什么没想到”和“以后看到什么信号应想到什么方法”。
用一道 Two Sum 跑完整个闭环
题意:给定整数数组和目标值,返回两个元素下标,使它们之和等于目标值。假设恰好有一个答案,且同一元素不能使用两次。
读题后得到约束目标:需要返回下标;抽象为“扫描当前位置时,检查补数是否已经出现”;选型为哈希表,把暴力枚举的 降到平均 。
def two_sum(nums, target):
    seen = {}
    for i, x in enumerate(nums):
        need = target - x
        # 只在历史元素中找补数,避免同一位置被使用两次。
        if need in seen:
            return [seen[need], i]
        seen[x] = i
    raise ValueError("no solution")

print(two_sum([2, 7, 11, 15], 9))
预期输出
[0, 1]验证不能只看这一组样例。再检查 [3, 3] 与目标值 6,可以确认“先查再写入”允许两个相同数来自不同位置,也不会把同一元素使用两次。
把复盘写成下一次能调用的规则
有效复盘不是记录“这题不会”,而是定位卡点发生在哪一步。如果读题阶段漏掉“数组有序”,问题是约束提取;如果写了 才发现超时,问题是选型前没有做复杂度估算;如果思路正确但边界失败,问题多半在实现或验证。
推荐每题只保留三类记录:触发信号、正确套路、本次失误。例如:“看到两数配对 + 只需一次扫描 → 考虑哈希表补数;本次失误:先写入再查询,错误复用了当前位置。”
用时间盒避免在单题上失去训练节奏
训练时可以给“独立思考”设置时间盒。到时还没有形成可执行思路,就先记录卡在哪一步,再看提示或题解;看完后应重新独立实现并完成验证,而不是只读懂答案。
六步流程的价值在于让失败也产生信息:你不仅知道“这题没做出来”,还知道失败发生在理解、建模、选型、编码还是验证。持续积累这些归因,题型识别和实现稳定性才会一起提高。