
数据结构与算法 / 系统课时
用单调栈寻找最近更优元素
用单调栈寻找最近更优元素
“右边第一个更大值”“左边最近更小值”“下一个更高温度”看似是不同题,其实都在寻找距离最近且满足比较条件的元素。单调栈通过维护尚未找到答案的候选下标,把逐个向后搜索压缩为一次线性扫描。
学习目标
- 从“最近更大/更小”问题中识别单调栈模式
- 正确区分入栈条件、出栈条件和答案结算时机
- 用摊还分析解释单调栈为何是
先确定栈里保存谁
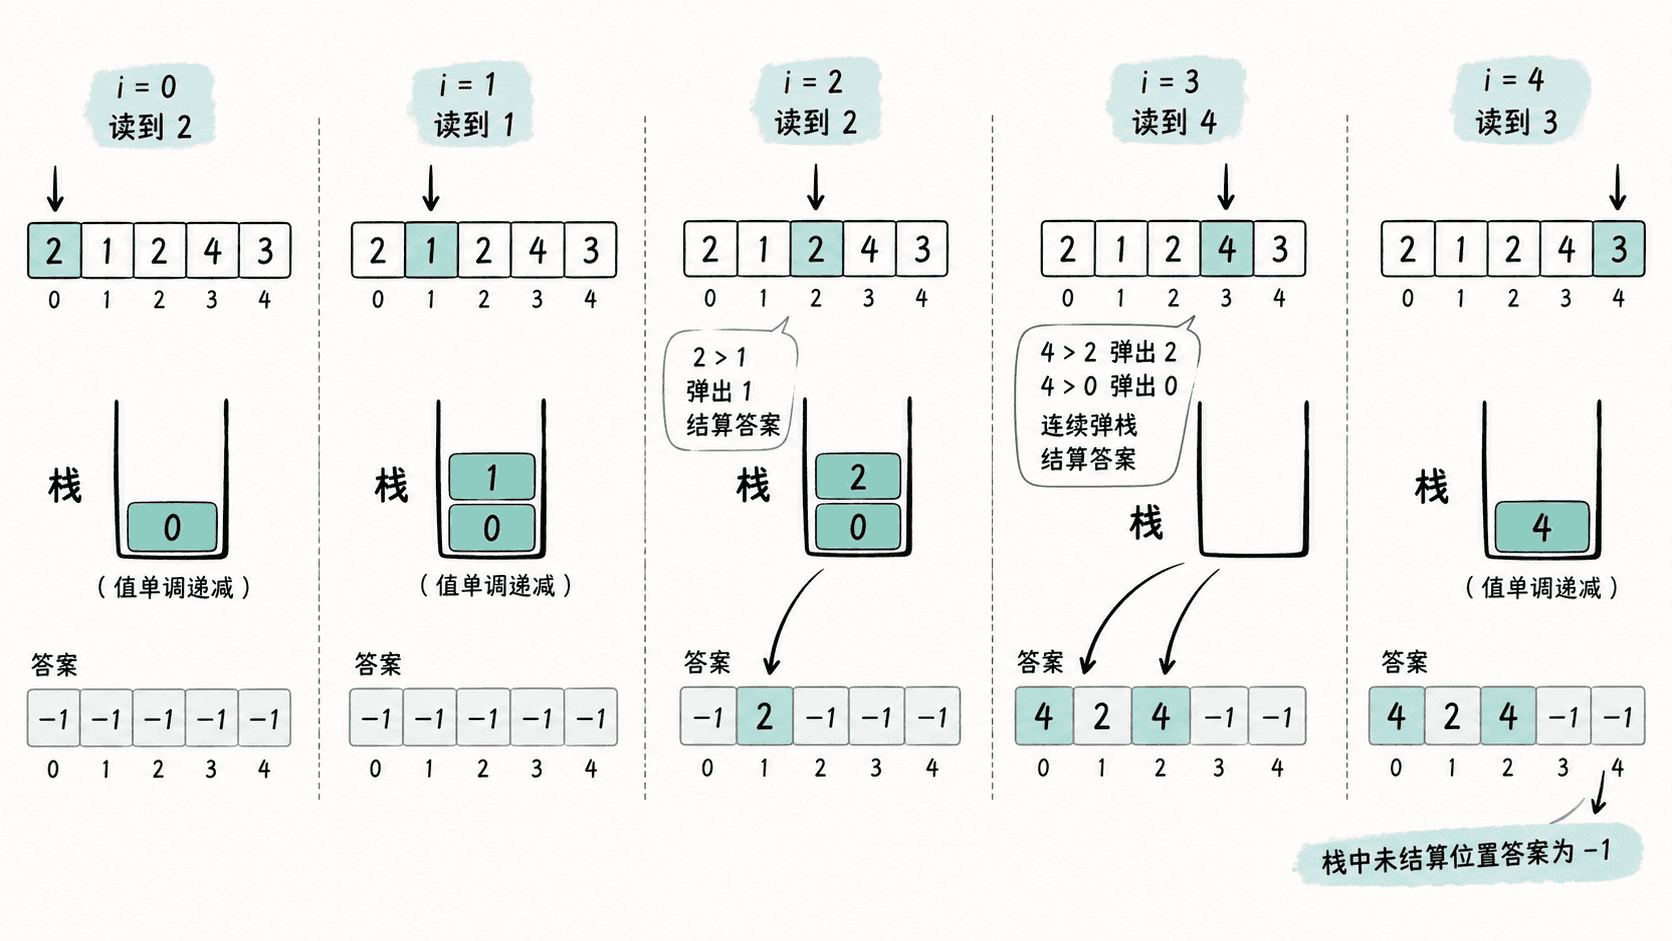
以“右侧第一个更大元素”为例,扫描到位置 i 时,栈里保存的是还没有找到右侧更大元素的下标。这些下标对应的值保持单调递减;如果新值比栈顶值更大,就说明它正是栈顶位置等待的第一个更大元素。
因此算法只有三个动作:新元素到来;不断弹出被它击败的栈顶并结算答案;最后把当前下标压栈,等待未来更大的值。扫描结束仍留在栈中的位置,说明右侧不存在更大元素。
写出右侧第一个更大元素
下面返回每个位置右侧第一个严格更大的值;如果不存在则保留 -1。栈存下标而不是直接存值,这样既能比较大小,也能把答案写回正确位置。
def next_greater(nums: list[int]) -> list[int]:
    ans = [-1] * len(nums)
    stack: list[int] = []

    for i, value in enumerate(nums):
        # 当前值更大时,它就是栈顶位置遇到的第一个更大元素。
        while stack and nums[stack[-1]] < value:
            j = stack.pop()
            ans[j] = value

        # 未结算的下标继续等待右侧更大的值。
        stack.append(i)

    return ans


def main() -> None:
    nums = [2, 1, 2, 4, 3]
    print(next_greater(nums))


if __name__ == "__main__":
    main()
预期输出
[4, 2, 4, -1, -1]位置 1 的值是 1,读到位置 2 的 2 时立刻结算;位置 0 的值是 2 不能被相等的 2 弹出,因为题目要求“严格更大”,直到读到 4 才结算。这正说明比较符号不是细节,而是题意的一部分。
用方向和比较符号推导变体
不要把四种常见题型背成四套模板。先回答两个问题:答案在当前元素的左边还是右边?要找的是更大还是更小?
找右侧答案时,通常从左向右扫描,让当前元素帮助之前的候选结算;找左侧答案时,也可以从左向右扫描,但常在处理当前元素前先弹掉不可能成为答案的栈顶,然后把剩余栈顶当作左侧最近候选。找更大元素时维护递减候选;找更小元素时维护递增候选。
是否允许相等值参与答案,会直接决定使用 <、<=、> 还是 >=。例如题目问“下一个大于等于当前值的元素”,相等值也应触发结算;如果问“严格更大”,相等值必须继续留在栈中。
为什么不是二次复杂度
代码里虽然存在嵌套的 while,但每个下标只会入栈一次,并且最多出栈一次。因此整个扫描过程中,所有 push 与 pop 的总次数都是 ,时间复杂度为 ,辅助空间最坏为 。
这类分析称为摊还分析:某一次扫描可能连续弹出很多元素,但那些元素之后不会再次回到栈里,所以不能把每轮 while 都独立乘上 。
识别不能直接套模板的情况
如果题目要找的不是“最近”满足条件的元素,而是区间最大值、任意满足条件的位置集合,单调栈通常不是首选。环形数组也需要额外处理扫描范围,常见做法是遍历两倍下标但只在第一轮入栈待结算位置。
真正稳定的解题顺序是:先定义答案关系,再决定扫描方向,然后写出栈内单调性和弹栈条件,最后才落代码。只要这四步一致,单调栈就不再是需要死记的模板,而是一套可推导的方法。