
数据结构与算法 / 系统课时
用前中后序选择树的计算时机
用前中后序选择树的计算时机
二叉树题真正难的往往不是“会不会递归”,而是把计算放在递归的哪个位置。前序、中序、后序本质上对应三种计算时机:进入节点就处理、左右子树之间处理、拿到子树结果后再处理。
学习目标
- 根据答案对父节点或子节点结果的依赖选择遍历顺序
- 理解前序、中序、后序只是同一递归骨架中的不同计算位置
- 用可运行示例验证三种顺序产生的访问序列
先看依赖关系再选顺序
选择遍历方式时,不要先背“根左右、左根右、左右根”,而要先问:当前节点的答案依赖什么信息?
如果处理孩子之前就已经拥有所需信息,适合前序。例如路径题常把父节点累计值传给孩子,进入当前节点时就能更新路径状态。
如果问题依赖二叉搜索树的有序性质,常用中序。对于 BST,中序访问会按键值从小到大得到节点,适合第 K 小元素、验证有序性等题。
如果当前节点必须等左右子树都计算完成后才能得出答案,适合后序。树高、平衡判断、子树节点数、直径等自底向上问题都属于这一类。
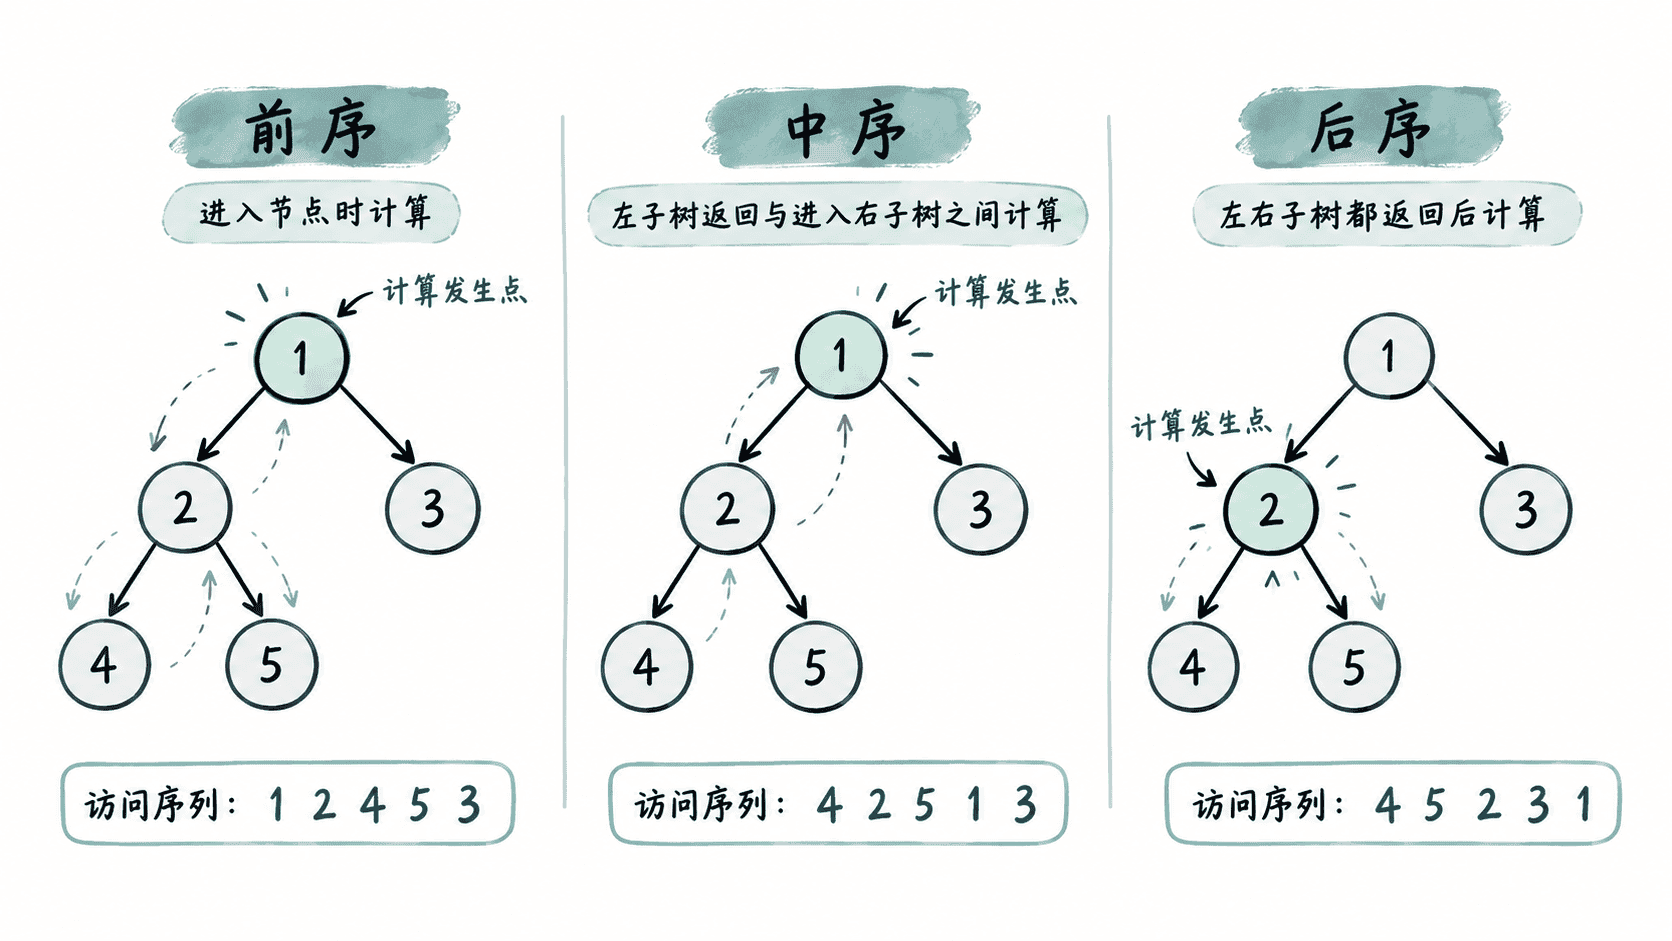
同一递归骨架中的三个位置
下面的完整程序使用同一棵树分别执行三种遍历。注意三个方法结构几乎相同,区别只有 result.add(node.val) 放在递归调用之前、之间还是之后。
import java.util.ArrayList;
import java.util.List;

public class TraversalTimingDemo {
    static class TreeNode {
        int val;
        TreeNode left;
        TreeNode right;

        TreeNode(int val) {
            this.val = val;
        }
    }

    static void preorder(TreeNode node, List<Integer> result) {
        if (node == null) {
            return;
        }

        result.add(node.val); // 进入节点时计算
        preorder(node.left, result);
        preorder(node.right, result);
    }

    static void inorder(TreeNode node, List<Integer> result) {
        if (node == null) {
            return;
        }

        inorder(node.left, result);
        result.add(node.val); // 左子树完成、右子树开始前计算
        inorder(node.right, result);
    }

    static void postorder(TreeNode node, List<Integer> result) {
        if (node == null) {
            return;
        }

        postorder(node.left, result);
        postorder(node.right, result);
        result.add(node.val); // 两棵子树都完成后计算
    }

    public static void main(String[] args) {
        TreeNode root = new TreeNode(1);
        root.left = new TreeNode(2);
        root.right = new TreeNode(3);
        root.left.left = new TreeNode(4);
        root.left.right = new TreeNode(5);

        List<Integer> pre = new ArrayList<>();
        List<Integer> in = new ArrayList<>();
        List<Integer> post = new ArrayList<>();

        preorder(root, pre);
        inorder(root, in);
        postorder(root, post);

        System.out.println("pre=" + pre);
        System.out.println("in=" + in);
        System.out.println("post=" + post);
    }
}
预期输出:
pre=[1, 2, 4, 5, 3]
in=[4, 2, 5, 1, 3]
post=[4, 5, 2, 3, 1]
输出顺序不是为了记忆,而是在验证“计算发生点”。把 result.add 换成真正的业务计算,三种遍历就分别变成自顶向下、中间访问和自底向上的通用模板。
用返回值判断是否该后序
当递归函数需要从左右子树“收集答案”时,通常已经在暗示后序。以树高为例,当前节点高度必须先拿到左子树高度和右子树高度,才能计算 1 + max(left, right)。
这类题常见的函数形态是“递归调用返回子树信息,当前节点合并两个结果,再把新结果返回父节点”。如果你发现自己在访问父节点时还不知道答案,说明计算位置放早了,应把逻辑移动到两个递归调用之后。
反过来,如果函数参数携带的是“从父节点传下来的状态”,例如当前路径和、当前深度、已经选择的节点,那么往往应在递归进入节点时先更新状态,再把新状态传给孩子,这更接近前序。
中序不是通用的中间态
中序在普通二叉树上只是固定的访问顺序,并不会天然产生特殊性质。它真正高频的场景是二叉搜索树,因为 BST 满足左子树键值小于当前节点、右子树键值大于当前节点,所以中序结果具有有序性。
因此看到普通树的最大深度、直径、最近公共祖先等题时,不要因为“中序位于左右递归之间”就机械套用。先判断依赖方向,再决定计算时机,比背遍历名称更可靠。
把题目翻译成依赖关系后,选择会很直接:父状态向下传播用前序,BST 借助有序性常用中序,子树结果向上汇总用后序。