
数据结构与算法 / 系统课时
把错误归因到解题流程节点
把错误归因到解题流程节点
刷题复盘最没价值的记录是“这题不会”或“代码写错了”。真正能指导下一次行动的复盘,要把失败定位到读题、建模、选型、实现、边界或复杂度中的具体节点,再针对薄弱节点修正方法。
学习目标
- 能把一次错误归入六类解题流程节点,而不是只记录最终答案
- 能根据错误发生的位置选择对应的改进动作
- 能用统一记录方式发现自己反复出现的薄弱环节
六个节点对应六种不同问题
一道题从题面到通过,通常会经历“读懂约束 → 建立模型 → 选择套路 → 写出实现 → 处理边界 → 检查复杂度”。最终的 Wrong Answer、Time Limit Exceeded 或完全没有思路,只是失败的表面结果,并不能直接说明根因。
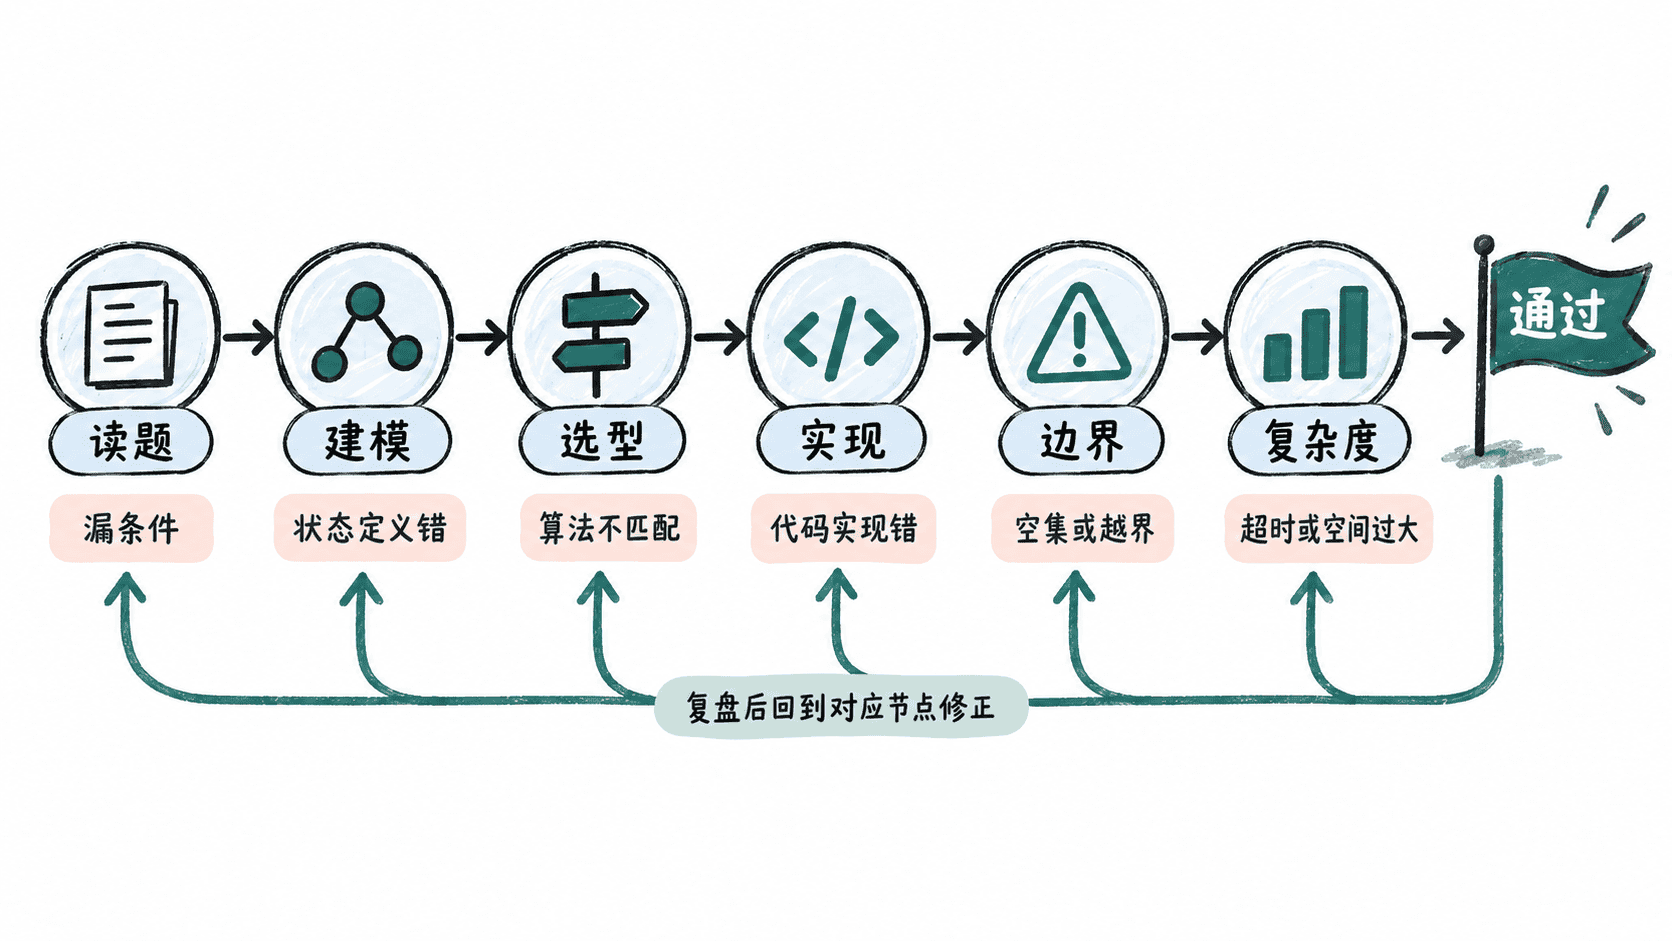
读题错误发生在题意还没有被准确接收时,例如忽略“连续”“恰好”“至少”、数据是否有序、元素能否重复使用。此时即使后面的算法和代码都正确,也是在解决另一个问题。
建模错误是知道题目在问什么,却没有把它转换成正确的状态、区间、图关系或判定条件。例如把“最长连续子数组”误建成“最长子序列”,属于对象定义已经偏离。
选型错误是模型基本正确,但选择的套路不适合约束。例如本可用滑动窗口维护的单调区间却枚举所有区间,或者存在负数时仍套用依赖单调性的窗口策略。
实现错误发生在思路正确、代码没有忠实实现思路时,常见表现包括指针更新次序错误、变量含义混用、状态转移漏分支。
边界错误集中在空输入、单元素、首尾位置、重复值、极值以及循环开闭区间。它与实现错误相近,但值得单独记录,因为很多人会稳定地在同一种边界上失分。
复杂度错误则是答案逻辑正确,但时间或空间无法承受输入规模。此时重点不是继续修补代码,而是回到选型节点重新判断是否缺少预处理、剪枝、数据结构或更合适的算法。
从失败现象向前追根因
看到错误结果时,不要立即把原因记成“实现错误”。更有效的顺序是从前往后检查:题意是否理解正确,模型是否准确,算法是否满足模型和约束,最后才检查代码细节。因为前面的节点一旦错了,后面的正确实现也没有意义。
例如一道题超时,表面上是复杂度问题,但继续追问可能发现真正原因是选型错误:已经识别出“连续区间”,却没有利用窗口边界具有单调移动的性质。这样记录后,下次应该训练的是“识别滑动窗口条件”,而不是笼统地提醒自己“注意复杂度”。
给每类错误配一个改进动作
归因的价值在于决定下一步训练什么。读题错误可以要求自己圈出限制词并手写输入输出关系;建模错误应重新回答“状态或数据结构里的每个量表示什么”;选型错误需要补充题型识别条件;实现错误则应比较思路步骤与代码执行顺序。
边界错误适合建立固定检查项,例如空集、最小规模、最大规模、重复值和首尾位置。复杂度错误则必须在编码前先估算数量级:输入达到 时, 往往已经值得警惕,而不能等超时后才考虑替代方案。
同一道题可以记录一个主因和一个诱因。例如“主因:选型错误;诱因:没有注意输入规模”,比同时给六类都打勾更有价值。主因应指向最早使解题方向发生偏离的节点。
用复盘记录发现重复模式
每次错题只需保留四项:题目、错误节点、具体证据、下次动作。证据必须具体,例如“遗漏数组可含负数,错误使用只适用于非负数的窗口缩减规则”,而不是“滑动窗口不熟”。
连续积累一段时间后,按错误节点统计频率。如果十道错题中六道都在建模阶段偏离,就不应继续把主要精力放在代码模板;如果思路通常正确却频繁败在边界,则应把边界样例设计加入提交前流程。
错误归因的最终目标不是给失败贴标签,而是把“为什么没做出来”转成下一次可执行的动作。只要能够稳定找到最早出错的流程节点,错题记录就会从答案收藏夹变成真正的训练反馈系统。