
数据结构与算法 / 系统课时
用并查集合并动态连通分量
用并查集合并动态连通分量
当边不断加入、题目反复询问“两点是否连通”或“当前还有多少个集合”时,每次重新 DFS 都会重复工作。并查集把每个连通分量压成一棵代表树,通过查找根节点和合并根节点,高效维护只增不减的连通关系。
学习目标
- 理解父节点数组如何表示多个互不相交的集合。
- 能实现路径压缩与按大小合并,并解释两者为什么能降低树高。
- 能判断并查集适合增量连通、离线合并,而不擅长直接处理删除边。
用代表元维护集合
并查集为每个元素维护一个父节点 parent[x]。根节点满足 parent[x] == x,它就是所在集合的代表元。判断两个元素是否属于同一集合,只需要比较它们最终找到的根是否相同。
合并两个集合时,不能只把任意节点互连,而应先分别找到两个根,再把一棵树的根挂到另一棵树的根上。这样集合结构始终是一片森林。
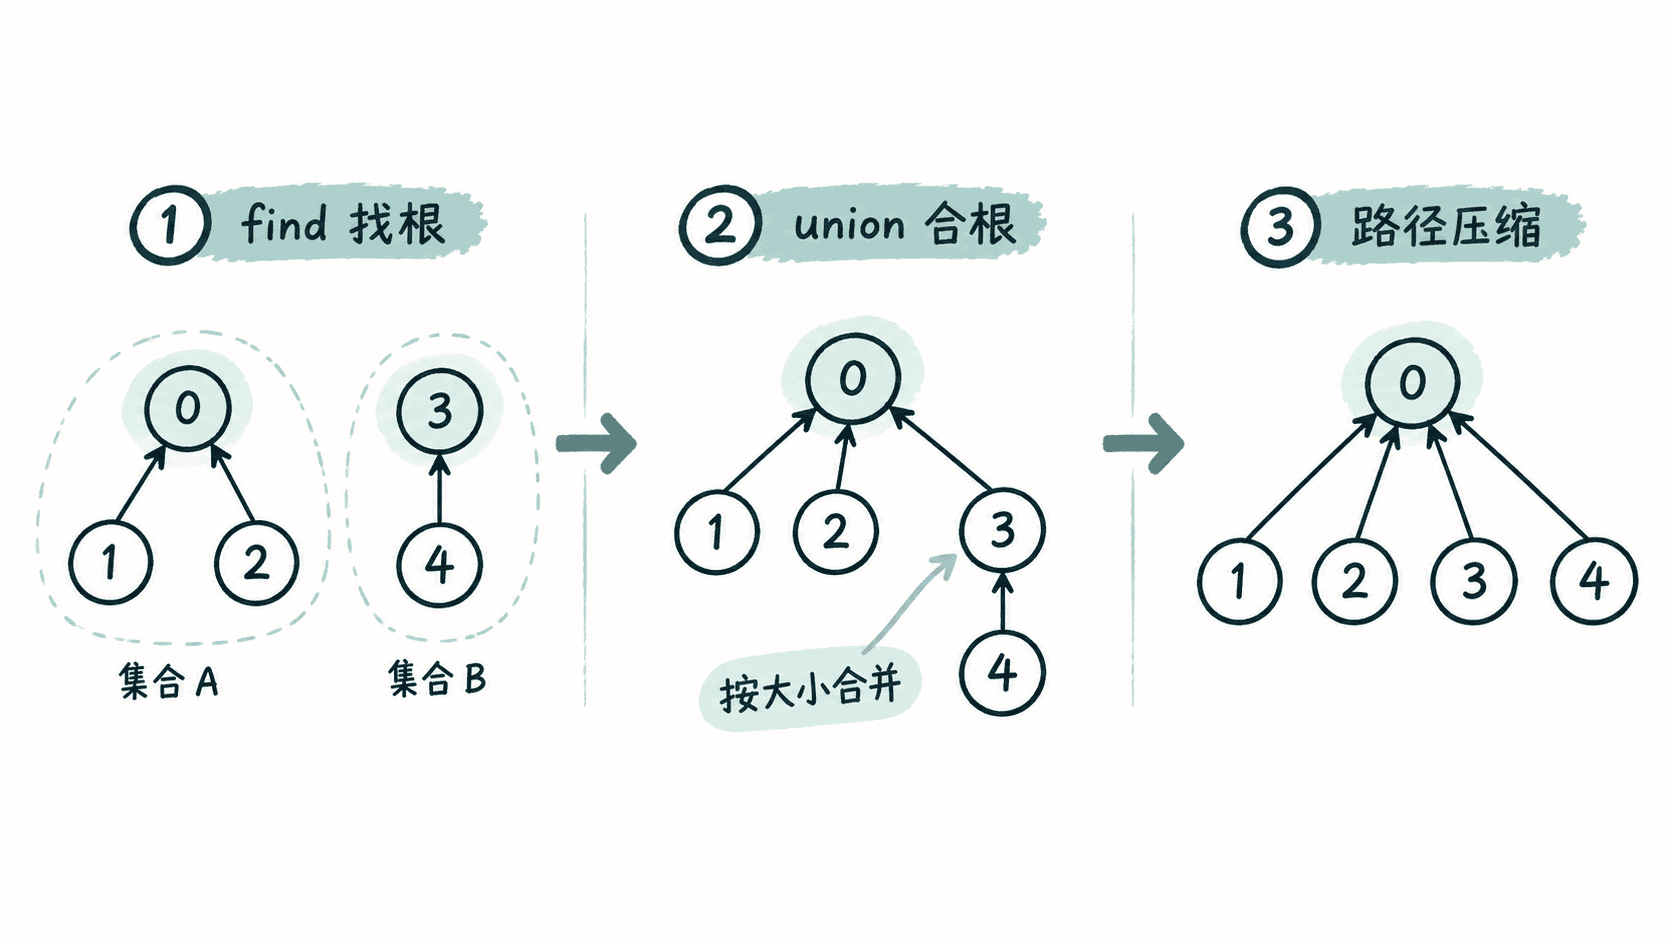
如果每次合并都随意挂接,树可能退化成很长的链。常见的两个优化是:find 返回时执行路径压缩,让沿途节点直接指向根;union 时按集合大小或秩合并,让较小的树挂到较大的树上。
实现带路径压缩的并查集
下面的完整 Java 程序维护 6 个节点。边依次加入后,可以查询任意两点是否连通,也可以直接读取当前连通分量数量。
public class UnionFindDemo {
    static class UnionFind {
        private final int[] parent;
        private final int[] size;
        private int components;

        UnionFind(int n) {
            parent = new int[n];
            size = new int[n];
            components = n;

            for (int i = 0; i < n; i++) {
                parent[i] = i;
                size[i] = 1;
            }
        }

        int find(int x) {
            if (parent[x] != x) {
                // 递归返回时把路径上的节点直接连到根。
                parent[x] = find(parent[x]);
            }
            return parent[x];
        }

        boolean union(int a, int b) {
            int rootA = find(a);
            int rootB = find(b);
            if (rootA == rootB) {
                return false;
            }

            // 小集合挂到大集合,避免树持续变高。
            if (size[rootA] < size[rootB]) {
                int tmp = rootA;
                rootA = rootB;
                rootB = tmp;
            }

            parent[rootB] = rootA;
            size[rootA] += size[rootB];
            components--;
            return true;
        }

        boolean connected(int a, int b) {
            return find(a) == find(b);
        }

        int components() {
            return components;
        }
    }

    public static void main(String[] args) {
        UnionFind uf = new UnionFind(6);

        uf.union(0, 1);
        uf.union(1, 2);
        uf.union(3, 4);
        uf.union(2, 4);

        System.out.println(uf.connected(0, 4));
        System.out.println(uf.connected(0, 5));
        System.out.println(uf.components());
    }
}
预期输出:
true
false
2四次合并后,0、1、2、3、4 已经属于同一集合,节点 5 仍然独立,因此最终有两个连通分量。
为什么这两个优化有效
路径压缩优化的是后续查找:一旦某条长路径被访问,路径上的节点会直接靠近根。按大小合并优化的是合并当下:尽量避免把大树挂到小树下面。二者一起使用后,单次 find 或 union 的均摊代价接近常数,通常记为 O(α(n)),其中 α 是增长极慢的反阿克曼函数。
维护分量数量时也不必重新遍历所有节点。初始化为 n,只有当两个原本不同的根成功合并时才减一;如果两点本来就在同一集合,union 应返回失败并保持计数不变。
适用边界
并查集最适合“连接只会增加”的问题,例如逐条加入道路后查询城市是否连通、合并账户、判断无向图是否出现冗余边,以及先收集查询再离线处理的连通性问题。
它不直接保存两点之间的具体路径,也不擅长边删除。删除一条边后,一个集合可能裂成多个部分,而并查集没有足够信息恢复这种拆分。需要频繁删除边时,应考虑离线逆序、回滚并查集或其他动态连通数据结构。
判断是否该用并查集,可以抓住一句话:如果题目主要操作是“把两个集合合起来”,主要查询是“是否同组或还有几组”,并且关系总体只增不减,并查集通常比反复图搜索更合适。