
容器与云原生 / 系统课时
编写 CSI 存储故障 Runbook
编写 CSI 存储故障 Runbook
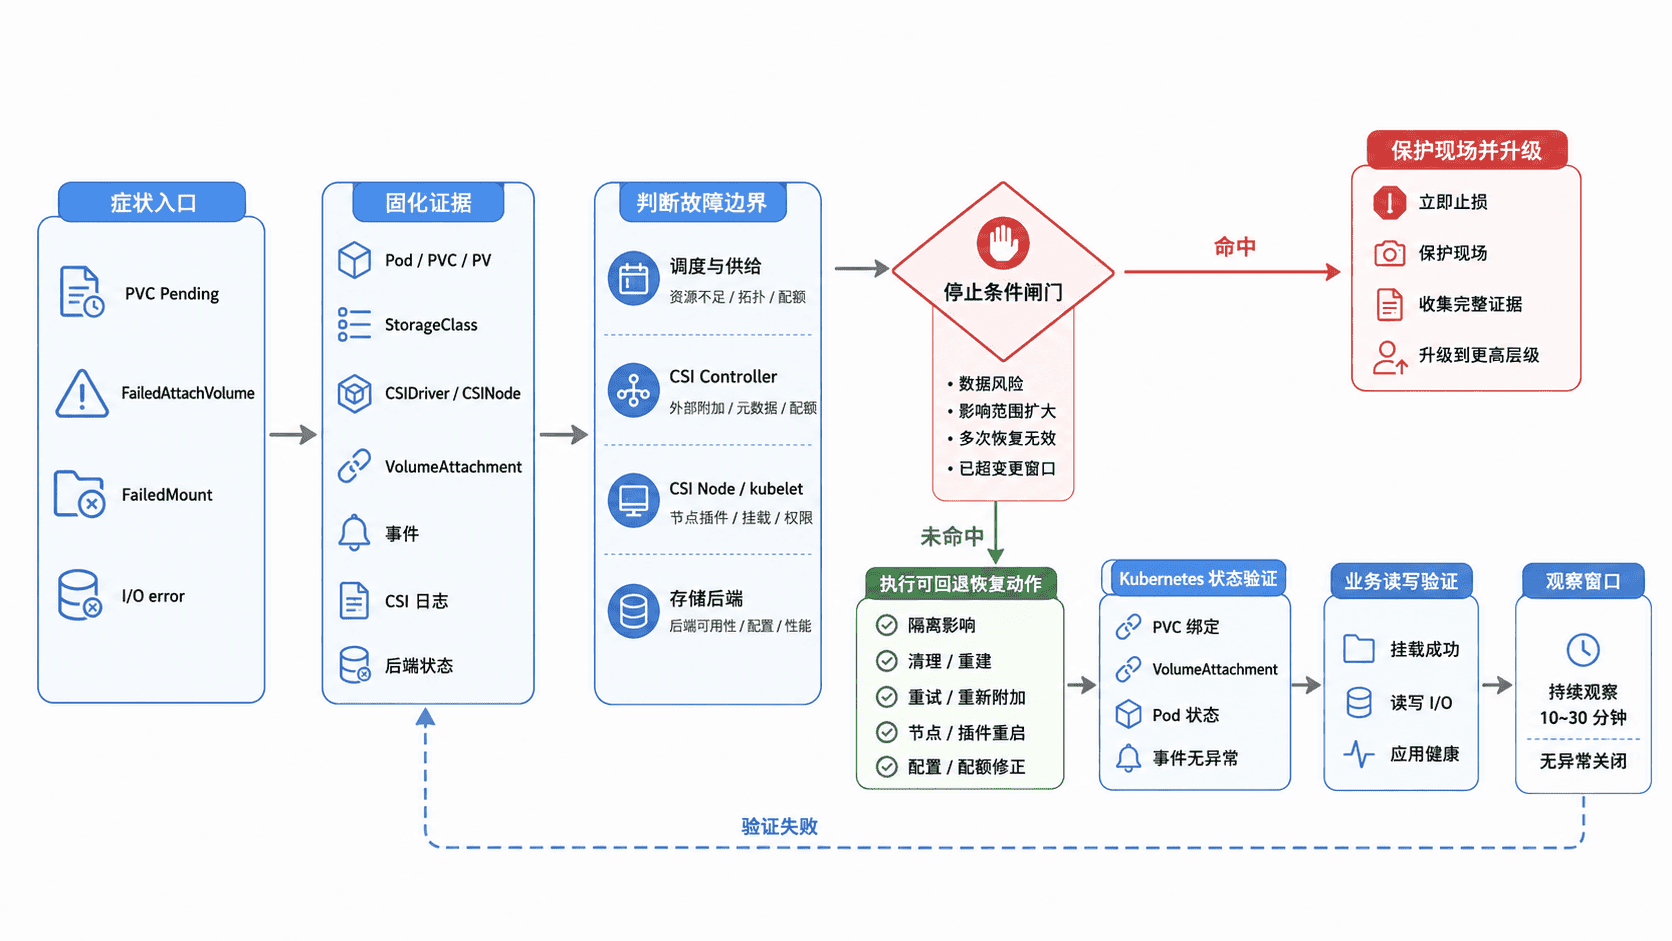
CSI 故障处理最怕“边查边猜”。本节把一次故障处置固化成可执行 Runbook:从症状入口收集证据,设置停止条件,再按故障边界恢复,并用业务验证与升级交接完成闭环。
学习目标
- 为常见 CSI 故障定义可检索的症状入口和证据清单。
- 写清停止条件、恢复前提、回退方式与验证步骤。
- 建立能直接交接给平台、存储或应用团队的升级路径。
用症状入口约束排查范围
Runbook 的入口应写“看到了什么”,不要先写“可能是什么”。值班人员拿到告警后,先把现象归入少量稳定类别,再沿对应证据链排查。
| 症状入口 | 第一批证据 | 优先判断的边界 |
|---|---|---|
| PVC 长时间 Pending | PVC 事件、StorageClass、provisioner 状态 | 动态供给、容量、拓扑 |
| Pod 出现 FailedAttachVolume | Pod 事件、VolumeAttachment、CSI Controller 日志 | attach 控制面、后端卷 |
| Pod 出现 FailedMount | Pod 事件、CSINode、CSI Node 日志、kubelet 日志 | 节点插件、挂载、设备 |
| 应用出现 I/O error 或只读 | Pod/Node 状态、内核与 CSI Node 日志、后端健康 | 节点、文件系统、存储后端 |
每个入口还要声明适用范围,例如“仅适用于通过 PVC 使用的 CSI 持久卷”,并记录负责人、最近一次验证日期和对应驱动版本,避免把同一份 Runbook 生搬到不同驱动。
固化一份最小证据包
Runbook 不应只写“执行 kubectl 看看”。证据要能回答五个问题:哪个工作负载受影响、PVC 是否已绑定、PV 由哪个 CSI 驱动管理、Pod 是否已调度到节点、错误最早出现在哪一层。先固定对象身份,再补事件、日志和后端状态。
将占位符替换为现场值后执行下面的主示例。它只读取对象,不修改集群状态,适合作为 Runbook 的第一段采证命令。
NS="default"
POD="<POD>"
PVC="<PVC>"

SC="$(kubectl get pvc "$PVC" -n "$NS" -o jsonpath='{.spec.storageClassName}')"
PV="$(kubectl get pvc "$PVC" -n "$NS" -o jsonpath='{.spec.volumeName}')"
NODE="$(kubectl get pod "$POD" -n "$NS" -o jsonpath='{.spec.nodeName}')"
POD_UID="$(kubectl get pod "$POD" -n "$NS" -o jsonpath='{.metadata.uid}')"
PVC_UID="$(kubectl get pvc "$PVC" -n "$NS" -o jsonpath='{.metadata.uid}')"

echo "pod=$NS/$POD uid=$POD_UID node=${NODE:-<UNSCHEDULED>}"
echo "pvc=$PVC uid=$PVC_UID storageClass=${SC:-<EMPTY>} pv=${PV:-<UNBOUND>}"

if [ -n "$PV" ]; then
  PV_UID="$(kubectl get pv "$PV" -o jsonpath='{.metadata.uid}')"
  DRIVER="$(kubectl get pv "$PV" -o jsonpath='{.spec.csi.driver}')"
  echo "pv=$PV uid=$PV_UID driver=${DRIVER:-<NON_CSI_OR_EMPTY>}"
fi
预期输出
pod=default/<POD> uid=<POD_UID> node=<NODE>
pvc=<PVC> uid=<PVC_UID> storageClass=<STORAGE_CLASS_OR_EMPTY> pv=<PV>
pv=<PV> uid=<PV_UID> driver=<CSI_DRIVER>
若 PVC 尚未绑定,pv 会显示 <UNBOUND>,且不会输出第三行;若 Pod 尚未调度,node 会显示 <UNSCHEDULED>。实际对象名与 UID 由现场决定。这里必须使用正确的 kubectl get pod 获取节点名,否则后续节点侧证据链就失去可靠来源。
身份固定后,再把 Pod、PVC、PV 的详细状态与事件、相关 StorageClass、CSIDriver、目标节点的 CSINode、适用时的 VolumeAttachment、CSI Controller/Node 日志、kubelet 日志、后端卷状态和近期变更记录加入同一事件时间线。证据应保留原始时间戳和对象 UID,只截取一条错误文案容易丢失重试顺序,也无法判断错误发生在故障之前还是恢复之后。
把恢复动作写成前提、动作与回退
Runbook 中的恢复动作应按故障边界组织,而不是列一串“常用命令”。每个动作至少写清三件事:什么证据满足时才能执行、执行后期待哪个状态改变、失败时如何回退或停止。
| 故障边界 | 可接受的恢复方向 | 不应作为第一动作 |
|---|---|---|
| CSI Controller/sidecar 异常 | 先恢复控制面工作负载与依赖,再观察供给或 attach 是否继续推进 | 删除 PVC/PV 重新来过 |
| 单节点 CSI Node 或 kubelet 异常 | 先确认影响范围,再恢复节点插件;需要迁移时按工作负载和卷语义评估 | 未确认挂载状态就强制 detach |
| 存储后端不可用或路径异常 | 由存储侧恢复卷、链路或服务,并保持 Kubernetes 侧证据 | 在集群侧反复重建对象制造更多重试 |
| 拓扑或调度约束不满足 | 修正错误的节点标签、亲和性或存储拓扑配置,并重新验证调度条件 | 为了“让 Pod 跑起来”随意放宽数据安全约束 |
用验证与升级路径完成闭环
恢复后按同一顺序验证:PVC/PV 关系正常,Pod 调度和 Ready 状态恢复;若驱动需要 attach,相关 attach 状态不再报错;事件中不再产生同类失败;应用使用安全的读写或一致性检查确认数据可用;最后在组织规定的 <WINDOW> 观察窗口内确认错误率、延迟和重试没有重新恶化。
生产验证不要为了“证明能写”随意修改业务数据。优先使用应用已有的健康检查、只读校验或专用测试对象;确需写入时,必须定义测试数据、清理方式和可接受影响。
升级路径要写到“谁接手、带什么证据、为什么现在升级”。交接包至少包含事件编号、首次失败时间、影响范围、Namespace/Pod/PVC/PV、CSI driver、Node、关键事件与日志时间段、近期变更、已执行动作、当前数据风险、命中的停止条件,以及下一位负责人需要回答的问题。
一份可上线的 CSI Runbook,不以“命令很多”为完成标准,而以任何值班人员都能从同一症状入口得到同一证据、在危险动作前停下来、执行可回退恢复,并能证明业务数据真正恢复为验收标准。