
容器与云原生 / 系统课时
设计存储告警与 SLO
设计存储告警与 SLO
只按“失败次数大于零”报警会在短暂抖动时刷屏,也可能错过持续退化。本课从供应延迟、Attach/Mount 成功率、容量和关键卷可用性定义 SLI、SLO 与错误预算,并用多窗口燃烧率把页面告警、工单和容量预警分层。
学习目标
- 为供应、Attach/Mount、容量与卷可用性选择可计算的 SLI
- 用 SLO 和错误预算区分偶发失败与持续可靠性退化
- 编写并校验多窗口燃烧率与容量告警规则
从用户结果定义 SLI
SLO 不应写成“CSI Pod 一直 Running”,因为组件存活不等于卷可用。供应 SLI 可以定义为“在目标时限内完成 Bound 的 PVC 比例”;Attach/Mount 可以按成功操作数占总操作数计算;关键卷可用性应结合 Pod 挂载结果或合成探针。容量本身更适合作为风险水位,而不是成功率 SLO。
成功率型 SLI 可以统一表示为:
若 30 天目标是 99.9%,错误预算比例就是 。例如统计期内有 1,000,000 次受保护操作,可容忍约 1,000 次不满足 SLI 的操作。这里展示的是计算方法,不是 Kubernetes 或 CSI 的默认目标;实际 SLO 必须根据业务等级、历史基线和驱动能力设定。
把告警分成症状与原因
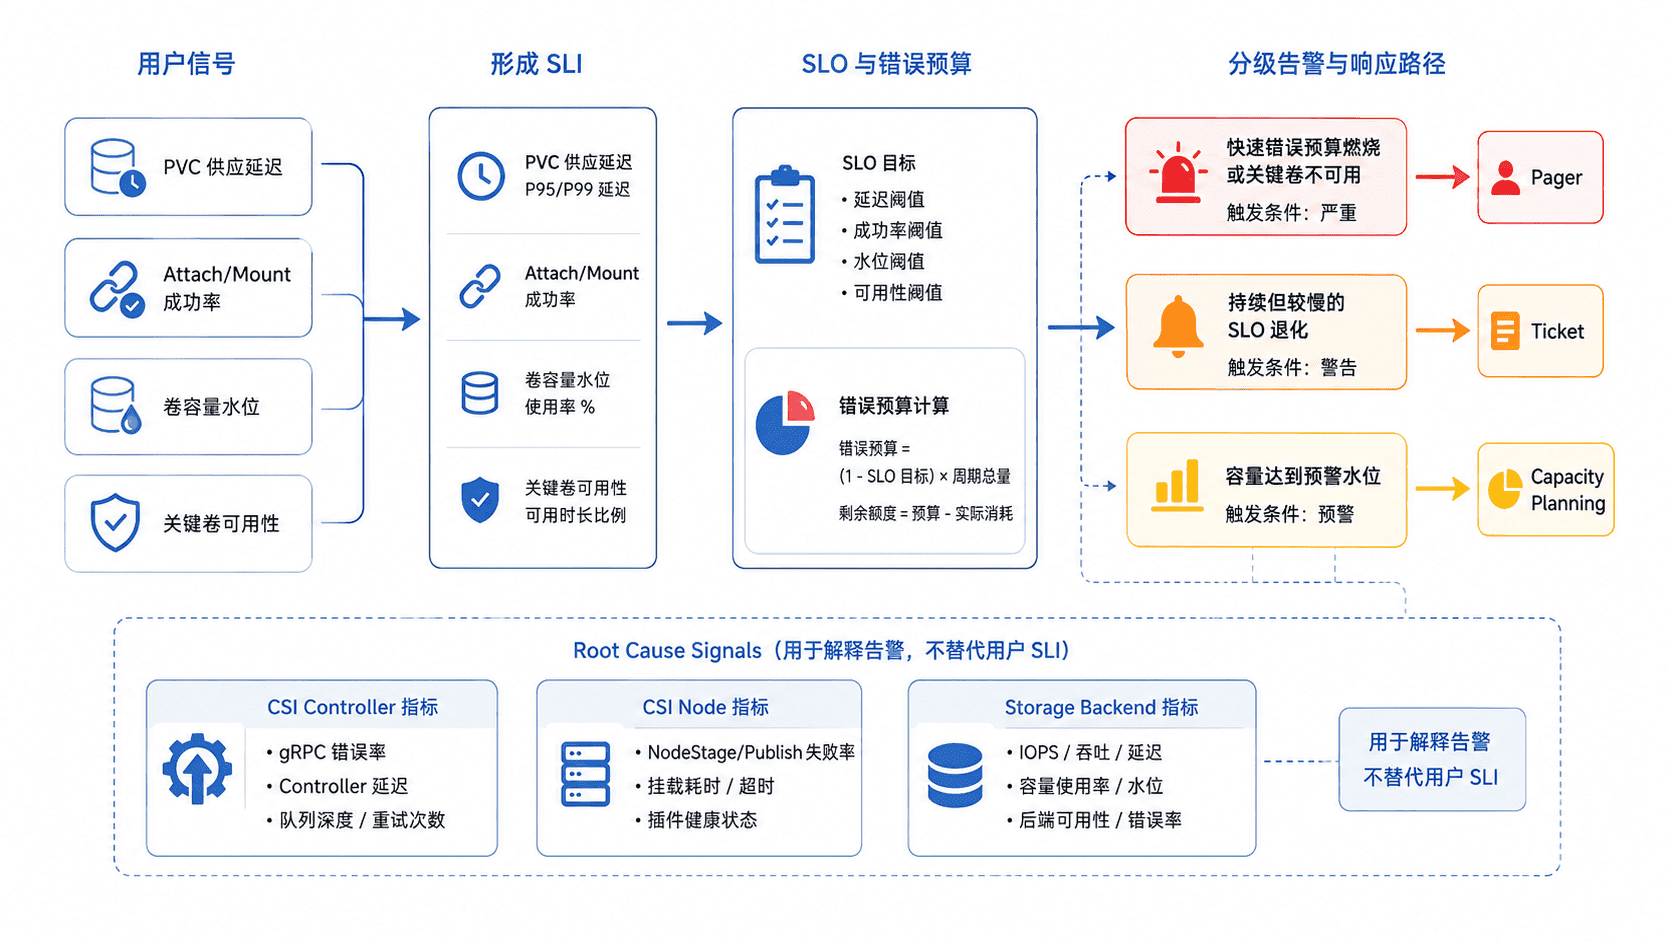
症状告警回答“用户是否正在受影响”,例如关键卷持续不可挂载、供应延迟大量超标;原因告警回答“哪一层可能有问题”,例如 CSI Node 错误率上升或后端 API 变慢。只有原因信号异常而用户 SLI 未下降时,通常不应直接触发最高级别页面告警。
容量要单独分层。比如 80% 可以进入容量计划,90% 且持续一段时间再升级;阈值必须结合增长速度、扩容提前量和存储类型校准,不能把同一个百分比机械套给所有卷。
用多窗口燃烧率编写规则
不同驱动暴露的原始指标并不统一,生产环境更适合先建立 recording rules,再让告警依赖团队自己的规范化指标。下面假设已经得到 storage_sli_operations_total{cluster,operation,result} 和 storage_volume_used_ratio;前者把超过供应时限、Attach/Mount 失败等事件统一分类为 result="error",二者都不是 Kubernetes 内置指标。
错误预算燃烧率表示“当前消耗预算的速度相对允许速度高多少倍”:
对于 99.9% SLO,预算比例是 0.001。14.4 倍燃烧率表示当前错误比例约为 1.44%,6 倍表示约为 0.6%。短窗口确认问题仍在发生,长窗口确认它不是瞬时尖峰;同一组标签的两个窗口都超过阈值时才升级。
groups:
  - name: storage-slo
    rules:
      - record: storage:sli_burn_rate:rate5m
        expr: |
          (
            sum by (cluster, operation) (
              rate(storage_sli_operations_total{result="error"}[5m])
            )
            /
            clamp_min(
              sum by (cluster, operation) (
                rate(storage_sli_operations_total[5m])
              ),
              0.000001
            )
          )
          / 0.001

      - record: storage:sli_burn_rate:rate1h
        expr: |
          (
            sum by (cluster, operation) (
              rate(storage_sli_operations_total{result="error"}[1h])
            )
            /
            clamp_min(
              sum by (cluster, operation) (
                rate(storage_sli_operations_total[1h])
              ),
              0.000001
            )
          )
          / 0.001

      - record: storage:sli_burn_rate:rate30m
        expr: |
          (
            sum by (cluster, operation) (
              rate(storage_sli_operations_total{result="error"}[30m])
            )
            /
            clamp_min(
              sum by (cluster, operation) (
                rate(storage_sli_operations_total[30m])
              ),
              0.000001
            )
          )
          / 0.001

      - record: storage:sli_burn_rate:rate6h
        expr: |
          (
            sum by (cluster, operation) (
              rate(storage_sli_operations_total{result="error"}[6h])
            )
            /
            clamp_min(
              sum by (cluster, operation) (
                rate(storage_sli_operations_total[6h])
              ),
              0.000001
            )
          )
          / 0.001

      - alert: StorageSLOBudgetBurnFast
        expr: |
          storage:sli_burn_rate:rate5m > 14.4
          and on (cluster, operation)
          storage:sli_burn_rate:rate1h > 14.4
        for: 2m
        labels:
          severity: page
        annotations:
          summary: "Storage SLO error budget is burning fast"

      - alert: StorageSLOBudgetBurnSlow
        expr: |
          storage:sli_burn_rate:rate30m > 6
          and on (cluster, operation)
          storage:sli_burn_rate:rate6h > 6
        for: 5m
        labels:
          severity: ticket
        annotations:
          summary: "Storage SLO error budget is burning persistently"

      - alert: StorageVolumeCapacityHigh
        expr: storage_volume_used_ratio > 0.90
        for: 30m
        labels:
          severity: ticket
        annotations:
          summary: "Storage volume usage is above 90%"
前两条告警直接比较 burn rate:快速燃烧触发 Pager,较低但持续的燃烧进入 Ticket。容量告警仍使用固定水位,因为它关注的是剩余空间和扩容提前量,不适合套用成功率燃烧率。若 SLO 不是 99.9%,应把规则中的 0.001 改为对应的错误预算比例,并重新校准燃烧率阈值和窗口。
将配置保存为 storage-slo-rules.yaml 后,用 promtool 检查 YAML 与 PromQL。
promtool check rules storage-slo-rules.yaml预期输出
Checking storage-slo-rules.yaml
  SUCCESS: 7 rules found
不同 Prometheus 版本的成功提示格式可能略有差异;关键验收条件是退出码为 0,并且没有解析或规则校验错误。
演练并验收告警
上线前至少做一次可恢复的故障演练,确认 SLI 下降后短、长窗口都按预期变化,规则进入 Pending、持续满足条件后转为 Firing,并在恢复后自动清除。还要确认告警至少能定位 cluster、operation;驱动或节点类根因规则应保留 driver、node 等必要标签,或提供可跳转的 runbook 入口。
最终维护一张 SLO 清单,记录每个业务等级的指标定义、统计窗口、目标值、错误预算、告警级别和负责人。SLO 回答“可靠性是否达标”,告警回答“现在是否需要行动”,根因指标则回答“问题可能发生在哪一层”。