
容器与云原生 / 系统课时
演练节点宕机后的有状态恢复
演练节点宕机后的有状态恢复
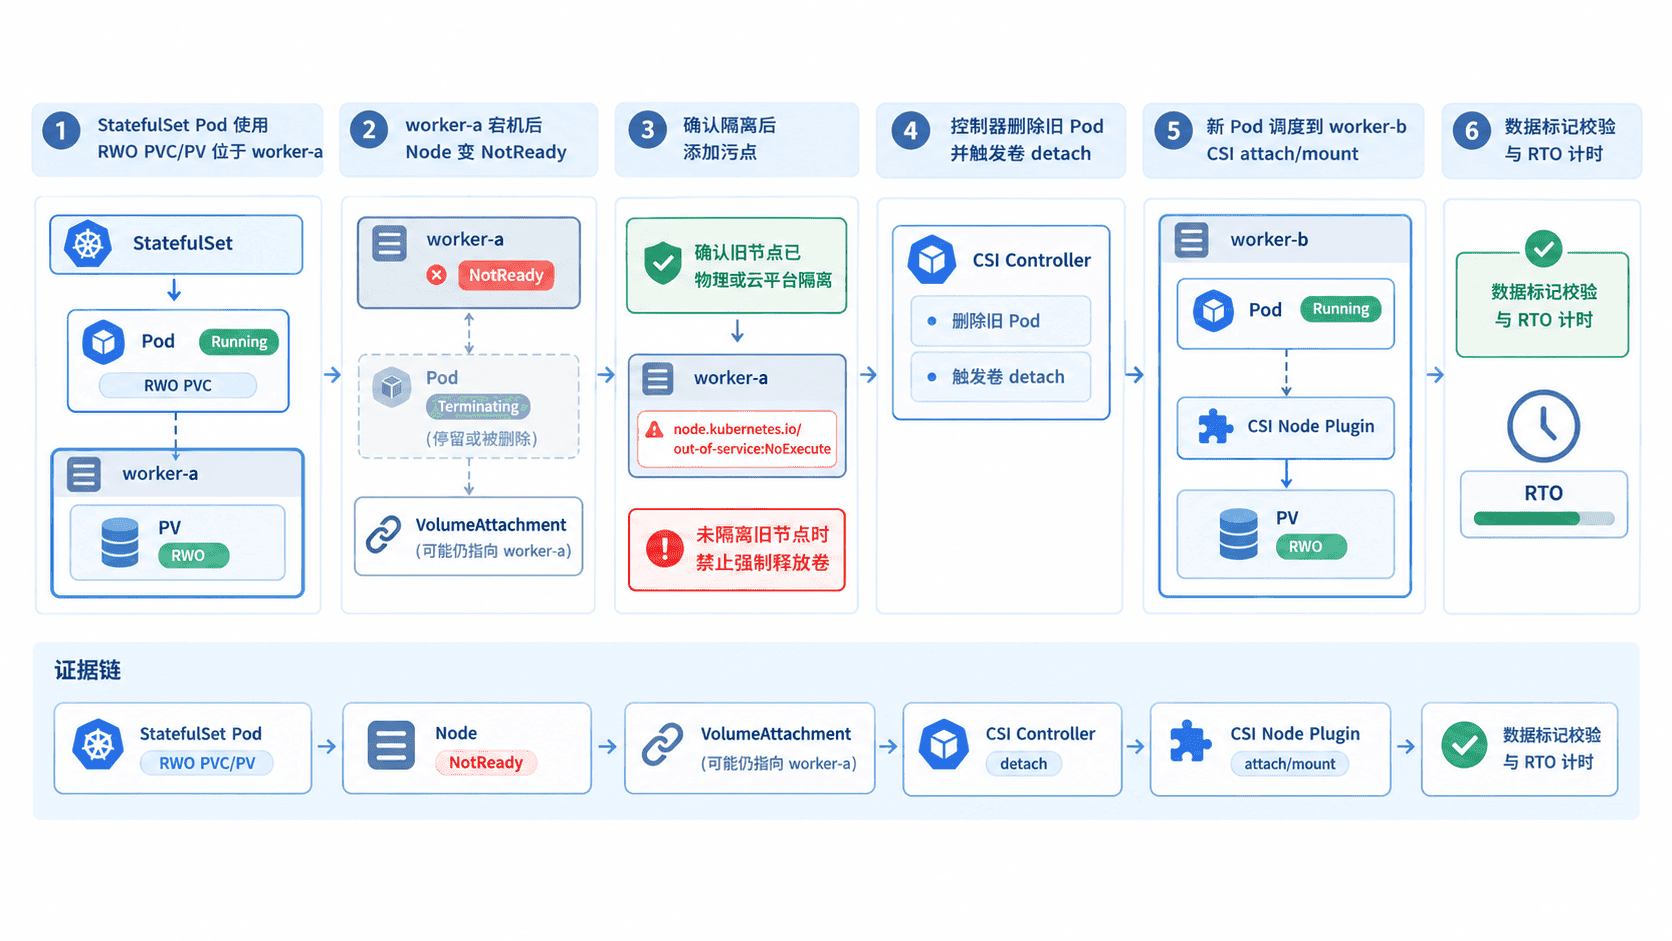
本课通过一次可控的节点宕机演练,串起 StatefulSet 旧 Pod 残留、RWO 卷释放与重新附着、同名新 Pod 重建、数据校验和恢复时间。核心证据是 Pod UID:Pod 不会从故障节点原地“迁移”,必须先删除旧对象,控制器才能创建同名但新 UID 的实例。
学习目标
- 用 Pod UID、Node、PVC/PV 和 VolumeAttachment 判断恢复停在哪一层
- 正确识别旧 StatefulSet Pod 删除后,控制器创建同名新 UID Pod 的过程
- 用卷状态、业务数据和恢复时间记录验证演练结果
固定故障前基线
以一个使用 ReadWriteOnce PVC 的 StatefulSet 为例。先记录 db-0 的 UID、节点和 PV,再写入唯一标记。后续即使 Pod 仍叫 db-0,也能用 UID 判断它究竟是旧对象,还是 StatefulSet 新建的替代实例。以下命令建议在同一终端会话连续执行,以保留 OLD_UID 与 PV_NAME 变量。
OLD_UID=$(kubectl get pod -n storage-drill db-0 -o jsonpath='{.metadata.uid}')
PV_NAME=$(kubectl get pvc -n storage-drill data-db-0 -o jsonpath='{.spec.volumeName}')

kubectl exec -n storage-drill db-0 -- sh -c 'date -u +%FT%TZ > /data/drill-marker && sync'
echo "old pod uid=$OLD_UID"
echo "pv=$PV_NAME"
kubectl get pod -n storage-drill db-0 \
  -o custom-columns='NAME:.metadata.name,UID:.metadata.uid,NODE:.spec.nodeName,PHASE:.status.phase'
kubectl get pvc -n storage-drill data-db-0
预期输出:
old pod uid=<OLD_UID>
pv=pvc-<ID>
NAME   UID         NODE       PHASE
db-0   <OLD_UID>   worker-a   Running
NAME        STATUS   VOLUME     CAPACITY   ACCESS MODES
data-db-0   Bound    pvc-<ID>   20Gi       RWO
实际 UID、PV 名称和节点名会不同。随后通过已授权的电源、虚拟化或云平台让 worker-a 非正常离线,并记录故障发生时间 <TIME>。生产演练必须先具备可靠的 fencing 或断电确认手段;如果旧节点仍可能访问该卷,强制推进恢复会带来双写或文件系统损坏风险。
确认旧 Pod 仍属于故障节点
非优雅关机后,API 中的旧 db-0 可能继续存在并保持原 UID、原 spec.nodeName。只要这个对象还没有被删除,StatefulSet 就不能同时创建另一个同名 db-0,因此不能把“Pod 自动从 worker-a 调度到 worker-b”当作恢复机制。
date -u +%FT%TZ
kubectl get pod -n storage-drill db-0 \
  -o custom-columns='NAME:.metadata.name,UID:.metadata.uid,NODE:.spec.nodeName,PHASE:.status.phase'
kubectl get node worker-a
kubectl get volumeattachment \
  -o custom-columns='NAME:.metadata.name,NODE:.spec.nodeName,PV:.spec.source.persistentVolumeName,ATTACHED:.status.attached'
kubectl describe pod -n storage-drill db-0
预期结果中的关键证据类似:
<TIME>
NAME   UID         NODE       PHASE
db-0   <OLD_UID>   worker-a   <PHASE>
worker-a   NotReady
csi-<ID>   worker-a   pvc-<ID>   true
<PHASE> 可能因控制器处理进度而不同,但此时应重点核对 UID 是否仍为 <OLD_UID>、节点是否仍为 worker-a。如果事件出现 attach、detach 或 multi-attach 相关错误,说明存储接管尚未完成;不要通过手工删除 VolumeAttachment 来伪造“已释放”。
安全触发非优雅节点恢复
只有在确认 worker-a 已经关机或被可靠隔离后,才给节点添加 node.kubernetes.io/out-of-service 污点。对不容忍该污点的 Pod,Kubernetes 会推进非优雅节点关机恢复;旧 db-0 被删除后,StatefulSet 才能创建同名但新 UID 的 Pod,并由调度器选择健康节点。
kubectl taint nodes worker-a node.kubernetes.io/out-of-service=nodeshutdown:NoExecute

CURRENT_UID=''
for i in $(seq 1 90); do
  CURRENT_UID=$(kubectl get pod -n storage-drill db-0 -o jsonpath='{.metadata.uid}' 2>/dev/null || true)
  if [ -n "$CURRENT_UID" ] && [ "$CURRENT_UID" != "$OLD_UID" ]; then
    break
  fi
  sleep 2
done

if [ -z "$CURRENT_UID" ] || [ "$CURRENT_UID" = "$OLD_UID" ]; then
  echo 'replacement pod not created' >&2
  exit 1
fi

kubectl wait -n storage-drill --for=condition=Ready pod/db-0 --timeout=300s
echo "old uid=$OLD_UID"
echo "new uid=$CURRENT_UID"
kubectl get pod -n storage-drill db-0 \
  -o custom-columns='NAME:.metadata.name,UID:.metadata.uid,NODE:.spec.nodeName,PHASE:.status.phase'
预期输出:
node/worker-a tainted
pod/db-0 condition met
old uid=<OLD_UID>
new uid=<NEW_UID>
NAME   UID         NODE       PHASE
db-0   <NEW_UID>   worker-b   Running
这里的验收重点不是 Pod 名称,而是 <NEW_UID> 与 <OLD_UID> 不同。名称保持 db-0 是 StatefulSet 的稳定网络身份与序号语义,UID 变化才证明旧对象已删除、新对象已创建。新 Pod 最终落到哪个健康节点取决于调度结果,不保证一定是 worker-b。
如果新 Pod 已创建却持续卡在 attach/detach,应继续检查 CSI Controller 日志、后端卷状态和存储厂商的 fencing 或强制 detach 流程;不要把删除 Kubernetes VolumeAttachment 当作通用修复。
验证卷、数据与恢复时间
恢复完成后要同时验证新 UID、卷附着位置、业务数据和 Readiness。单独看到 Running 只能说明容器进程已启动,不能证明数据路径和应用服务已经恢复。
kubectl get volumeattachment \
  -o custom-columns='NAME:.metadata.name,NODE:.spec.nodeName,PV:.spec.source.persistentVolumeName,ATTACHED:.status.attached'
kubectl exec -n storage-drill db-0 -- sh -c 'cat /data/drill-marker && test -w /data && echo writable'
kubectl get pod -n storage-drill db-0 -o jsonpath='{.metadata.uid}'; echo
kubectl get pod -n storage-drill db-0 -o jsonpath='{.status.containerStatuses[0].ready}'; echo
date -u +%FT%TZ
预期输出:
csi-<ID>   worker-b   pvc-<ID>   true
<TIME>
writable
<NEW_UID>
true
<TIME>
VolumeAttachment 名称、节点和时间会因环境而不同。用故障发生时间到业务重新通过健康检查的时间计算本次 RTO;故障前写入的标记仍存在,只能证明这条检查路径没有观察到数据丢失,生产 RPO 仍需结合数据库事务、日志或应用一致性校验判断。节点修复并确认可重新提供服务后,再执行 kubectl taint nodes worker-a node.kubernetes.io/out-of-service- 移除污点,并确认节点、Pod 与卷状态稳定。