
容器与云原生 / 系统课时
安全执行节点维护与驱逐
安全执行节点维护与驱逐
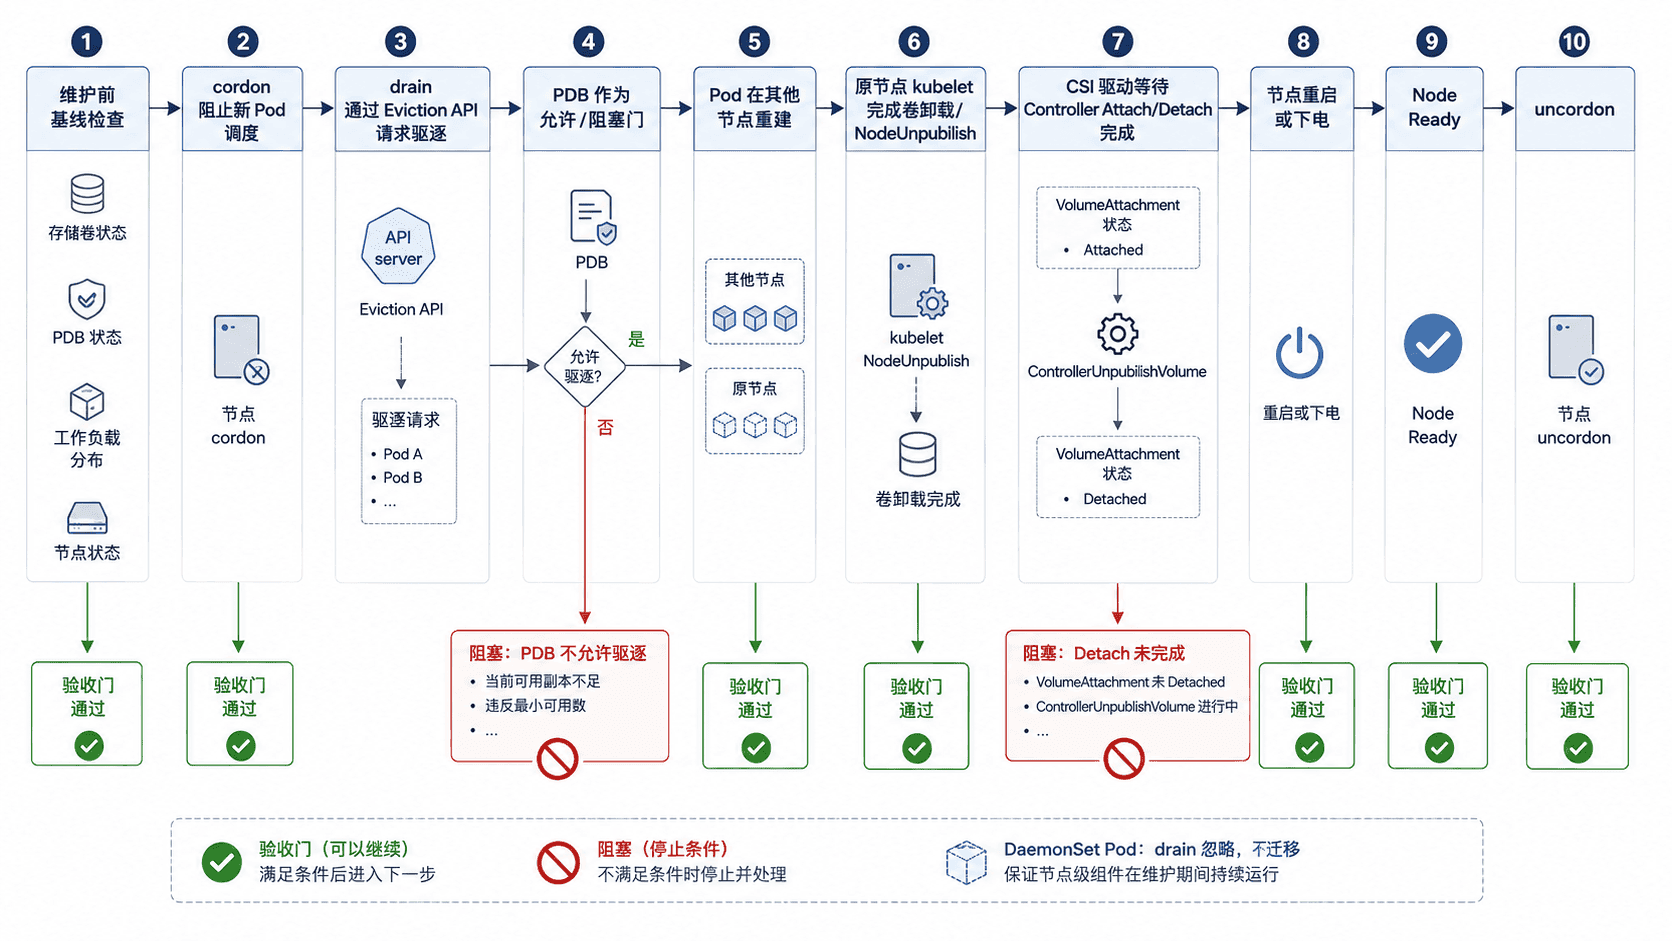
节点维护真正危险的不是执行 drain,而是把“Pod 已驱逐”误当成“存储已经安全离开节点”。本课把 cordon、PDB、Pod 终止、卷 Detach 和节点恢复串成一条可中止、可验证的维护链路,只有证据满足才进入下一阶段。
学习目标
- 区分 cordon、Eviction/PDB 与卷 Detach 各自解决的问题
- 按固定证据门执行节点维护,避免绕过可用性保护
- 在恢复调度前验证节点、Pod 与存储状态
维护前先定义停止条件
cordon 只把节点标记为不可调度,不会迁走已有 Pod;kubectl drain 会处理节点上的 Pod,并在可用时通过 Eviction API 发起驱逐,因此受 PodDisruptionBudget(PDB)约束。drain 本身也会把节点设为不可调度,这里仍显式拆出 cordon,目的是让“停止新调度”和“开始驱逐”成为两个独立检查点。
维护前至少确认三类风险:关键工作负载是否有足够健康副本、PDB 是否允许当前驱逐、节点上是否存在 emptyDir 或没有控制器托管的 Pod。若相关 PDB 的 ALLOWED DISRUPTIONS 为 0,应先恢复副本或调整维护窗口;不要用绕过 PDB 的参数把风险转移到线上。
按证据门执行维护链路
下面把基线采集、cordon、drain、Detach 验收和恢复放在一个主流程里。命令应从不受目标节点维护影响的管理终端执行;把 <NODE> 替换为实际节点名,对象数量、版本、Pod 名称、ID 和等待时间会因集群而不同。
set -euo pipefail

NODE="<NODE>"

# 1. 采集基线:确认节点、驻留 Pod、PDB 与 CSI Attach 能力。
kubectl get node "$NODE"
kubectl get pods -A --field-selector "spec.nodeName=$NODE" -o wide
kubectl get pdb -A
kubectl get csidriver \
  -o custom-columns=NAME:.metadata.name,ATTACH_REQUIRED:.spec.attachRequired
kubectl get volumeattachments.storage.k8s.io \
  -o custom-columns=NAME:.metadata.name,ATTACHER:.spec.attacher,NODE:.spec.nodeName,ATTACHED:.status.attached

# 2. 显式封锁新调度,再开始受 PDB 保护的驱逐。
kubectl cordon "$NODE"
kubectl get node "$NODE"
kubectl drain "$NODE" --ignore-daemonsets --timeout=15m

# 3. drain 完成后验证业务 Pod 已离开,并检查旧节点的 VolumeAttachment。
kubectl get pods -A --field-selector "spec.nodeName=$NODE" -o wide
kubectl get volumeattachments.storage.k8s.io \
  -o custom-columns=NAME:.metadata.name,NODE:.spec.nodeName,ATTACHED:.status.attached \
  | grep -F "$NODE" || true

# 4. drain 与 Detach 验收通过后执行实际维护;人工确认维护完成再继续。
read -r -p "完成节点维护并确认节点已重新启动后,按 Enter 继续..." _
kubectl wait --for=condition=Ready "node/$NODE" --timeout=5m
kubectl uncordon "$NODE"
kubectl get node "$NODE"
预期输出
NAME      STATUS   ROLES    AGE     VERSION
<NODE>    Ready    <ROLE>   <AGE>   <VERSION>
...
NAMESPACE   NAME   MIN AVAILABLE   MAX UNAVAILABLE   ALLOWED DISRUPTIONS   AGE
<NS>        <PDB>  <VALUE>         <VALUE>           <VALUE>               <AGE>
...
NAME       ATTACH_REQUIRED
<DRIVER>   true
...
node/<NODE> cordoned
NAME      STATUS                     ROLES    AGE     VERSION
<NODE>    Ready,SchedulingDisabled   <ROLE>   <AGE>   <VERSION>
node/<NODE> already cordoned
evicting pod <NAMESPACE>/<POD>
...
node/<NODE> drained
NAMESPACE   NAME                 READY   STATUS    NODE     ...
<NS>        <DAEMONSET_POD>      1/1     Running   <NODE>   ...
node/<NODE> condition met
node/<NODE> uncordoned
NAME      STATUS   ROLES    AGE     VERSION
<NODE>    Ready    <ROLE>   <AGE>   <VERSION>
drain 完成后,目标节点上通常只剩 DaemonSet Pod、静态 Pod 等不会被 drain 正常迁移的对象。若命令因 emptyDir 或无控制器 Pod 中止,应先确认数据是否允许丢失、工作负载是否可重建,再决定是否增加相应参数;不要把失败直接解释为“需要强制”。
把卷 Detach 作为独立验收门
Pod 已离开节点并不等于存储已经脱离旧节点。VolumeAttachment 表达卷与节点之间的 Attach/Detach 意图;对 CSIDriver.spec.attachRequired=true 的 CSI 驱动,它是判断控制面是否仍认为旧节点占用卷的重要证据。
执行主流程中的检查时,旧节点对应的 VolumeAttachment 在 Detach 完成后通常会消失;过渡期可能仍看到对象或 ATTACHED 状态尚未完成切换。若仍显示卷挂在旧节点,尤其是单节点写入的块存储,不应急于下电后在其他节点强行接管,应先继续检查 external-attacher、CSI Controller 和存储后端的 Detach 状态。
若驱动的 attachRequired=false,Kubernetes 会跳过控制器 Attach 流程,此时没有 VolumeAttachment 是正常现象。维护验收应改看该驱动的节点侧卸载行为、kubelet/CSI Node 日志以及后端会话状态,不能把“查不到 VolumeAttachment”当成统一的成功标准。
恢复调度前做反向验证
节点维护完成后,先等待节点重新达到 Ready,再执行 uncordon。解除封锁后还要确认被迁移的工作负载已在目标节点重新就绪、相关 PVC 仍为 Bound,并检查是否出现新的 attach、mount、multi-attach 或 timeout 事件。
安全维护的核心顺序是:停止新调度 → 确认 PDB 与数据风险 → 驱逐 Pod → 验证需要 Detach 的卷已离开旧节点 → 维护节点 → 等待节点恢复 Ready → 恢复调度。任何一个证据门不满足,都应停在当前阶段处理根因,而不是继续向后推进。