
容器与云原生 / 系统课时
升级 CSI 驱动与 Sidecar
升级 CSI 驱动与 Sidecar
CSI 升级不是“把所有镜像标签一起改掉”。真正需要控制的是 Kubernetes 版本、CSI 驱动、各个 sidecar、CRD/RBAC 与后端能力之间的兼容边界。本课给出一套先建矩阵、再分阶段 rollout、最后判断能否回滚的升级方法。
学习目标
- 建立 Kubernetes、CSI Driver、sidecar 与 CRD 的兼容矩阵
- 设计可暂停的 controller 与 node 组件滚动升级顺序
- 识别普通镜像回滚与对象/存储迁移之间的边界
先把“驱动版本”拆成兼容矩阵
CSI controller Pod 往往同时包含驱动容器和 external-provisioner、external-attacher、external-resizer、external-snapshotter 等 sidecar;Node DaemonSet 还会包含 node-driver-registrar 等组件。它们有各自的发布节奏、最低 Kubernetes 版本与 CSI Spec 支持范围,不能把某个 sidecar 的兼容结论直接套到全部组件。:contentReference[oaicite:3]{index=3}
升级单至少应记录以下矩阵:
| 层级 | 必须核对的内容 | 典型风险 |
|---|---|---|
| Kubernetes | 当前/目标版本、相关 API 是否可用 | sidecar 启动但访问的 API 不存在 |
| CSI Driver | 驱动版本、CSI Spec、后端存储支持 | RPC 或后端能力不兼容 |
| Controller sidecar | provisioner、attacher、resizer、snapshotter 等各自版本 | feature gate、leader election、对象字段变化 |
| Node sidecar | registrar、健康检查组件与节点插件版本 | 注册失败、新卷无法 mount |
| API/CRD | Snapshot、VolumeGroupSnapshot 等 CRD 的 served/storage 版本 | 新控制器读写旧 schema 失败 |
| RBAC | 新增资源与 verbs | 控制器升级后持续 Forbidden |
先从运行中的工作负载提取真实镜像,不要只相信 Helm values 或 Git 仓库里的“期望版本”。
NS="<CSI_NAMESPACE>"
kubectl -n "$NS" get deployment,daemonset \
  -o jsonpath='{range .items[*]}{.kind}{"\t"}{.metadata.name}{"\t"}{range .spec.template.spec.containers[*]}{.name}{"="}{.image}{" "}{end}{"\n"}{end}'
预期输出
Deployment	<CSI_CONTROLLER>	csi-driver=<DRIVER_IMAGE>:<VERSION> csi-provisioner=<PROVISIONER_IMAGE>:<VERSION> ...
DaemonSet	<CSI_NODE>	csi-driver=<DRIVER_IMAGE>:<VERSION> node-driver-registrar=<REGISTRAR_IMAGE>:<VERSION> ...
命名空间、容器名和镜像会因厂商而异。把这份运行时清单与驱动发行说明、每个 sidecar 对应版本的 release notes 对齐后,才能决定允许的升级跨度。
把升级做成分阶段 rollout
不存在对所有 CSI 驱动都正确的固定“controller 先还是 node 先”。顺序取决于目标版本是否引入新的 CSI 能力、拓扑、CRD 或注册要求;例如某些拓扑能力启用场景需要先让节点侧发布完整拓扑信息,再更新 controller/provisioner。:contentReference[oaicite:4]{index=4}
一个可审计的默认流程是:冻结 StorageClass 与驱动配置变更;导出当前 Deployment、DaemonSet、RBAC 和 CRD;确认发行说明允许从当前版本直接升级;按发行说明准备 CRD/RBAC 前置条件;滚动 controller 并验证;再按小批量滚动 Node DaemonSet,并在每批节点上完成新建卷、挂载与卸载测试。任何一步失败都停止扩大批次。
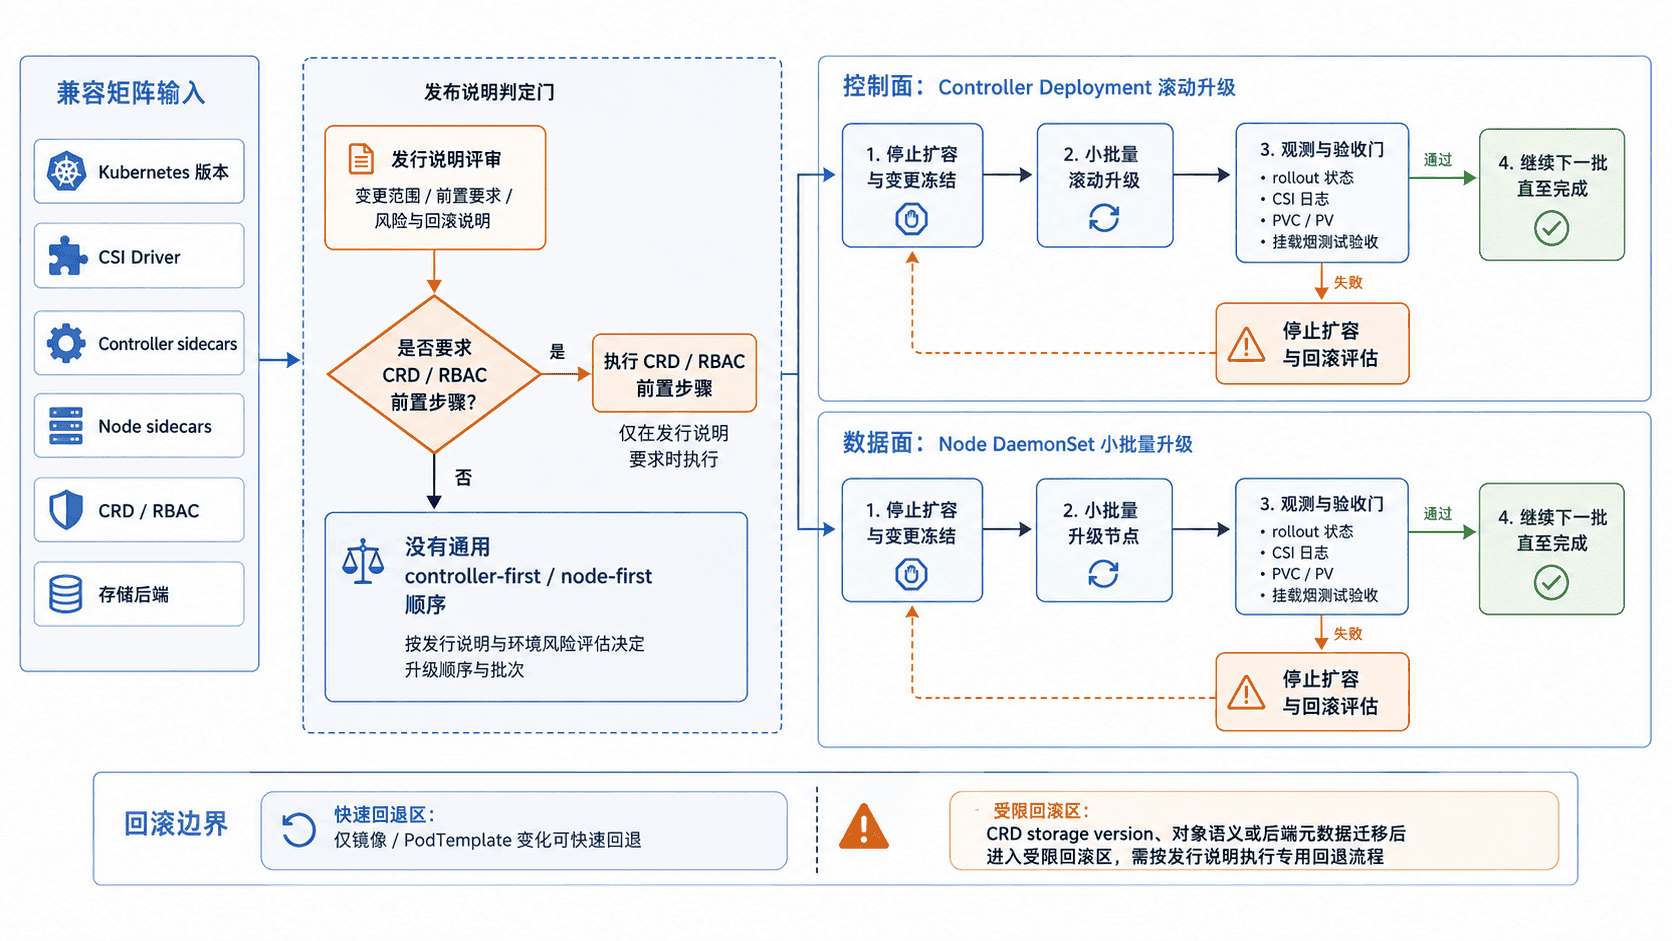
升级每个工作负载后都应等待 rollout 完成,而不是只看新 Pod 是否出现。
NS="<CSI_NAMESPACE>"
CTRL="<CSI_CONTROLLER_DEPLOYMENT>"
NODE_DS="<CSI_NODE_DAEMONSET>"

kubectl -n "$NS" rollout status "deployment/$CTRL" --timeout=10m
kubectl -n "$NS" rollout status "daemonset/$NODE_DS" --timeout=20m
预期输出
deployment "<CSI_CONTROLLER_DEPLOYMENT>" successfully rolled out
daemon set "<CSI_NODE_DAEMONSET>" successfully rolled out
若出现超时,应先查看对应 Pod 的 readiness、事件和容器日志,确认是镜像拉取、RBAC、注册、leader election 还是 CSI RPC 问题,再决定回退;不要继续升级下一批节点。
单独处理 CRD 与对象变化
CRD 不是 Deployment rollout 的附属品。Snapshot 生态尤其需要把 snapshot controller、CSI snapshotter 与 Snapshot/VolumeGroupSnapshot API 一起核对;官方发布说明会明确最低 Kubernetes 版本以及 API/CRD 迁移要求,说明这类变化不能仅靠回退容器镜像处理。:contentReference[oaicite:5]{index=5}
升级前先盘点集群里实际安装和正在使用的存储 CRD:
kubectl get crd | grep -E 'snapshot|volumeattributes' || true
kubectl get volumesnapshotclasses.snapshot.storage.k8s.io 2>/dev/null || true
kubectl get volumesnapshots.snapshot.storage.k8s.io -A 2>/dev/null || true
预期输出
<CRD_NAME>   <TIME>
...
NAME                 DRIVER       DELETIONPOLICY   AGE
<SNAPSHOT_CLASS>     <DRIVER>     <POLICY>         <AGE>
NAMESPACE   NAME       READYTOUSE   SOURCEPVC   AGE
<NS>        <SNAPSHOT> true         <PVC>       <AGE>
如果集群未启用快照能力,后两条命令可能没有输出。真正升级 CRD 时应以目标版本发行说明为准,先确认 served/storage version、转换策略与现有对象是否兼容;不要用“镜像升级成功”推断 CRD 已经安全迁移。
用真实卷做验收并划清回滚边界
Controller 与 Node rollout 都成功后,还需要一条端到端烟测覆盖 CreateVolume → 调度 → NodePublishVolume → 读写。下面的清单使用一个临时 PVC 和 Pod;将 <STORAGE_CLASS> 替换为要验证的 StorageClass 后保存为 <PATH>/csi-smoke.yaml。
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: csi-upgrade-smoke
spec:
  accessModes:
    - ReadWriteOnce
  storageClassName: <STORAGE_CLASS>
  resources:
    requests:
      storage: 1Gi
---
apiVersion: v1
kind: Pod
metadata:
  name: csi-upgrade-smoke
spec:
  containers:
    - name: test
      image: busybox:1.36
      command: ["sh", "-c", "echo ok >/data/probe && sleep 3600"]
      volumeMounts:
        - name: data
          mountPath: /data
  volumes:
    - name: data
      persistentVolumeClaim:
        claimName: csi-upgrade-smoke
该配置生效后应触发动态供给并把 PVC 挂载到 Pod。用下面的命令完成创建、就绪与读写验证。
kubectl apply -f "<PATH>/csi-smoke.yaml"
kubectl wait --for=condition=Ready pod/csi-upgrade-smoke --timeout=5m
kubectl exec csi-upgrade-smoke -- cat /data/probe
kubectl delete -f "<PATH>/csi-smoke.yaml"
预期输出
persistentvolumeclaim/csi-upgrade-smoke created
pod/csi-upgrade-smoke created
pod/csi-upgrade-smoke condition met
ok
pod "csi-upgrade-smoke" deleted
persistentvolumeclaim "csi-upgrade-smoke" deleted
最后再判断是否真的具备“回滚”能力:如果变更只涉及镜像和 PodTemplate,且旧版本仍能理解当前对象与后端状态,通常可以回退工作负载;一旦升级已经迁移 CRD storage version、写入旧组件不认识的新对象语义,或驱动对后端元数据做了不可逆变更,就不能把 rollout undo 当成完整回滚方案。升级计划必须在开始前明确这个边界,而不是失败后才寻找旧镜像。